同时服务多位用户:连续批处理如何保持 LLM 推理高效
连续批处理通过动态调度与 ragged batching 解决静态批处理中因填充导致的 GPU 空闲问题,使 LLM 推理在多用户场景下更高效;实测显示其可将吞吐量提升 2–3 倍,同时减少平均延迟。
入选理由:静态批处理因固定长度填充导致短请求空等,最长请求决定整批完成时间,GPU 利用率常低于 60%
公司
别名:MLM
技术博客平台,发布Python教程
已跟踪 25 条高相关材料
最近变化
2026-10-16 · 使用生成器表达式替代列表推导可减少内存占用80%
为什么值得关注
Machine Learning Mastery 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Serving Multiple Users at Once: How Continuous Batching Keeps LLM Inference Efficient
Machine Learning Mastery · 8.7 分
连续批处理(Continuous Batching)通过动态调度和 ragged batching 解决静态批处理中因填充导致的 GPU 空闲问题,使 LLM 推理在多用户场景下更高效;实测显示其可将吞吐量提升 2–3 倍,同时减少平均延迟。
Iterators and Generators for Memory-Efficient Processing
Machine Learning Mastery · 8.5 分
Python迭代器和生成器能通过惰性求值处理9GB大文件,避免内存溢出。文章用日志处理案例揭示列表导致内存爆炸的原理,并提供tracemalloc验证内存效率的方法。
Synchronous vs. Asynchronous Agent Execution: Architecture Patterns for Production
Machine Learning Mastery · 8.5 分
同步和异步代理执行模式各有优劣,选择需基于任务复杂度、延迟容忍度和基础设施需求,异步模式更适合长流程任务。
已收录 25 条与 Machine Learning Mastery 相关的内容,按评分排序。
连续批处理通过动态调度与 ragged batching 解决静态批处理中因填充导致的 GPU 空闲问题,使 LLM 推理在多用户场景下更高效;实测显示其可将吞吐量提升 2–3 倍,同时减少平均延迟。
入选理由:静态批处理因固定长度填充导致短请求空等,最长请求决定整批完成时间,GPU 利用率常低于 60%
Python迭代器和生成器能通过惰性求值处理9GB大文件,避免内存溢出。文章用日志处理案例揭示列表导致内存爆炸的原理,并提供tracemalloc验证内存效率的方法。
入选理由:使用生成器表达式替代列表推导可减少内存占用80%
同步和异步代理执行模式各有优劣,选择需基于任务复杂度、延迟容忍度和基础设施需求,异步模式更适合长流程任务。
入选理由:同步模式受AWS API Gateway 29秒超时限制,复杂任务易导致连接中断。
语音代理包含STT、语言处理和TTS三阶段,其设计需解决延迟和复合错误问题,提供七阶段学习路径。
入选理由:语音代理需处理STT/TTS转换,增加系统延迟约束
本文通过10个步骤用Python和NumPy从零构建向量数据库,详解向量编码、相似性搜索和近似索引原理。
入选理由:使用sentence-transformers库将文档编码为固定长度向量
多智能体系统在特定条件下值得采用,但需权衡其复杂性与成本,单智能体系统在多数场景下更高效。
入选理由:多智能体系统需满足4个条件才值得采用:复杂协调、高可靠性需求、资源隔离、扩展性需求。
Python的dataclass装饰器能替代脆弱的配置字典,提供结构化、可维护的数据模型,提升代码可靠性。
入选理由:使用@dataclass可自动生成__init__和__repr__方法,减少重复代码
NumPy向量化操作可替代Python循环,利用C后端实现数值计算加速,提升效率达百倍以上。
入选理由:Python动态类型导致循环效率低,NumPy的C后端避免了这种开销
自主代理系统中token成本因上下文累积呈非线性增长,需通过架构设计控制。五种失败模式导致成本失控,包含具体缓解方案。
入选理由:token成本在多步骤代理流程中呈O(N²)增长,需区分状态与上下文
在自主AI系统中,检索和记忆是两种关键机制,分别处理外部知识和内部学习信息,有效结合两者能提升系统性能。
入选理由:检索处理外部知识(如文档/代码),记忆存储代理自身生成的信息(如历史决策)
生产级代理AI系统依赖七个关键组件构成闭环反馈循环,确保系统稳定性与扩展性。
入选理由:生产系统需包含感知、记忆、推理等7个独立组件,而非简单脚本
Transformer模型推理需通过自回归生成和键值缓存优化性能,PyTorch实现细节揭示训练与推理的核心差异。
入选理由:自回归生成需逐个生成token,依赖前序所有输出
Transformer推理性能需通过延迟、吞吐量等指标衡量,需关注首token时间、内存使用及多GPU优化。
入选理由:首token时间(TTFT)和每输出token时间(TPOT)是衡量用户感知延迟的关键指标。
2026年代理AI架构已转向原生推理模型、多代理群体和MCP协议标准化,工程师需重构设计思路。
入选理由:原生推理模型减少复杂外部协调框架需求,降低延迟和token开销。
状态化与无状态代理设计在可扩展系统中各有优劣,选择需权衡可扩展性、成本和复杂性。文章通过Groq API实现案例对比两种架构差异。
入选理由:无状态代理依赖客户端维护对话历史,适合高并发场景但缺乏上下文连续性
AI代理工具选择影响准确性,六种技术(检索、路由等)可提升效率,RAG-MCP研究显示准确率提升至43.13%。
入选理由:工具数量超过10-15个时,AI代理准确性显著下降
上下文窗口不等于记忆,AI代理开发者需理解其区别及如何通过检索、压缩和摘要实现真正的记忆持久性。
入选理由:上下文窗口是无状态的,每次API调用都从零开始。
评估AI代理应关注其完整执行过程,而非仅最终输出,以提高可靠性与效率。
入选理由:AI代理评估应包括推理层和行动层,分别检查规划与工具调用准确性。
AI代理工具设计是影响其可靠性的关键因素,清晰的工具设计能显著减少失败率。
入选理由:一个工具应只负责一个明确的操作,避免多行为工具。
AI工程师必须掌握Python的生成器、上下文管理器、异步编程等核心概念,以构建高效、可扩展的AI系统。
入选理由:生成器和惰性求值可实现大规模数据流处理,内存使用保持恒定。
LLMOps 是构建生产级大语言模型系统的工程实践,涵盖可观测性、评估、成本控制和代理编排,其核心在于将 LLM 系统视为可版本化、可监控、可迭代的软件系统。
入选理由:LLMOps 强调对提示词(prompt)进行版本控制,而非模型权重,因为提示词变更频繁且直接影响输出质量。
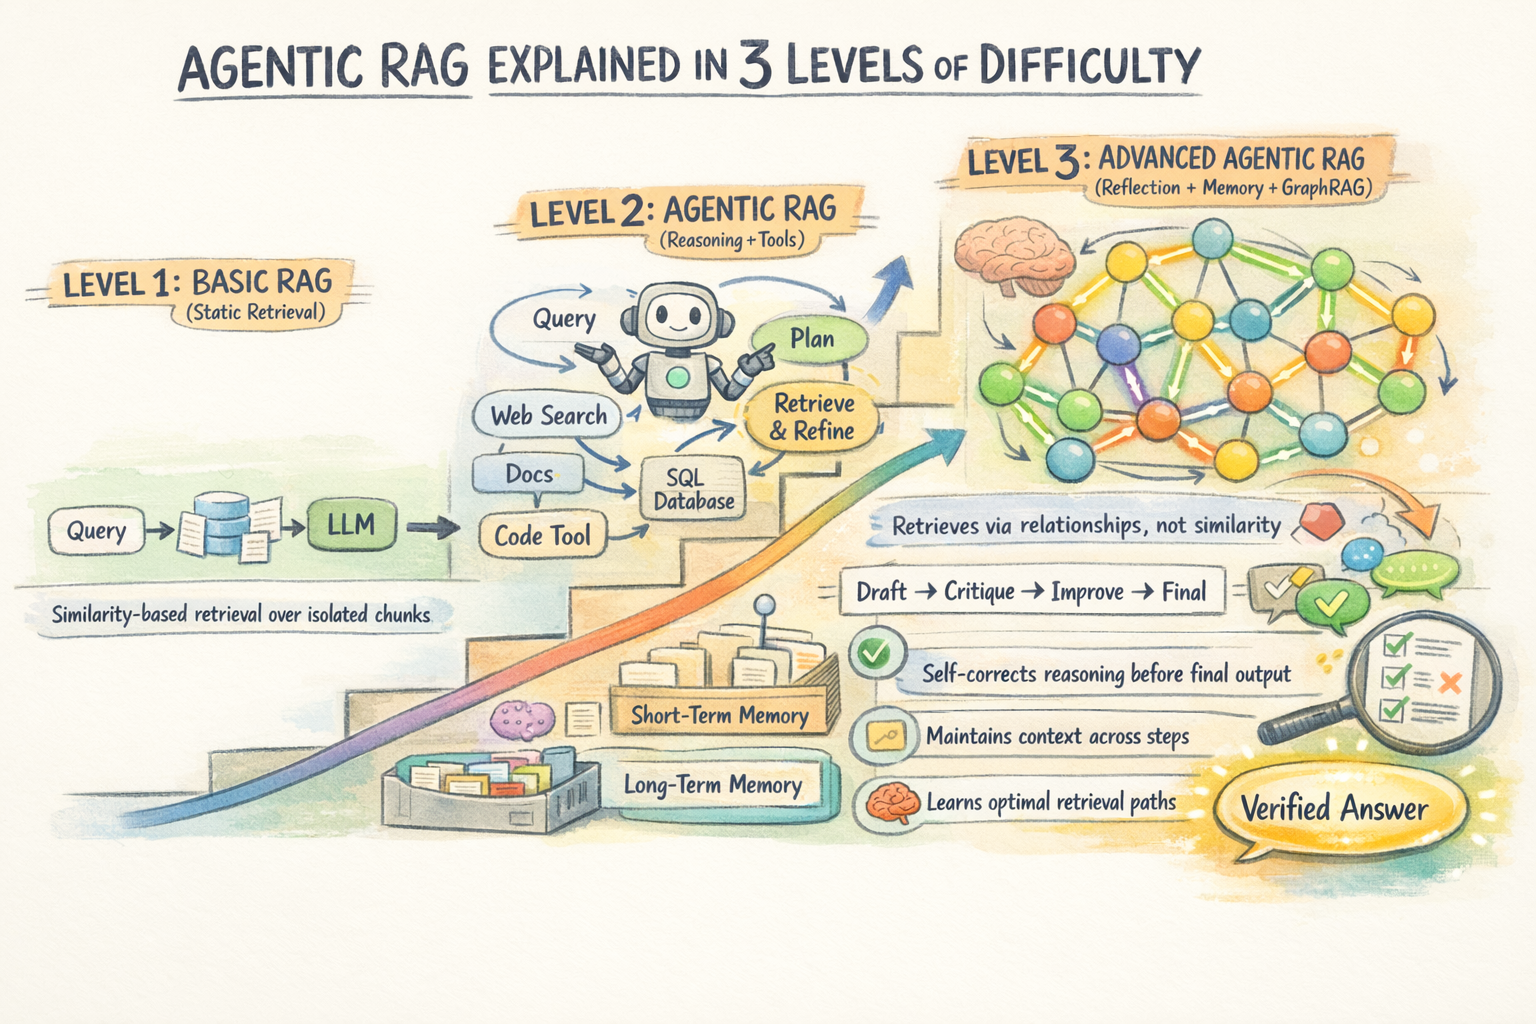
文章解析Agentic RAG的三个难度层级,对比传统RAG的局限性,介绍代理机制如何提升信息检索和生成能力。
入选理由:传统RAG无法处理多源信息整合
Agentic programming 是将 AI 模型作为自主决策引擎嵌入软件系统的核心范式,区别于传统 chatbot 的响应式交互;当前企业落地率仅 11%,主因是工程能力与架构设计缺失,而非需求不足。
入选理由:79% 企业已采用 AI agent,但仅 11% 上线生产环境(Svitla 2026 数据)。
文章提出通过提示压缩技术降低代理循环成本,提供具体实现方法和实验数据支持。
入选理由:提示压缩可减少代理循环成本30%
文章介绍了如何在Python代理系统中实现权限控制的工具调用机制,提供具体代码示例和安全策略。
入选理由:使用装饰器实现权限验证,确保工具调用前进行身份检查