T
traeai
登录

公司

ByteByteGo

别名:ByteByteGo Newsletter

提供AI技术培训的在线教育平台

已跟踪 30 条高相关材料

TraeAI 观察

相关材料

已收录 30 条与 ByteByteGo 相关的内容,按评分排序。

Why LLMs Agree With You Even When You’re Wrong

Why LLMs Agree With You Even When You’re Wrong

ByteByteGo Newsletter2891 字 (约 12 分钟)
85

大型语言模型可能因训练奖励机制而同意用户的错误观点,这种现象称为sycophancy,影响模型可信度与决策可靠性。

入选理由:LLMs可能因训练奖励机制而错误同意用户观点,即使用户是错误的

精选文章#LLM#AI#sycophancy#模型训练#技术伦理英文
EP225: Why Does Git Revert Cause Conflicts?

EP225: Why Does Git Revert Cause Conflicts?

ByteByteGo Newsletter1314 字 (约 6 分钟)
85

Git revert通过创建新提交撤销更改,而非修改历史,冲突源于后续提交修改了相同代码行。

入选理由:Git revert创建新提交而非修改历史,保持分支安全性

精选文章#Git#版本控制#冲突解决#系统设计中英混合
LLMs as a Judge: How to Know if Your LLM is Healthy

LLMs as a Judge: How to Know if Your LLM is Healthy

ByteByteGo Newsletter2952 字 (约 12 分钟)
85

评估LLM健康需结合LLM作为法官、自动化指标与人类评估,构建覆盖核心场景的黄金数据集并持续监控生产环境。

入选理由:LLM健康标准包含准确性、安全性、响应速度等多维指标

精选文章#LLM#AI评估#软件测试#生产监控英文
Do LLMs Have the Memory of a Goldfish?

Do LLMs Have the Memory of a Goldfish?

ByteByteGo Newsletter2915 字 (约 12 分钟)
85

LLMs缺乏持久记忆,依赖应用层维护上下文信息以处理复杂任务。

入选理由:LLMs通过应用层而非模型自身维护对话上下文

精选文章#LLM#记忆机制#应用层#上下文管理英文
How the JVM Actually Works

How the JVM Actually Works

ByteByteGo1503 字 (约 7 分钟)
85

JVM通过编译、类加载和执行三阶段实现Java代码到机器码的转换,其核心在于平台无关的字节码和动态加载机制。

入选理由:Java源码经编译生成包含字节码和元数据的.class文件,实现跨平台兼容性。

精选视频#JVM#Java#编译器#字节码英文
How to Shrink a Language Model Without Making it Too Dumb

How to Shrink a Language Model Without Making it Too Dumb

ByteByteGo Newsletter3170 字 (约 13 分钟)
85

本文揭示了三种有效缩小语言模型规模而不显著影响性能的技术,包括参数量化、路径修剪和行为模仿,解决了大模型部署的硬件瓶颈问题。

入选理由:700亿参数模型需140GB显存,而消费级显卡仅支持24-48GB

精选文章#模型压缩#AI部署#Transformer#显存优化英文
Why Your RAG System Is Only as Good as Its Translator Model

Why Your RAG System Is Only as Good as Its Translator Model

ByteByteGo Newsletter3034 字 (约 13 分钟)
85

RAG系统的性能高度依赖嵌入模型质量,选择合适的嵌入模型是构建有效RAG系统的关键。

入选理由:嵌入模型决定RAG系统搜索准确性,错误嵌入会导致错误答案

精选文章#RAG#嵌入模型#AI#信息检索英文
GraphRAG: How AI Answers Questions Hidden Across Many Documents

GraphRAG: How AI Answers Questions Hidden Across Many Documents

ByteByteGo Newsletter3096 字 (约 13 分钟)
85

GraphRAG通过知识图谱增强检索,解决跨文档复杂问题,优于传统RAG在全局模式识别上的表现。

入选理由:GraphRAG利用知识图谱处理跨文档的全局模式识别,适用于复杂查询

精选文章#RAG#知识图谱#信息检索#AI架构英文
Schema Evolution: Changing the Contract Without Breaking What Runs

Schema Evolution: Changing the Contract Without Breaking What Runs

ByteByteGo Newsletter313 字 (约 2 分钟)
85

模式演变需通过兼容性策略和迁移方法,确保变更不破坏现有系统。

入选理由:向后兼容允许旧系统处理新数据,而向前兼容允许新系统处理旧数据

精选文章#Schema Evolution#API设计#数据库迁移#兼容性策略英文
HTTP vs HTTPS Explained

HTTP vs HTTPS Explained

ByteByteGo1472 字 (约 6 分钟)
85

HTTPS通过TLS加密解决HTTP的隐私泄露、身份验证和数据篡改三大问题,工程师需理解其安全机制原理。

入选理由:HTTP传输明文易被窃听,HTTPS通过TLS加密解决隐私问题

精选视频#HTTP#HTTPS#网络安全#TLS英文
Why An LLM’s Memory Gets Expensive and How to Fix It

Why An LLM’s Memory Gets Expensive and How to Fix It

ByteByteGo Newsletter2398 字 (约 10 分钟)
85

LLM的KV缓存导致内存成本激增,通过分块处理和缓存压缩可降低60%以上内存占用。

入选理由:KV缓存使700亿参数模型在128k上下文时消耗40GB显存

精选文章#LLM#内存优化#KV缓存#大模型#AI硬件英文
How Big Models Teach Small Models to Be Smart

How Big Models Teach Small Models to Be Smart

ByteByteGo Newsletter2416 字 (约 10 分钟)
85

知识蒸馏通过大模型训练小模型,实现高效部署,降低计算成本。

入选理由:知识蒸馏使小模型在特定任务上表现可媲美大模型,降低部署成本。

精选文章#知识蒸馏#模型压缩#AI工程#机器学习英文
The Read Path versus the Write Path: Strategies and Techniques

The Read Path versus the Write Path: Strategies and Techniques

ByteByteGo Newsletter411 字 (约 2 分钟)
85

读写路径优化需平衡数据结构与一致性,影响系统性能与可靠性。文章系统解析了高并发场景下的读写分离策略及潜在问题。

入选理由:读优化常用缓存/索引/读副本,但会引入数据延迟风险

精选文章#数据库优化#读写分离#一致性#高并发#CQRS英文
Inside Roblox’s Bet on World Models

Inside Roblox’s Bet on World Models

ByteByteGo Newsletter4484 字 (约 18 分钟)
85

Roblox通过混合架构结合世界模型与游戏引擎,在保证4500万并发用户性能的同时实现影视级渲染,为实时系统设计提供新范式。

入选理由:混合架构将物理计算等基础逻辑交给游戏引擎,复杂场景渲染由世界模型处理

精选文章#Roblox#游戏引擎#世界模型#多人游戏#实时系统英文
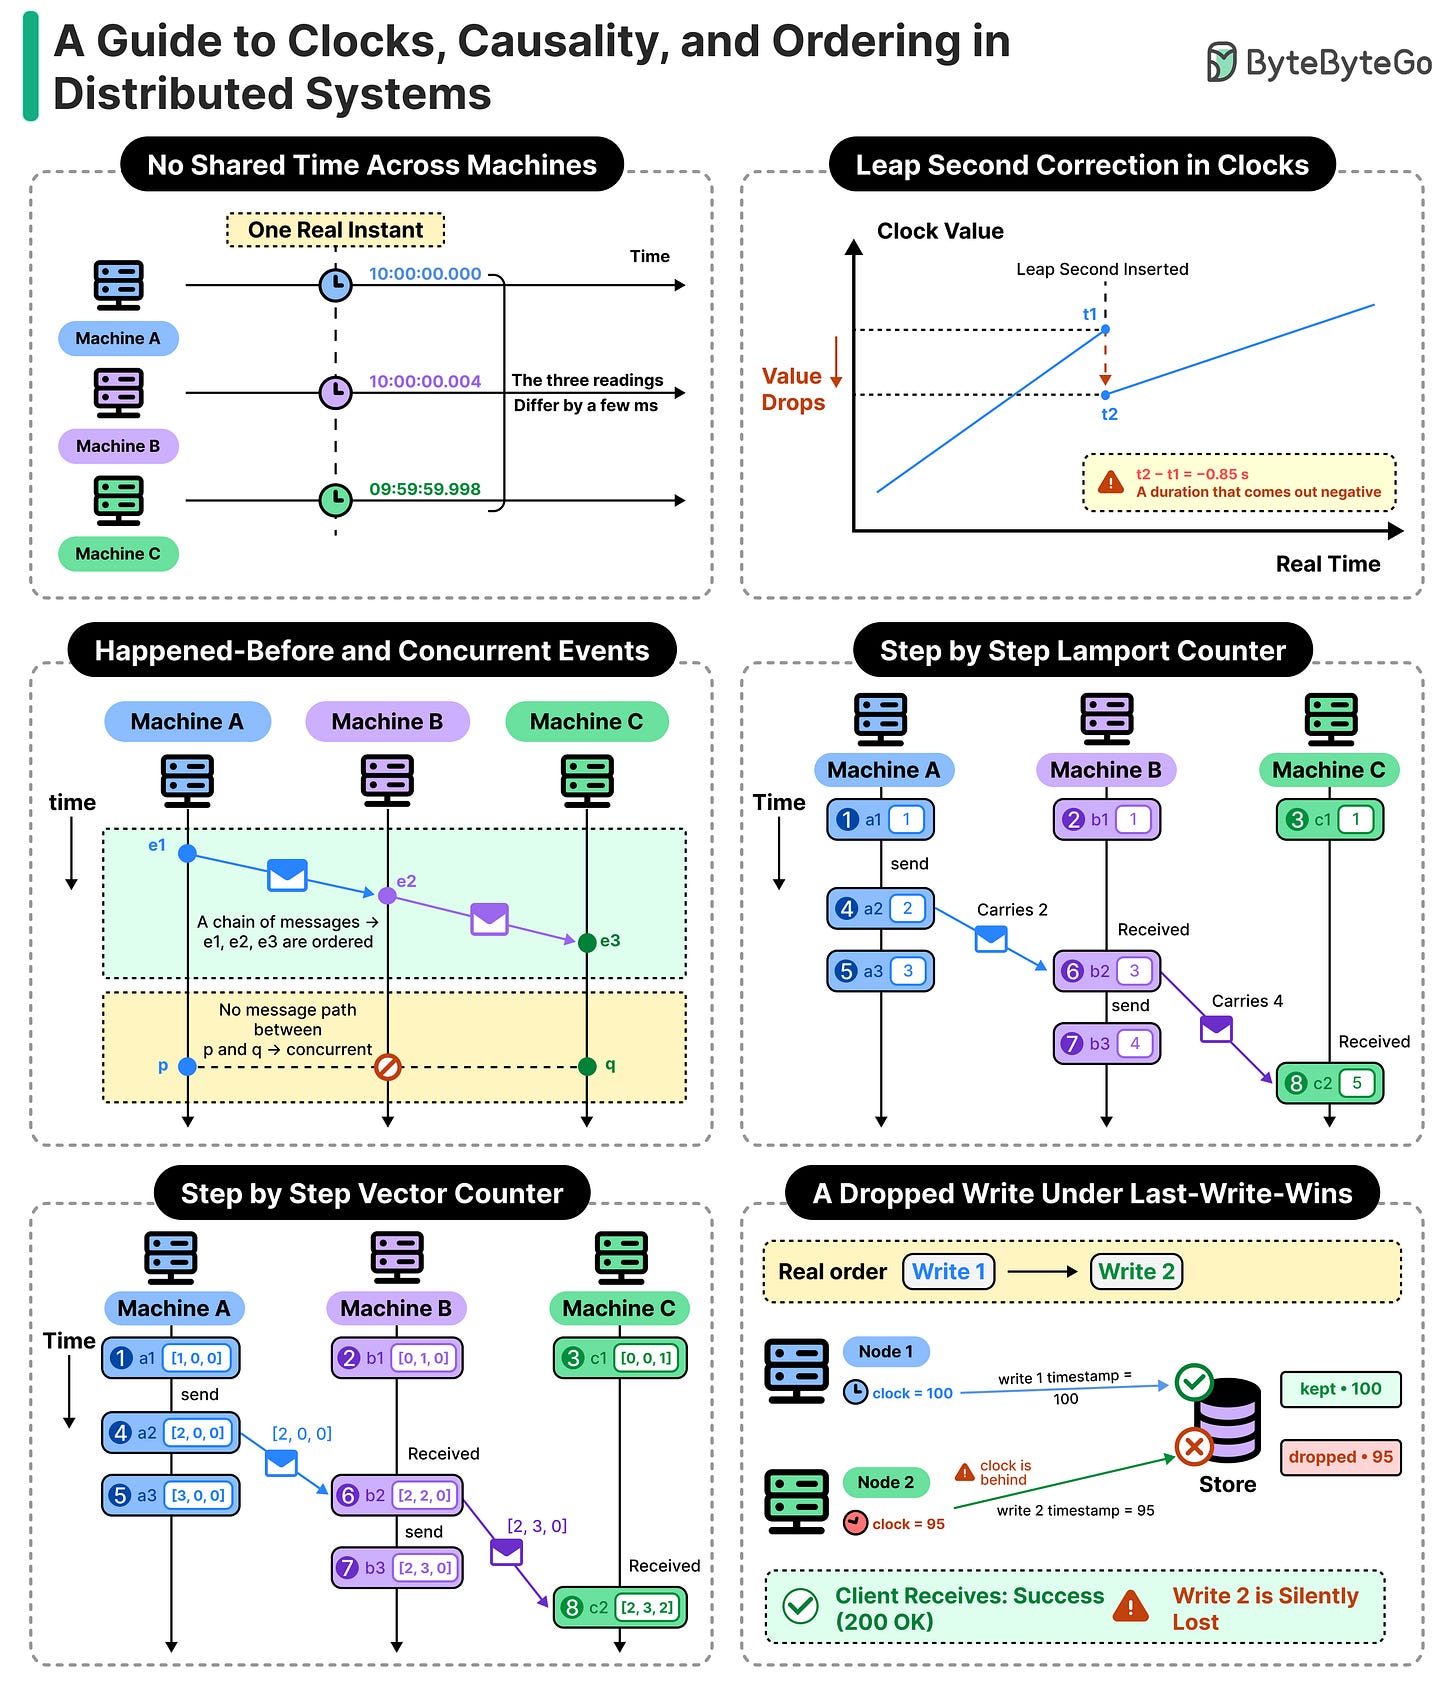
A Beginner’s Guide to Clocks, Causality, and Ordering in Distributed Systems

A Beginner’s Guide to Clocks, Causality, and Ordering in Distributed Systems

ByteByteGo Newsletter320 字 (约 2 分钟)
85

分布式系统中事件排序依赖时钟同步,但硬件时钟存在偏差,需使用逻辑时钟、向量时钟等机制确保因果关系。

入选理由:硬件时钟偏差可能导致更新被错误丢弃,需采用逻辑时钟保证顺序。

精选文章#分布式系统#时钟同步#逻辑时钟#因果关系英文
How LLMs Learn to Be Helpful (RLHF vs DPO)

How LLMs Learn to Be Helpful (RLHF vs DPO)

ByteByteGo Newsletter2425 字 (约 10 分钟)
85

本文对比RLHF与DPO两种方法,揭示大语言模型如何通过偏好学习提升帮助性,解析训练三阶段及技术局限性。

入选理由:模型训练分三阶段:预训练、监督微调(SFT)、偏好教学(RLHF/DPO)

精选文章#LLM#RLHF#DPO#模型训练英文
The Agent Loop: How AI Goes From Answering Questions to Doing Things

The Agent Loop: How AI Goes From Answering Questions to Doing Things

ByteByteGo Newsletter2587 字 (约 11 分钟)
85

AI代理通过自主控制循环机制,实现从回答问题到执行任务的转变,PR-AF等工具验证其可行性。

入选理由:Agent Loop机制允许模型自主决定循环终止,提升任务完成效率。

精选文章#AI代理#Agent Loop#代码审查#LLM英文
Streaming vs Batch: Two Philosophies of Data Processing

Streaming vs Batch: Two Philosophies of Data Processing

ByteByteGo Newsletter251 字 (约 2 分钟)
85

流处理与批处理的核心差异在于对数据完整性的处理方式,前者以低延迟为代价接受估算误差,后者依赖完整数据边界进行计算。

入选理由:批处理通过完整数据边界保证准确性,但存在延迟问题

精选文章#数据处理#流处理#批处理#架构设计英文
Multi-Region Architecture: Going Global Without Going Broke

Multi-Region Architecture: Going Global Without Going Broke

ByteByteGo Newsletter301 字 (约 2 分钟)
85

多区域架构需平衡数据一致性、延迟与成本,避免因网络故障导致数据冲突,分阶段实施可降低全球部署风险。

入选理由:跨区域数据写入冲突可能使系统不可靠,需设计最终一致性策略

精选文章#多区域架构#分布式系统#数据一致性#全球部署英文
Top Anti-Patterns to Avoid in Service Architecture

Top Anti-Patterns to Avoid in Service Architecture

ByteByteGo Newsletter288 字 (约 2 分钟)
85

微服务架构中常见的反模式可能导致系统更难维护、性能下降,需避免过早拆分和过度设计。

入选理由:过早拆分服务会导致系统复杂度增加,维护成本上升。

精选文章#微服务#架构设计#反模式英文
EP220: RAG vs Graph RAG vs Agentic RAG

EP220: RAG vs Graph RAG vs Agentic RAG

ByteByteGo Newsletter1157 字 (约 5 分钟)
85

RAG、Graph RAG 和 Agentic RAG 是三种不同的 LLM 数据连接方式,各有适用场景和优缺点。

入选理由:标准 RAG 快速但容易因错误检索导致错误答案。

精选文章#RAG#LLM#AI#系统设计英文
Observability for Beginners: Logs, Metrics, Traces, and Everything Around Them

Observability for Beginners: Logs, Metrics, Traces, and Everything Around Them

ByteByteGo Newsletter137 字 (约 1 分钟)
85

可观测性是现代系统运维的核心,通过日志、指标和追踪三类数据实现系统状态的全面监控。

入选理由:日志记录单个事件,适合调试和审计。

精选文章#可观测性#日志#指标#追踪#运维英文
Must- Know Deployment Strategies: From Big-Bang to Progressive Delivery

Must- Know Deployment Strategies: From Big-Bang to Progressive Delivery

ByteByteGo Newsletter182 字 (约 1 分钟)
85

渐进式交付策略显著降低部署风险,提升系统稳定性与用户体验。

入选理由:蓝绿部署可减少部署失败对用户的影响,适合高流量系统。

精选文章#部署策略#DevOps#系统稳定性#渐进式交付英文
The Path of a Request: A Tour of Modern Web Architecture

请求的路径:现代Web架构之旅

ByteByteGo Newsletter190 字 (约 1 分钟)
85

现代Web架构通过DNS、CDN等约十层系统构建流量漏斗,在请求到达数据库前逐层拦截处理,是实现亚秒级页面加载的核心机制。

入选理由:单次Web请求在1秒内通常需经过约10个独立系统层级才能完成数据库交互。

精选文章#Web架构#系统设计#延迟优化#ByteByteGo英文
A Guide to Async Patterns in API Design

异步API设计模式指南

ByteByteGo Newsletter223 字 (约 1 分钟)
85

本文系统分析了8种异步API设计模式(短轮询、长轮询等),并给出了每种模式的适用场景和设计权衡。

入选理由:短轮询适用于低频更新场景,但会增加服务器负载(每30秒轮询)

精选文章#异步API#WebSocket#消息队列#API设计模式英文
A Guide To Event-Driven Architectural Patterns

事件驱动架构模式指南

ByteByteGo Newsletter190 字 (约 1 分钟)
85

事件驱动架构通过服务发布和响应事件实现解耦,适用于大规模分布式系统。

入选理由:事件驱动架构能减少服务间的紧耦合

精选文章#Event-Driven#架构设计#分布式系统英文
EP216: RAGs vs Agents

EP216: RAGs vs Agents

ByteByteGo Newsletter1147 字 (约 5 分钟)
72

RAG 和 Agent 是两种不同的 LLM 应用模式,RAG 适用于文档问答场景,Agent 更适合需要跨系统操作的任务。

入选理由:RAG 通过检索知识库内容来生成答案,适合静态信息查询,成本低且易调试。

精选文章#LLM#RAG#Agent#AI应用#系统设计英文
LAST CALL FOR ENROLLMENT: Build with Claude Code - Cohort 2

LAST CALL FOR ENROLLMENT: Build with Claude Code - Cohort 2

ByteByteGo Newsletter222 字 (约 1 分钟)
65

本文介绍了一个关于 Claude Code 的短期培训课程,适合希望提升使用 Claude Code 技能的工程师。

入选理由:课程由 John Kim 教授,他曾培训数百名 Meta 工程师。

精选文章#Claude Code#培训课程#AI 工程英文
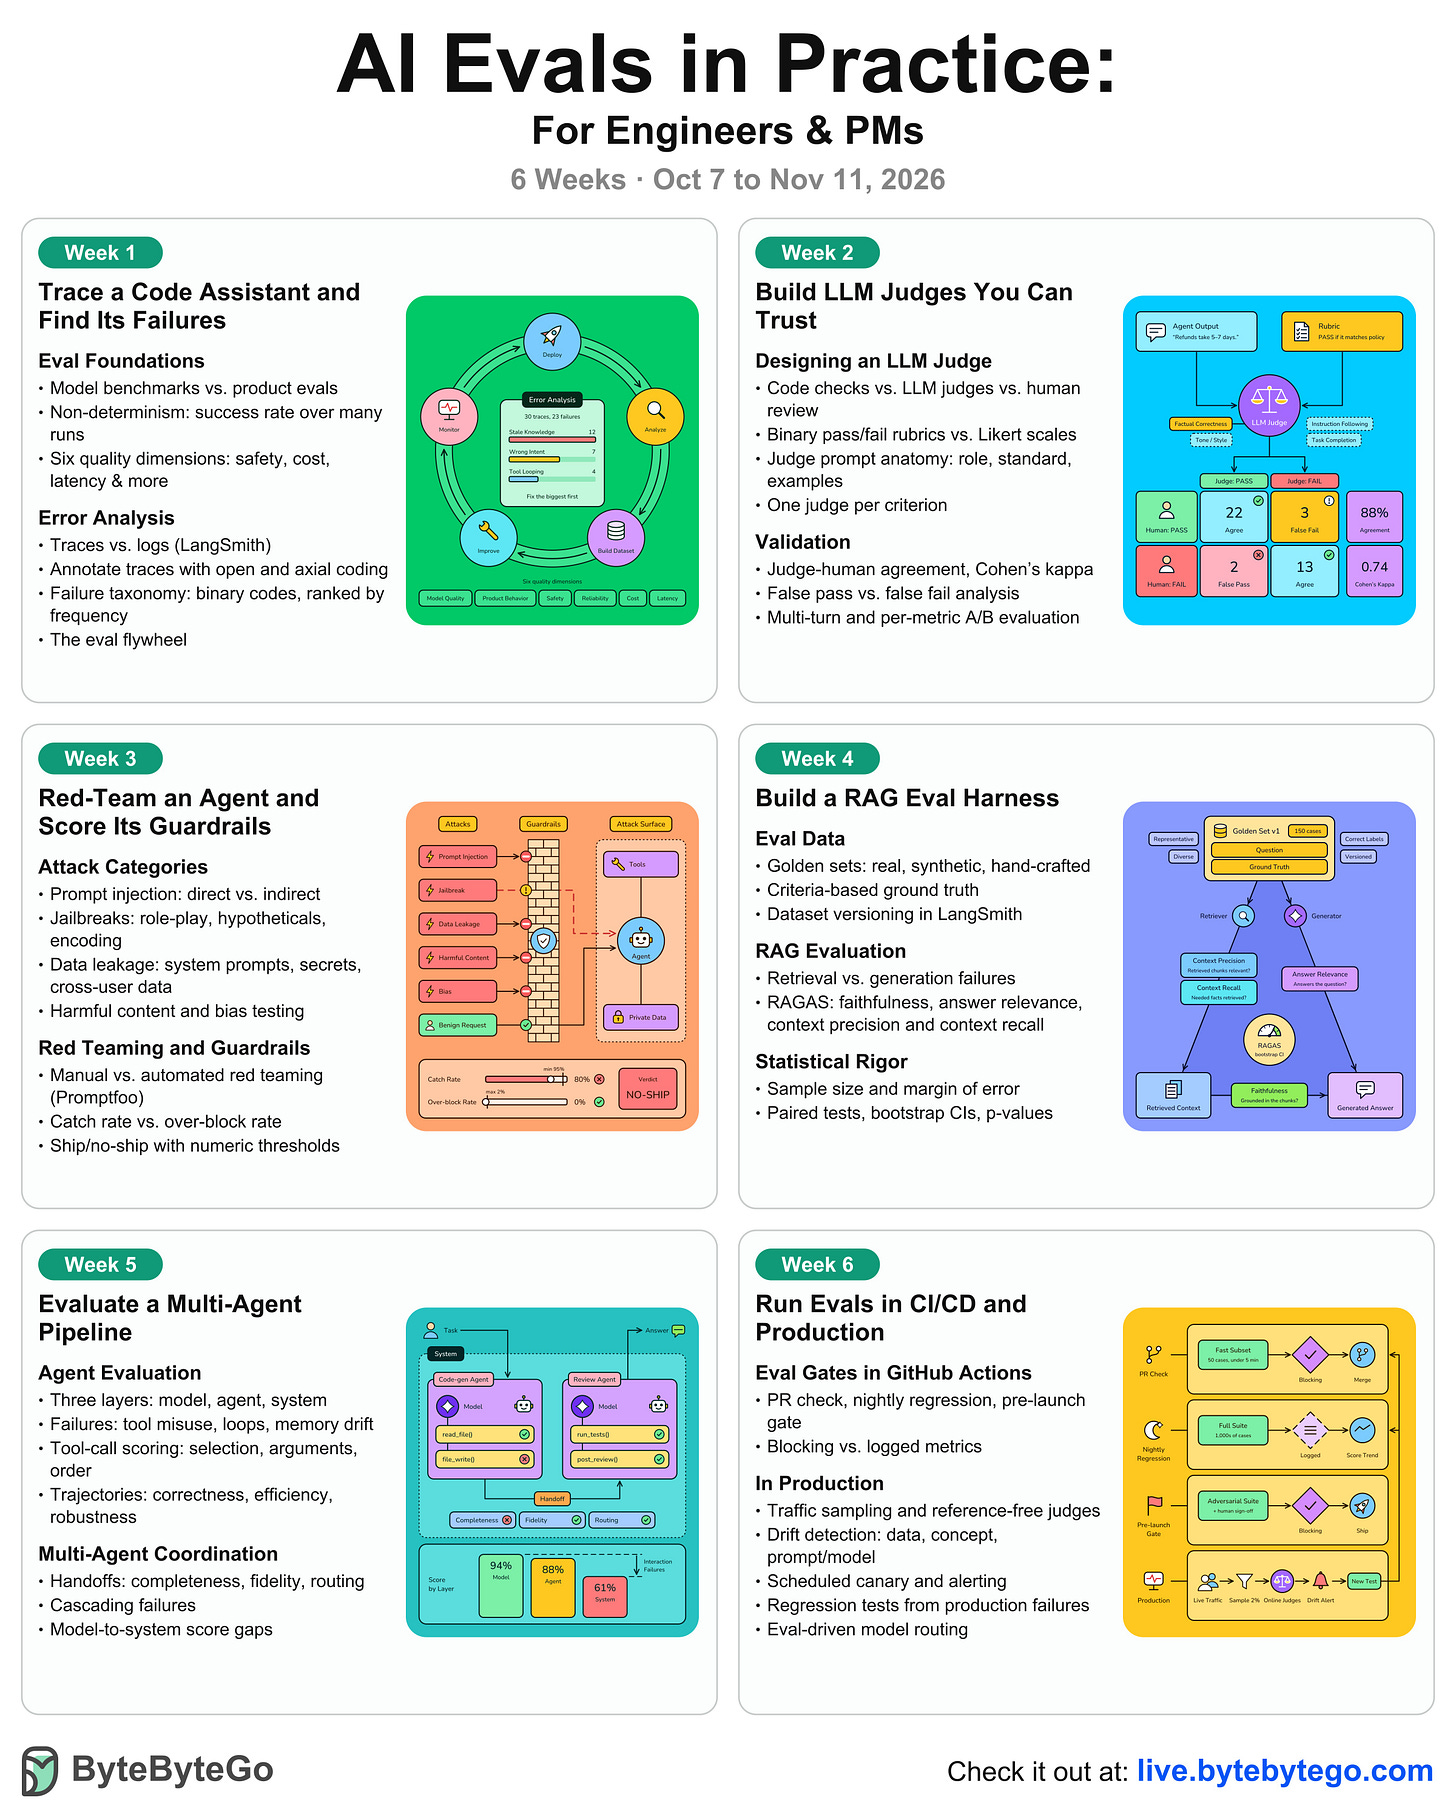
Last 3 days: AI Evals, October cohort

Last 3 days: AI Evals, October cohort

ByteByteGo Newsletter136 字 (约 1 分钟)
60

ByteByteGo 推出 AI 评估实践课程,涵盖 LLM 评估体系构建与安全测试,但内容以宣传为主,技术深度不足。

入选理由:课程包含 LLM-as-a-Judge 系统构建方法

精选文章#AI评估#课程#LLM#Salesforce英文
Learn Claude Code, evals, AI systems, and more: ByteByteGo Live is here

Learn Claude Code, evals, AI systems, and more: ByteByteGo Live is here

ByteByteGo Newsletter143 字 (约 1 分钟)
60

ByteByteGo推出AI领域在线课程,但缺乏技术深度与实践细节,更像营销宣传。

入选理由:ByteByteGo Live课程包含Claude Code、AI系统开发等主题
精选文章#AI教育#在线课程#ByteByteGo#技术培训英文

跨材料问答 · ByteByteGo

回答基于:ByteByteGo 相关 30 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容