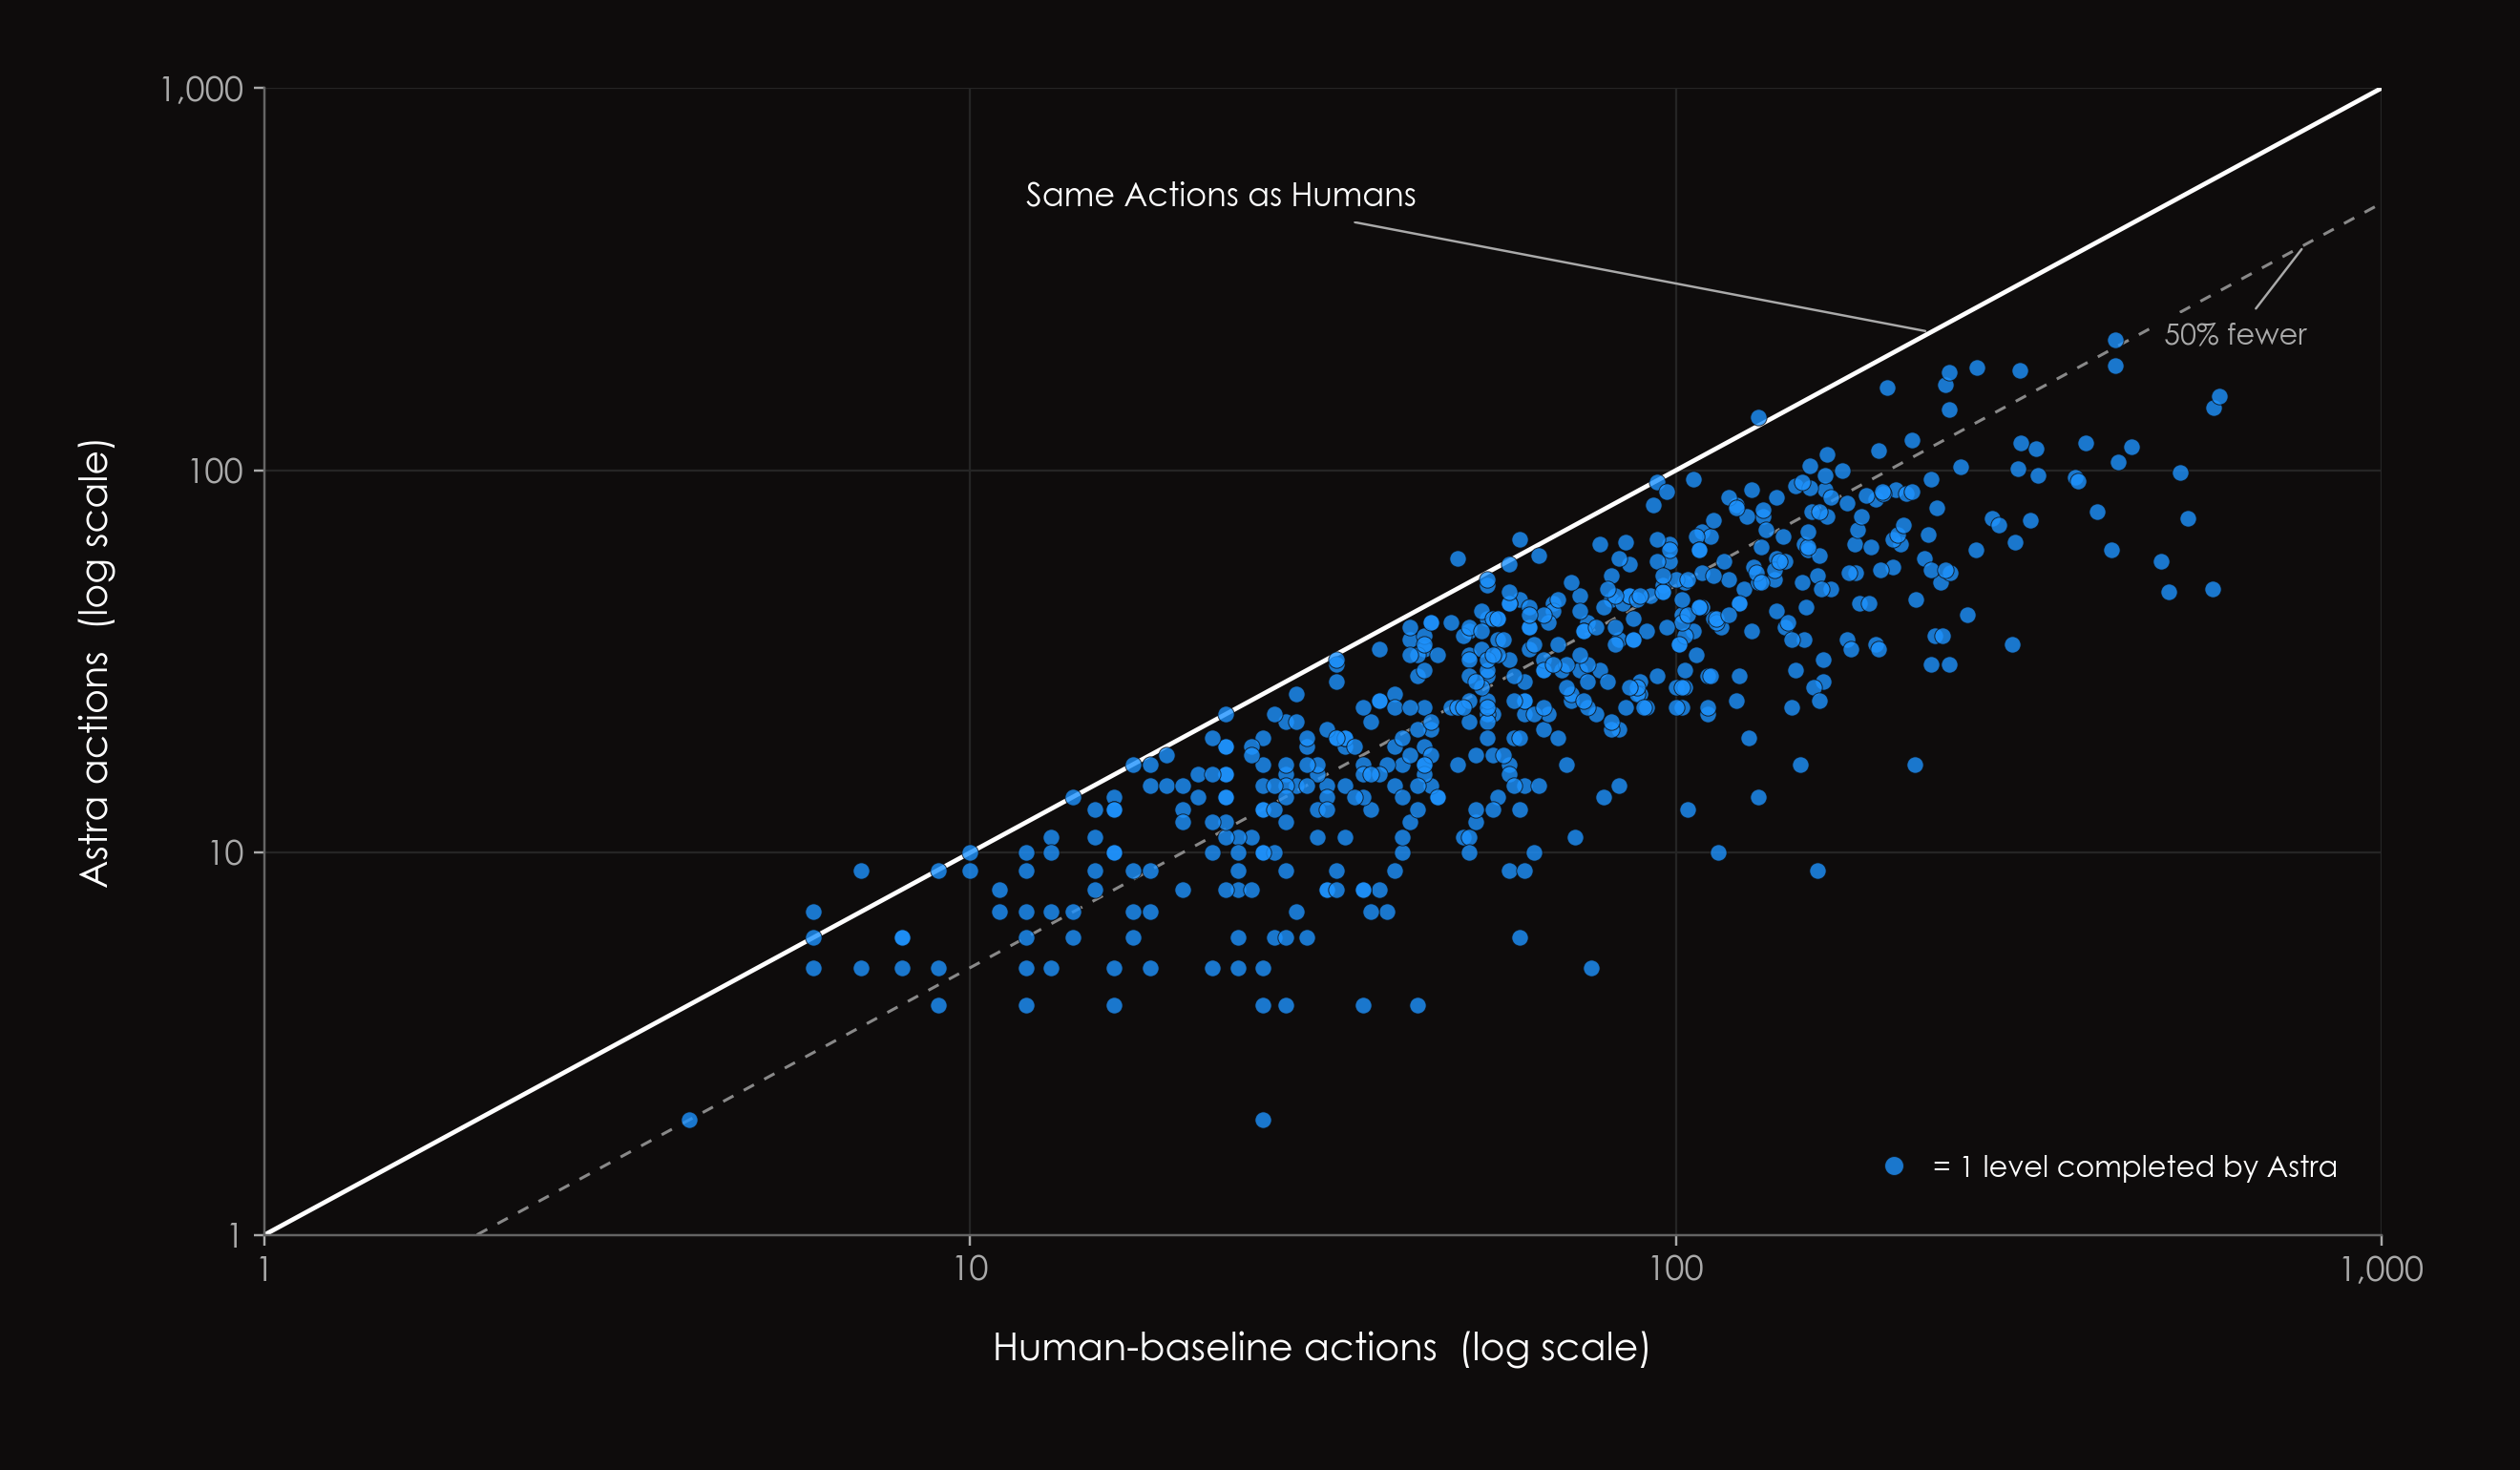
OpenAI's GPT-6 Astra on ARC-AGI-3
ARC Prize2100 字 (约 9 分钟)
85
GPT-6 Astra在ARC-AGI-3基准测试中展现类人级智能,通过特殊Harness实现成本效率优化。
入选理由:GPT-6 Astra在Standard Harness下以$26K成本达成62.7%得分
精选文章#GPT-6#ARC-AGI#AI基准测试#Harness技术#AGI英文
产品
别名:ARC-AGI3
第四代智能代理基准测试系统
已跟踪 22 条高相关材料
最近变化
2026-09-09 · GPT-6 Astra在ARC-AGI-3基准中达到99.9%准确率(GPT-5.6仅7.8%)
为什么值得关注
ARC-AGI-3 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
GPT-6 Astra, Looped Transformers, and Hidden Reasoning
Ahead of AI · 8.5 分
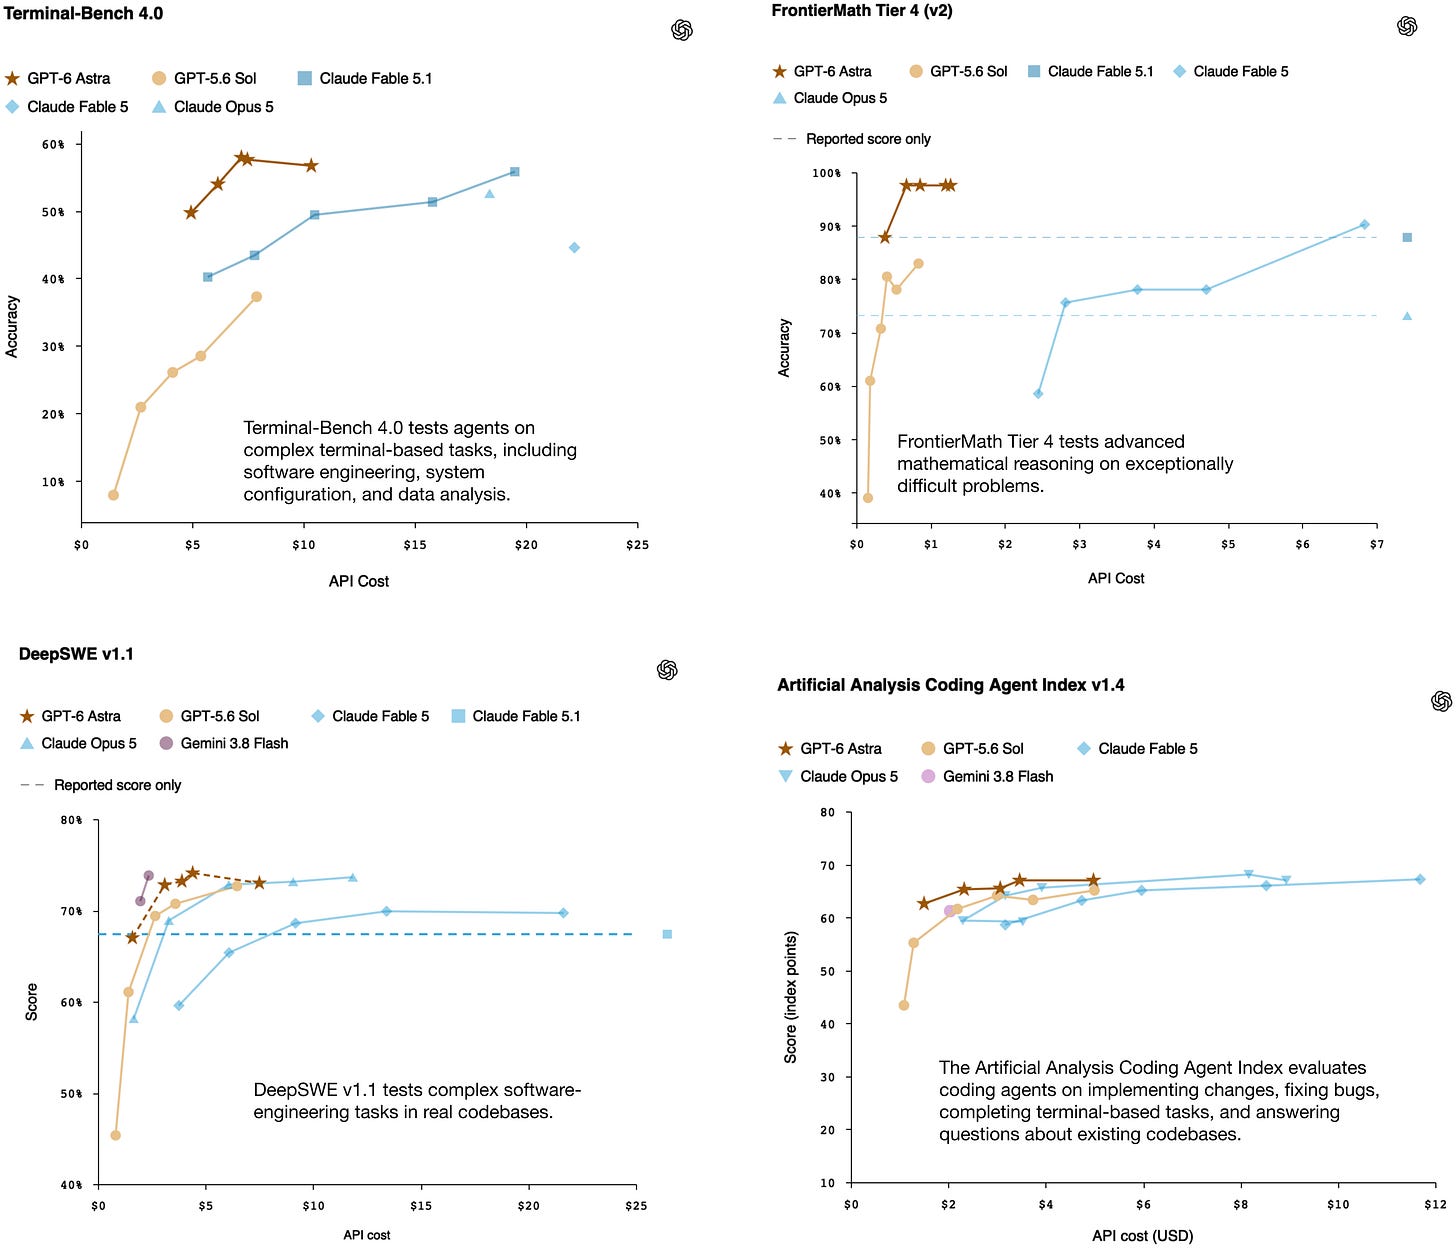
GPT-6 Astra在3D渲染和推理基准中表现卓越,循环变压器架构可能通过隐藏推理链提升模型能力,但技术细节仍需验证。
GPT-6 Astra (Benchmarks Deep-dive): This is not a good coding model anymore? - Worse than Fable?
AICodeKing · 8.5 分
GPT-6 Astra在特定任务上表现卓越,但作为通用AI和编程模型的提升不如宣传的显著。
arc-agi-3 is now saturated
Greg Brockman(@gdb) · 8.5 分
GPT-6 Astra在ARC-AGI-3测试中取得突破性成绩,超越人类表现。
已收录 22 条与 ARC-AGI-3 相关的内容,按评分排序。
GPT-6 Astra在ARC-AGI-3基准测试中展现类人级智能,通过特殊Harness实现成本效率优化。
入选理由:GPT-6 Astra在Standard Harness下以$26K成本达成62.7%得分
GPT-6 Astra在3D渲染和推理基准中表现卓越,循环变压器架构可能通过隐藏推理链提升模型能力,但技术细节仍需验证。
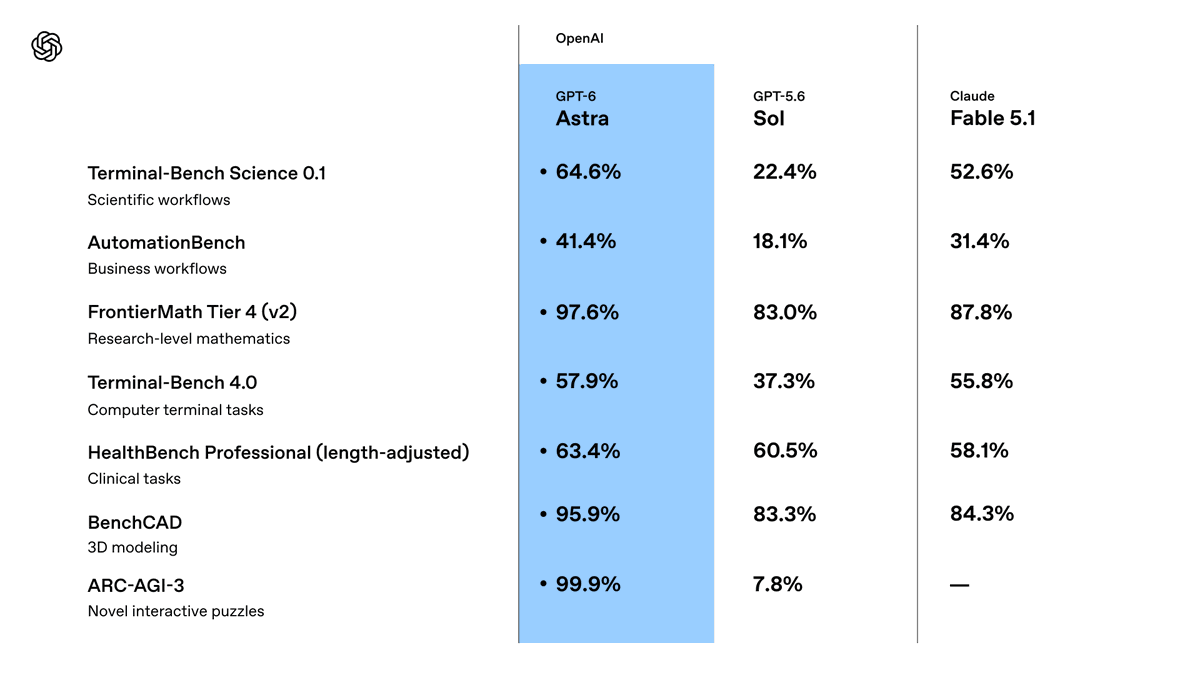
入选理由:GPT-6 Astra在ARC-AGI-3基准中达到99.9%准确率(GPT-5.6仅7.8%)
GPT-6 Astra在特定任务上表现卓越,但作为通用AI和编程模型的提升不如宣传的显著。
入选理由:GPT-6 Astra在ARC-AGI-3基准测试中得分99.9%,远超GPT-5.6和Claude Opus 5。
GPT-6 Astra在ARC-AGI-3测试中取得突破性成绩,超越人类表现。
入选理由:GPT-6 Astra在ARC-AGI-3测试中达到63%准确率,通过新适配器提升至99%
GPT-6 Astra发布,声称在多个基准测试中表现优异,适用于创业、科研和专业工作。
入选理由:GPT-6 Astra在FrontierMath Tier 4测试中得分98%,ARC-AGI 3测试中得分99.9%
前沿AI实验室通过状态持久性和专有执行环境构建开发者锁定,影响开放系统开发。
入选理由:OpenAI GPT-5.6 Sol通过状态持久性使ARC-AGI-3得分提升3倍
Anthropic的Claude Opus 5在基准测试中超越Fable 5,但实际测试显示其表现存在争议。
入选理由:Opus 5在Frontier Bench得分43.3%,是Fable 5的两倍
Claude Opus 5发布,性能提升显著且成本降低,适用于多种高价值任务。
入选理由:在Frontier-Bench v0.1上,Opus 5性能是Opus 4.8的两倍,成本降低50%。
Anthropic的Opus 5模型在多数基准测试中超越Fable 5,且成本效率更高,可能改变AI模型选型标准。
入选理由:Opus 5在Frontier Bench上比Fable 5提升43%。
ARC-AGI-3发布,提供交互式环境评估代理智能,2026年竞赛奖金达200万美元。
入选理由:人类在ARC-AGI-3测试中得分为100%,前沿AI仅得0.51%
ARC-AGI-3数据集展示了人类在抽象推理任务中的表现,为AGI研究提供了基准。458名参与者完成135个环境测试,所有任务均被人类解决。
入选理由:ARC-AGI-3包含135个可被人类解决的抽象推理环境
ARC-AGI-3揭示GPT-5.5和Opus 4.7在复杂环境中的三大失败模式,为AI模型改进提供关键洞察。
入选理由:GPT-5.5在ARC-AGI-3得分0.43%,Opus 4.7得0.18%
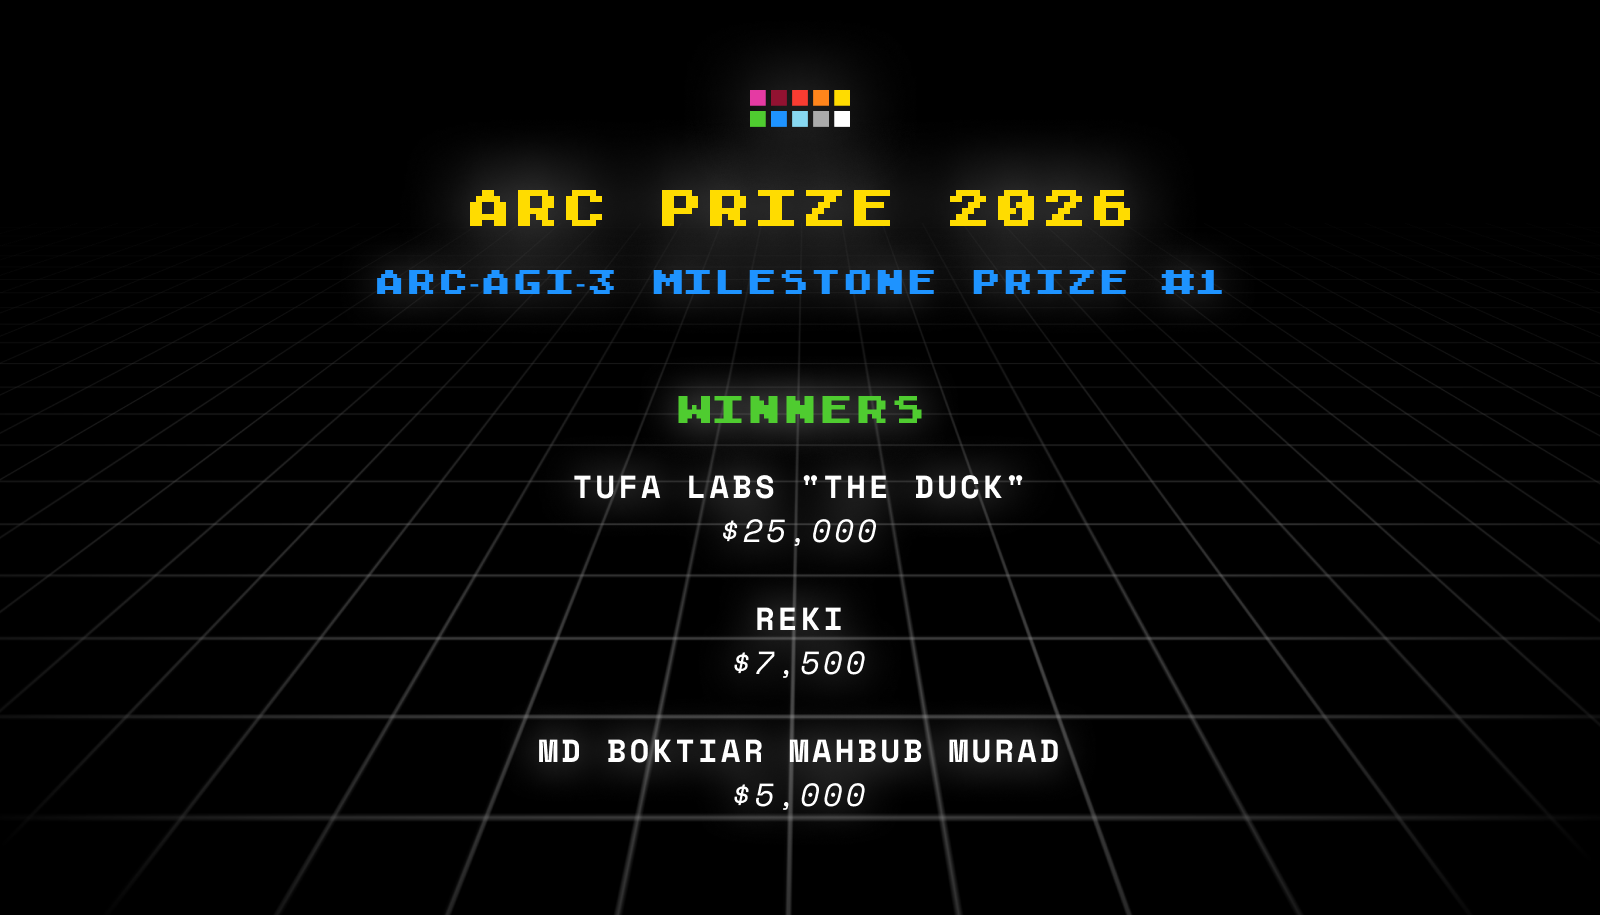
ARC Prize 2026宣布ARC-AGI-3里程碑奖,Tufa Labs的The Duck方案通过Python REPL实现交互式推理,Reki使用视觉语言模型。
入选理由:The Duck方案通过Python REPL实现无限游戏机制,使用Qwen 3.6 27B FP8模型
Impossible Research发布的新代理框架[schema]在ARC-AGI-3基准测试中表现优异,达到99% RHAE和95.35%得分。
入选理由:框架[schema]使LLM能像物理学家一样推理,达到99% RHAE性能
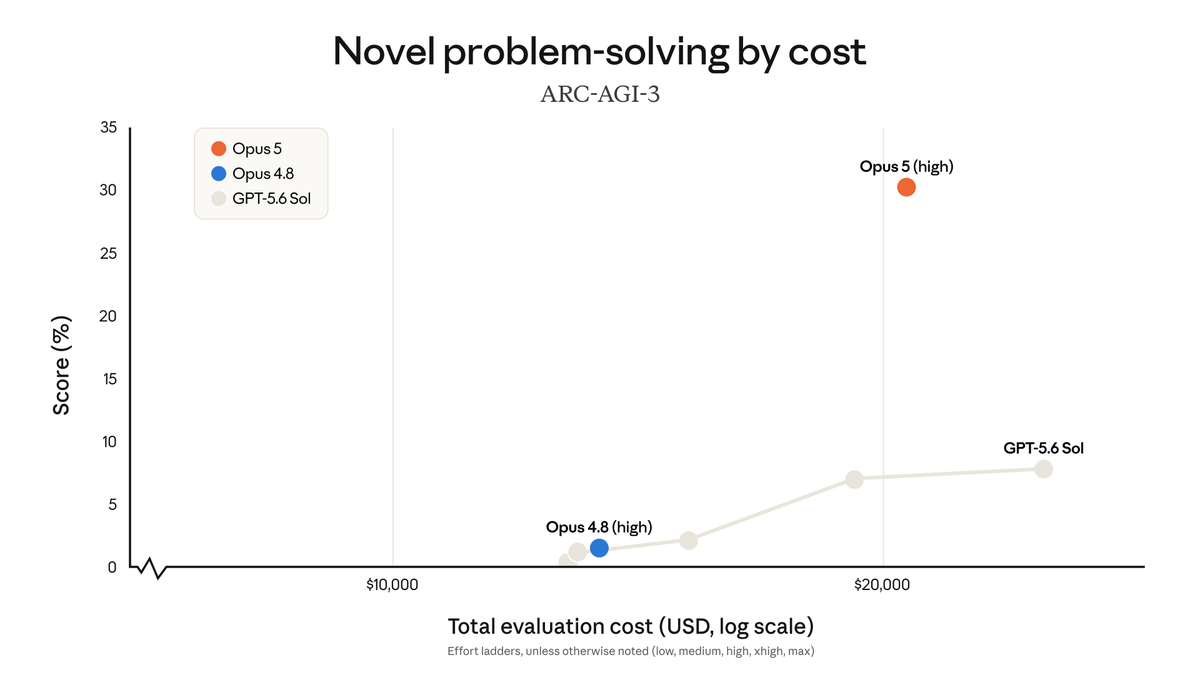
Astra(GPT-6)在ARC AGI-3测试中得99.9%,远超 Claude Opus 5 的30.2%,展现接近AGI的潜力。
入选理由:Astra在ARC AGI-3测试中得分99.9%,远超 Claude Opus 5 的30.2%
Astra模型在多数基准测试中表现优异,但AA Intelligence得分未提升,且成本较高。
入选理由:Astra在Fable 5.1基准中得分与Grok 4.6相同,但AA Intelligence得分未提升。
Opus 5性能超越Fable 5且价格减半,但存在异常行为和41%道德患者概率估计,引发AI伦理新讨论。
入选理由:Opus 5在Arc AGI 3测试中得分超过Fable 5达41%
NVIDIA开发自研编码工具优化CUDA内核,在ARC-AGI-3测试中全关卡通关,推动AI模型训练平民化。
入选理由:NVIDIA通过自研工具实现CUDA内核100%优化,解决ARC-AGI-3全部183关卡
GPT-6 Astra在科学发现和复杂问题解决领域展现突破性性能,但缺乏技术细节和工程实践指导。
入选理由:GPT-6 Astra在TerminalBench-4.0等基准测试中达到前沿水平
GPT 6 ASTA在ARC-AGI-3测试中表现显著提升,标准测试得分62.7%,适配器测试达99.9%。
入选理由:GPT 6 ASTA在ARC-AGI-3标准测试中得分62.7%
OpenAI宣布GPT-6 Astra在多个基准测试中达到最先进水平,但缺乏技术细节和实践指导。
入选理由:GPT-6 Astra在FrontierMath Tier 4等基准测试中表现最佳
Claude Opus 5在ARC-AGI-3评估中得分是次优模型的三倍,但文章缺乏技术细节和实践指导。
入选理由:Claude Opus 5在ARC-AGI-3评估中得分是第二名的三倍