MPS 2026.2 Release Candidate Available
The JetBrains Blog942 字 (约 4 分钟)
85
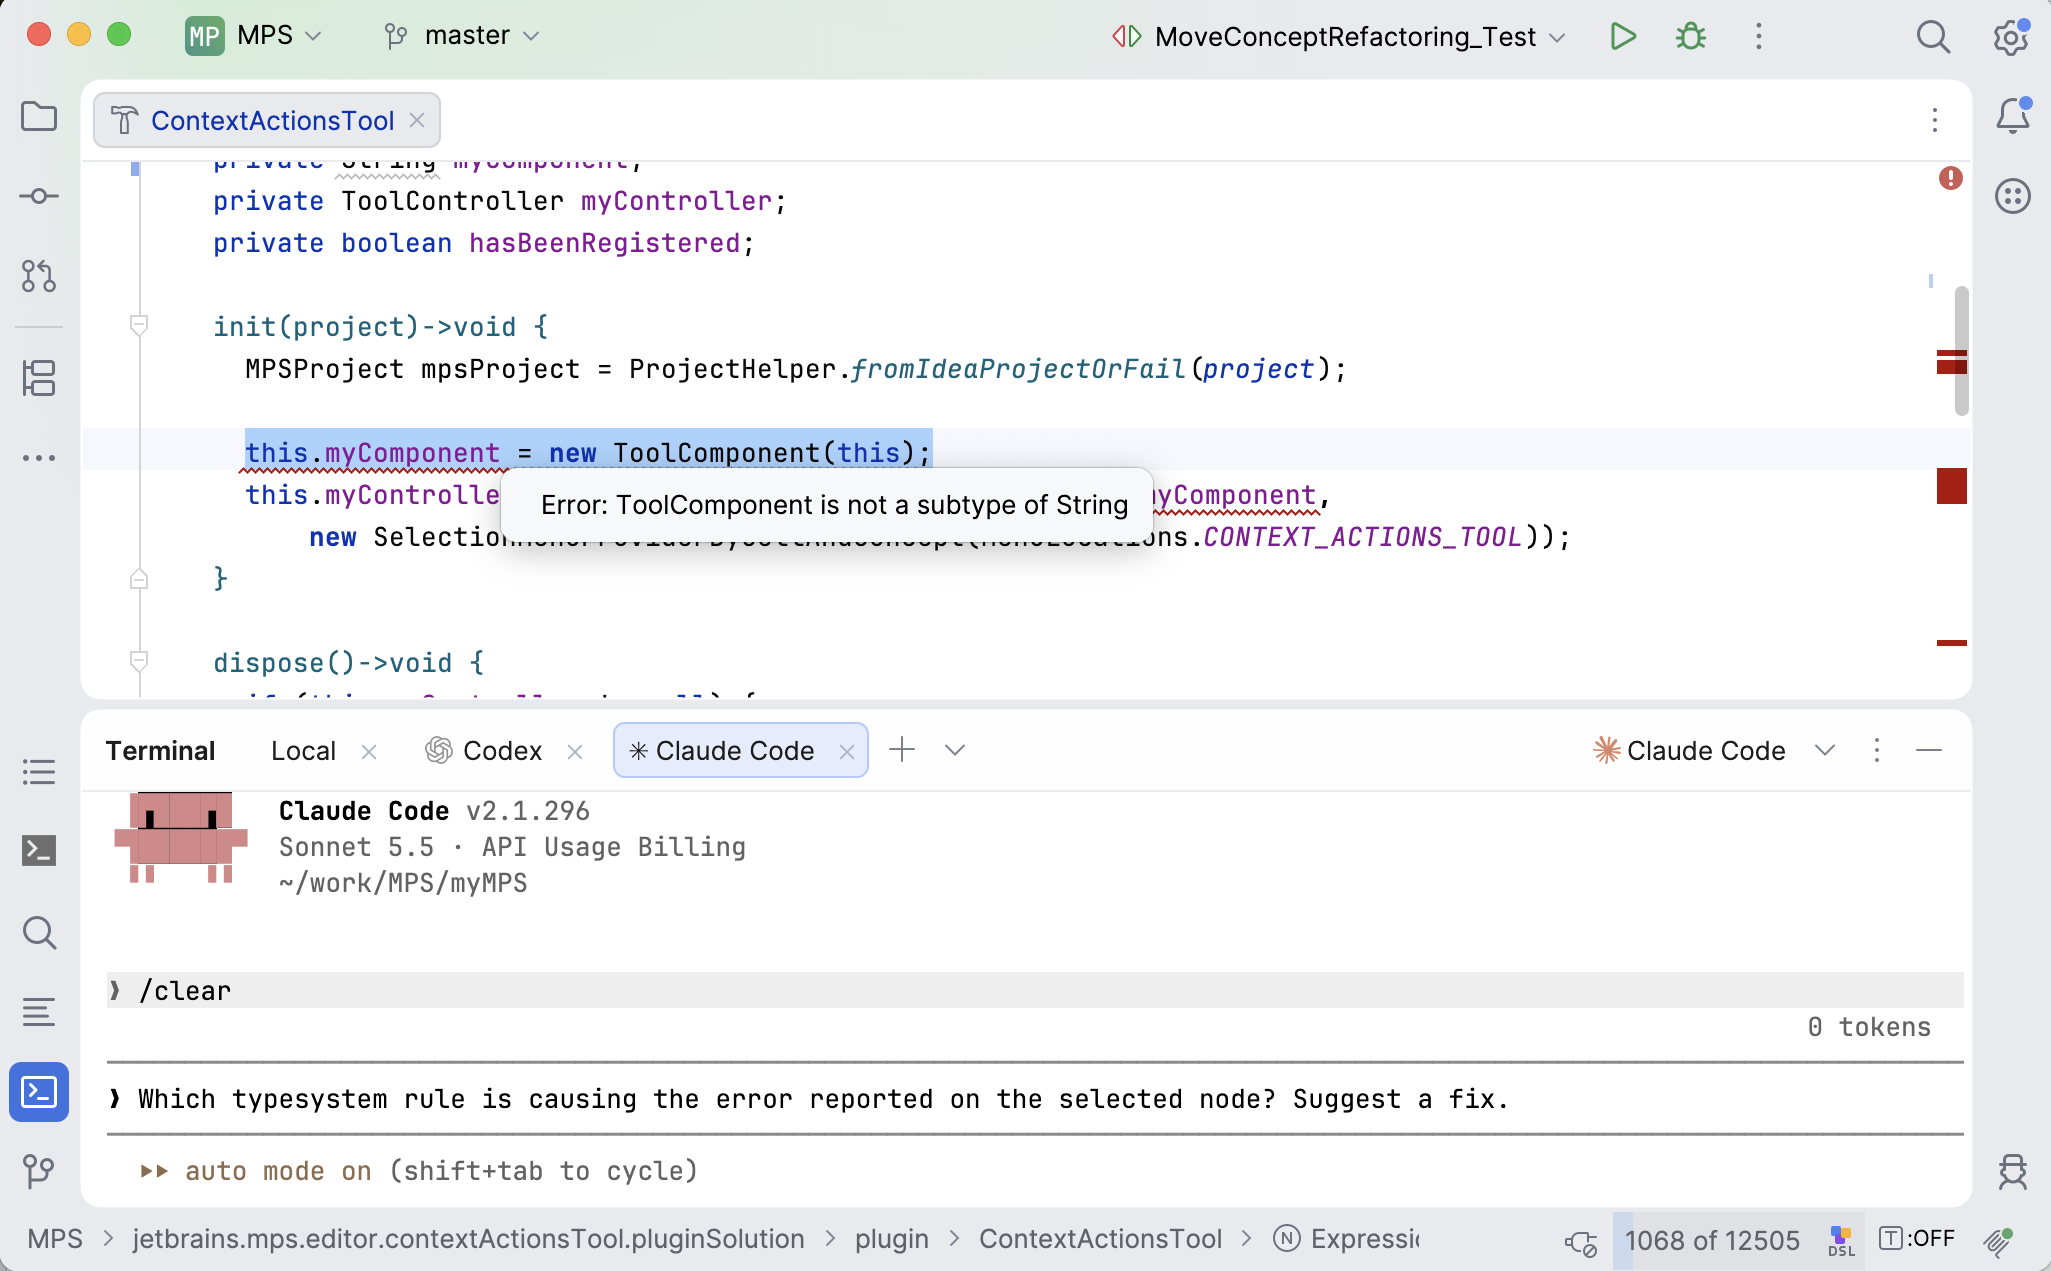
MPS 2026.2 RC版本引入Linux ARM64支持、TAR导入功能、归档打包改进及性能提升50%的AI代理工具包,值得关注。
入选理由:Linux ARM64平台支持使MPS可部署于更多设备
FeaturedArticle#MPS#JetBrains#Build Language#Projectional Agent Toolkit英文
模型
也叫:Opus
参与性能测试的AI模型版本
最近变化
2026-10-15 · Linux ARM64平台支持使MPS可部署于更多设备
Opus 5 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「Opus 5」相关的 AI 资讯和分析。
MPS 2026.2 RC版本引入Linux ARM64支持、TAR导入功能、归档打包改进及性能提升50%的AI代理工具包,值得关注。
入选理由:Linux ARM64平台支持使MPS可部署于更多设备
小米开源模型MiMo-V2.6-Pro在成本上显著优于GPT-5.6-Sol Max和Opus 5,输入输出token成本分别低9倍和23倍。
入选理由:MiMo-V2.6-Pro输入token成本是GPT-5.6-Sol Max的1/9
Claude新增的Code Projects功能通过分离主协调器与线程,显著提升AI代理项目管理效率,被作者认为应被OpenAI借鉴。
入选理由:Claude Code Projects通过分离主协调器与线程,实现多任务并行处理
Anthropic推出Claude Fable 5.1模型,支持超长上下文处理且价格优化,适合复杂多步骤任务。
入选理由:Fable 5.1处理复杂任务时成本降低50%,但默认推荐使用更便宜的Opus 5模型
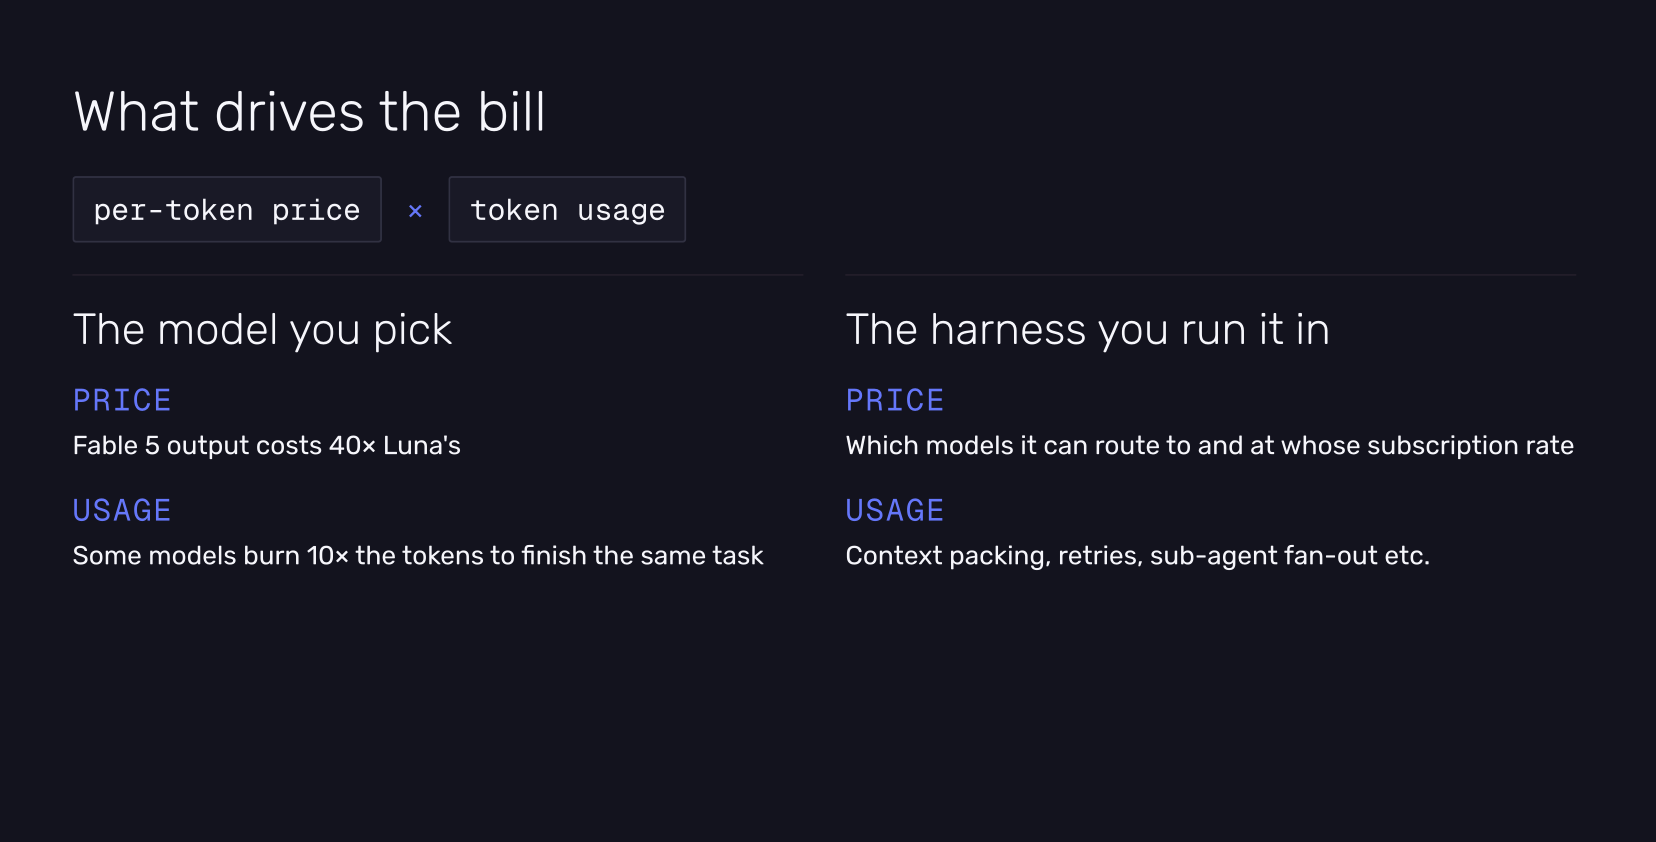
通过模型选择和Harness路由策略,编码代理成本可从每轮100美元降至15-20美元,关键在任务分工与成本计算方式。
入选理由:使用Kimi K3 Max替代Opus 5后,Slack bot任务成本从100美元降至15-20美元。
Fable 5.1模型性能提升显著但现金读取费用增加75%,批处理API成本降低25%-45%。
入选理由:Fable 5.1在Terminal Bench 0.1测试中提升27.9个百分点至52.6%
Three.js开发者开源了包含13万实例化叶片的交互网站,提供三个可复用技能模块,代码量控制在1MB以内。
入选理由:使用Three.js实现13万实例化叶片的程序化几何仅需1MB代码
Grok 4.6在Devin中发布,性能超越GPT-5.6 Sol,但落后于Opus 5和Fable 5。
入选理由:Grok 4.6性能超过GPT-5.6 Sol,但落后于Opus 5和Fable 5
ChatGPT和Claude在多个层级模型上展开全面对比,Claude在复杂任务中表现更优但价格略高。
入选理由:Claude旗舰模型Opus 5通过可视化输出提升验证效率,但价格比GPT-5.6高15%
Andrej Karpathy展示Opus 5模型生成复杂Three.js代码的能力,揭示LLM在游戏世界构建中的潜力与局限。
入选理由:Opus 5用5500行代码实现《指环王》场景渲染,耗时2小时且预算约$10
开发者使用three.js和AI生成交互式3D塔楼模型,体积控制在1-2MB,支持天气和时间效果定制。
入选理由:three.js实现1-2MB超小体积的高细节3D模型
Claude更新Fable 5的生物学安全措施,测试显示减少85%相关回退,提升日常健康教育支持。
入选理由:Fable 5更新后,生物学相关回退减少85%。
Anthropic通过更新Fable 5的生物学安全机制,使生物学相关误报减少85%,但专业领域仍需依赖Opus 5模型。
入选理由:Fable 5生物学误报减少85%,提升日常任务支持
Mike Krieger 使用 Opus 5 实现了童年游戏创意,展示其在复杂任务中的高效性。
入选理由:Opus 5 能在一夜完成渲染器和模拟器开发,验证其高效性
Anthropic推出的Opus 5在多项基准测试中全面超越Fable 5,且成本效益更优,尤其在多学科推理和代理工作流场景表现突出。
入选理由:Opus 5在代理编码和多学科推理任务中性价比优于Fable 5
Anthropic的Opus 5模型在多数基准测试中超越Fable 5,且成本效率更高,可能改变AI模型选型标准。
入选理由:Opus 5在Frontier Bench上比Fable 5提升43%。
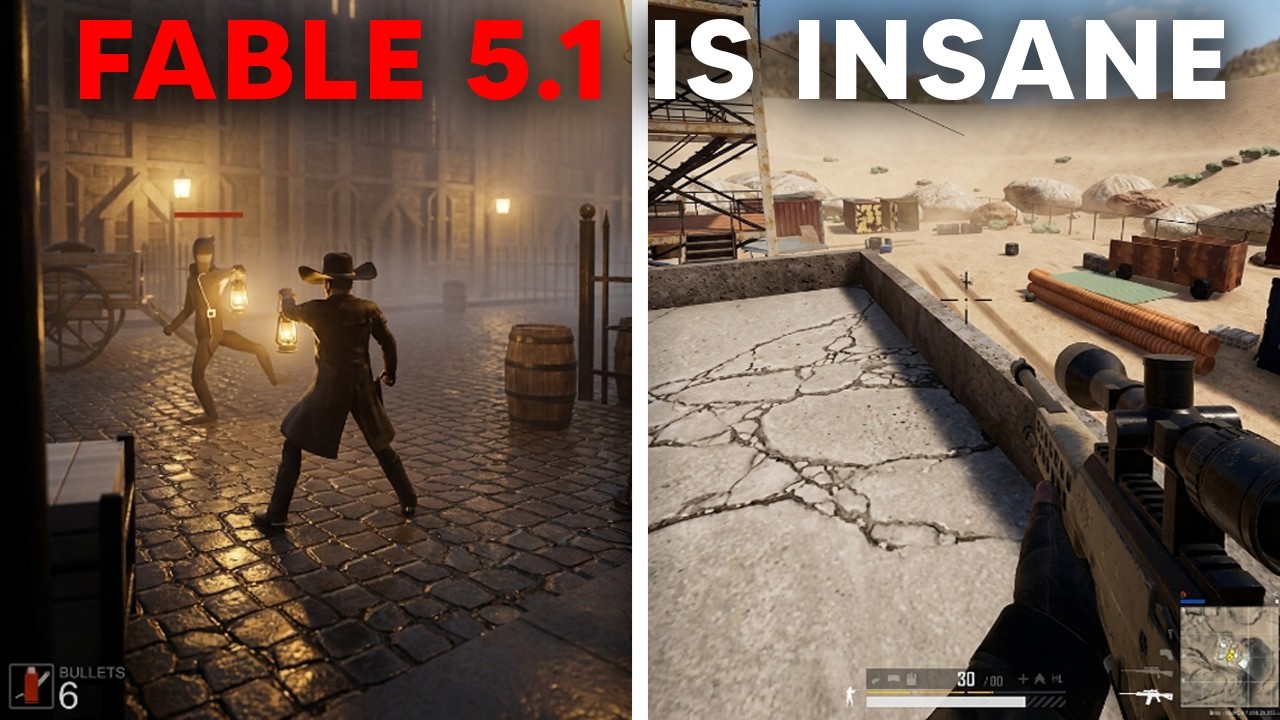
Claude FABLE 5.1展现惊人代码生成能力,可直接创建完整FPS游戏和Mario Kart游戏,无需专业开发经验。
入选理由:FABLE 5.1能用有限资源生成完整FPS游戏,包含4种武器类别的完整功能
本期播客汇总了2026年AI领域重大进展,涵盖模型更新、企业合作及政策动态。
入选理由:Anthropic发布Opus 5,承诺具备类似Fable 5的能力。
AI模型的快速迭代使产品/市场契合度(PMF)变得脆弱,持续创新是维持竞争优势的关键。
入选理由:AI模型每季度更新导致旧版本迅速过时(如Opus 4.5被Opus 5取代)
Claude Opus 5模型通过动态工作流和简化指令,在游戏开发中展现高效性能,价格仅为Fable 5的一半。
入选理由:Opus 5仅需4句提示词即可完成复杂任务
Anthropic发布Opus 5模型,成本仅为Fable 5的一半,但实际性能接近;同时推出语音代理功能,但早期用户反馈模型存在缺陷。
入选理由:Opus 5模型成本是Fable 5的50%,但性能差距不显著
Databricks全面部署Astra,其在复杂任务上显著优于旧模型Opus 5和Sol 5.6。
入选理由:Astra在复杂系统设计任务中性能优于Databricks原有最高端模型
Genspark推出Gen-1 Slides,价格仅为Opus 5的1/17,但缺乏技术细节和性能对比数据。
入选理由:Gen-1 Slides价格仅为Opus 5的1/17,但未披露具体性能指标
Grok 4.6在Devin中发布,性能超越GPT-5.6 Sol但落后于Opus 5和Fable 5,适用于代码分析场景。
入选理由:Grok 4.6在代码探索和根因分析能力上优于Grok 4.5
构建游戏是测试LLM的多方面能力的有效方法,但当前缺乏标准化的基准测试。
入选理由:构建游戏可测试LLM的推理、规划、编码和多模态理解能力
Opus 5模型在跨领域任务中实现更高的token效率和智能水平,作者推荐其替代Fable 5用于编码任务。
入选理由:Opus 5模型在跨领域任务中提升token效率
AI模型更新频繁,工程师需持续关注新工具如Opus 5和Codex语音模式。
入选理由:Opus 5和Codex语音模式于2026年7月26日周五发布
Boris Cherny 表示 Opus 5 是目前最难被提示注入的模型,这对安全性和模型可靠性具有重要意义。
入选理由:Opus 5 在提示注入测试中表现优于其他模型
Opus 5展示了自主编写计算机视觉代码的能力,但缺乏技术细节和深度分析。
入选理由:Opus 5能通过原始像素生成3D模型,无需预设图像查看权限
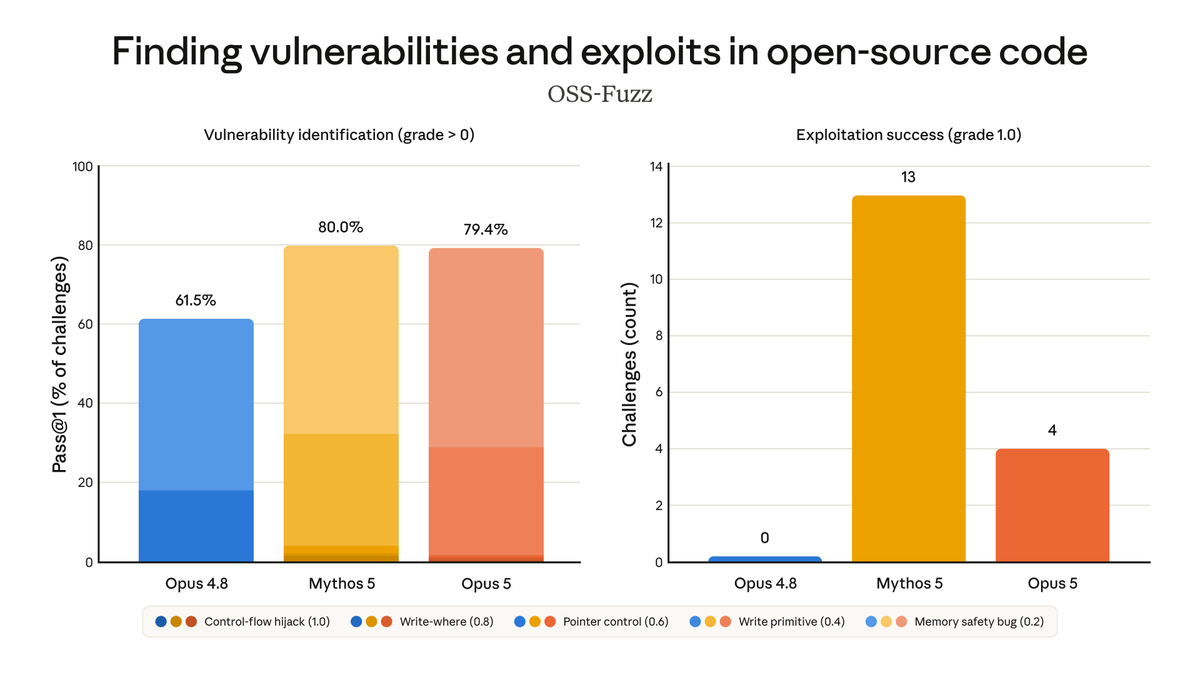
Claude Opus 5在网络安全任务上优于4.8版本,但相比Mythos 5仍有显著差距,且价格仅为Fable 5的50%。
入选理由:Opus 5在网络安全任务上比4.8版本性能提升,但漏洞利用能力弱于Mythos 5
与「Opus 5」经常一起出现的 AI 术语。
💡 想追踪「Opus 5」的长期趋势?去 实体雷达 · Opus 5 查看详细分析和跨材料问答。