SpenseGPT Practical One-shot Pruning Enabling Sparse and Dense GEMMs for LLM Inference
AK(@_akhaliq)50 字 (约 1 分钟)
85
SpenseGPT 提出了一种实用的单次剪枝方法,优化了大语言模型推理中的稀疏和密集 GEMM 计算。
入选理由:SpenseGPT 通过单次剪枝实现稀疏和密集 GEMM 的优化。
FeaturedTweet#SpenseGPT#LLM#GEMM#剪枝#AI英文
人物
也叫:@_akhaliq
推文作者,论文宣传者
最近变化
2026-10-16 · OmniCompass支持跨模态视频理解任务
AK 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
SpenseGPT Practical One-shot Pruning Enabling Sparse and Dense GEMMs for LLM Inference
AK(@_akhaliq) · 8.5 分
SkillOS Learning Skill Curation for Self-Evolving Agents paper: https://t.co/C6yKe6Kuou
AK(@_akhaliq) · 7.8 分
Seeing Isn't Knowing Do VLMs Know When Not to Answer Spatial Questions (and Why)?
AK(@_akhaliq) · 7.5 分
已收录 30 篇与「AK」相关的 AI 资讯和分析。
SpenseGPT 提出了一种实用的单次剪枝方法,优化了大语言模型推理中的稀疏和密集 GEMM 计算。
入选理由:SpenseGPT 通过单次剪枝实现稀疏和密集 GEMM 的优化。
SkillOS is a skill orchestration system for self-evolving agents, achieving 34% higher accuracy through dynamic skill library and meta-learning mechanisms.
入选理由:SkillOS 采用动态技能库,支持实时技能增删与更新。
This article explores a new approach to GPU kernel runtime optimization using language models as selective surrogates, achieving significant performance improvements by predicting and selecting optimal kernel configurations.
入选理由:语言模型被用作选择性代理,预测 GPU 内核的最佳配置。
This article explores the limitations of Visual Language Models (VLMs) in handling spatial questions, highlighting their tendency to confidently generate answers even when visual cues are ambiguous, and suggests introducing uncertainty mechanisms to improve model robustness.
入选理由:VLMs 在缺乏明确视觉线索时,仍可能自信地生成空间问题的答案。
LongMINT is a new benchmark testing framework for evaluating memory capabilities under multi-target interference in long-horizon agent systems, which has gained attention through academic sharing on Twitter. This framework specifically addresses memory interference issues in AI agents during long-term tasks and provides standardized testing methods for measuring continuous learning and memory management capabilities of agent systems.
入选理由:LongMINT是专门评估长视界智能体记忆干扰的新基准测试框架
Mix-Quant technology significantly improves the efficiency and precision balance of agentic LLMs through a hybrid strategy of quantized prefilling and precise decoding, providing new optimization directions for large model deployment.
入选理由:Mix-Quant采用量化预填充和精确解码的混合策略优化LLM性能
MulTaBench is a benchmark for evaluating multimodal tabular learning with text and image.
入选理由:MulTaBench 包含 12 个数据集和 3 种任务类型。
The article introduces the MACE-Dance model for music-driven dance video generation.
入选理由:MACE-Dance 是一种音乐驱动的舞蹈视频生成模型。
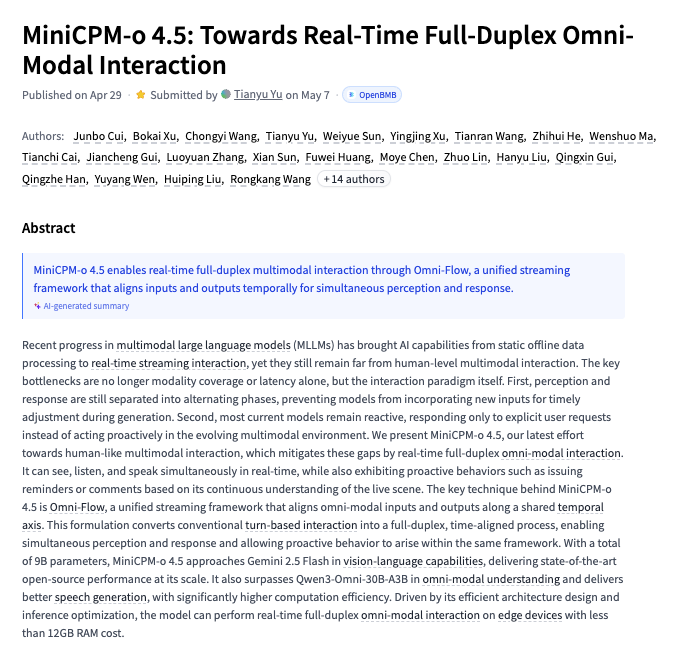
MiniCPM-o 4.5 提出了一种实时全双工多模态交互的新方法,但缺乏详细的技术实现细节。
入选理由:MiniCPM-o 4.5 支持实时全双工多模态交互。
ESI-Bench is a novel benchmark focused on evaluating embodied spatial intelligence models in perception-action loops, offering more challenging scenarios and metrics than existing tests.
入选理由:ESI-Bench 采用连续 3D 轨迹预测任务,比现有基准更具挑战性
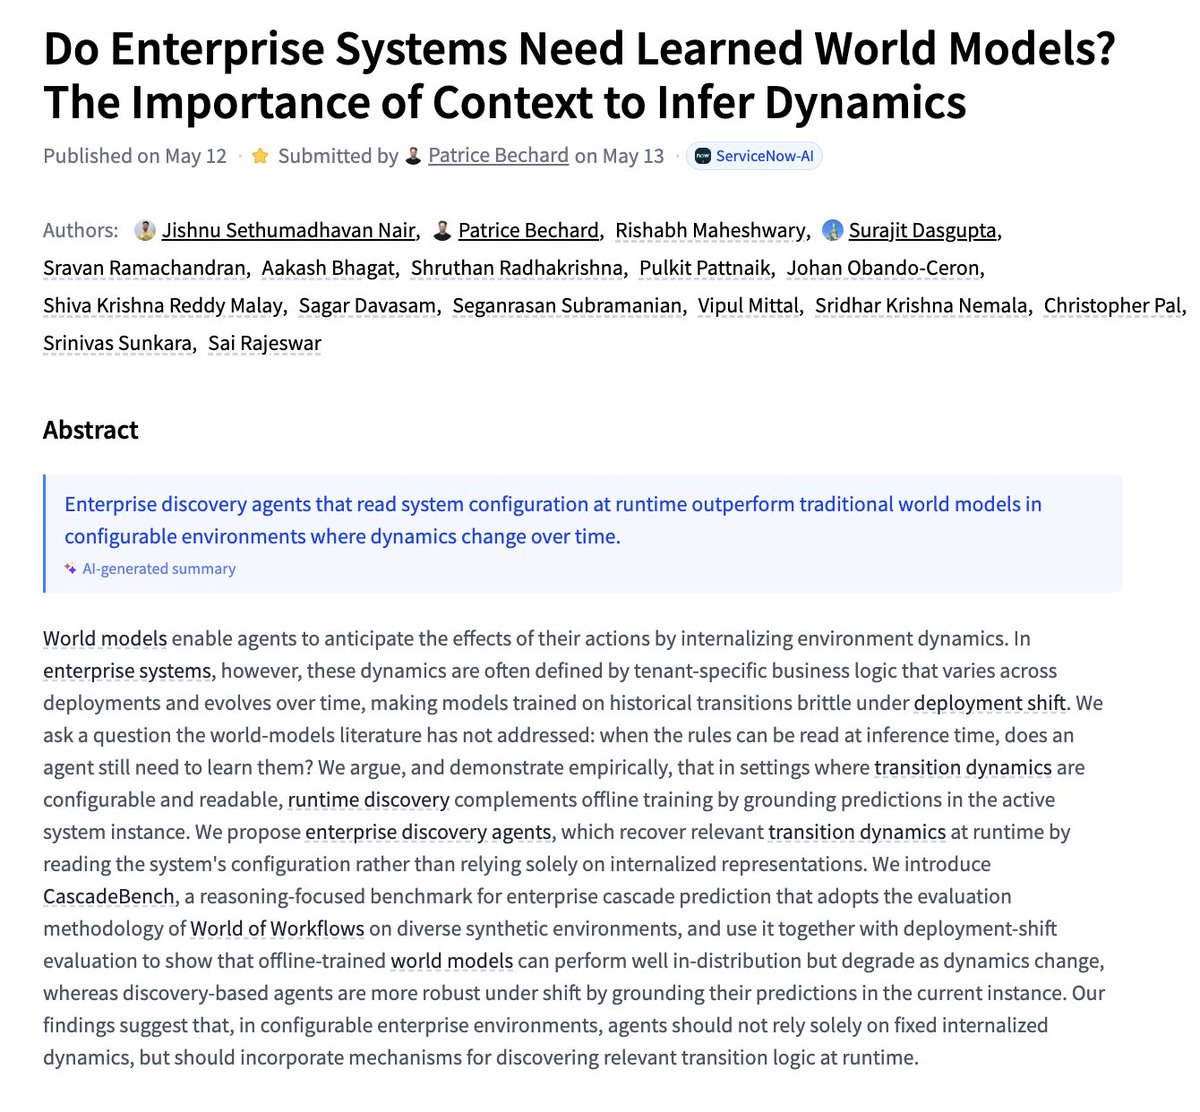
企业系统是否需要学习世界模型?文章探讨了上下文对推断动态的重要性,强调了在复杂环境中理解背景信息的价值。
入选理由:在企业系统中,上下文对于推断系统的动态行为至关重要。
EditHero 是一个针对长期视角部件级3D编辑和Vibe建模的基准测试,旨在推动相关技术发展。
入选理由:EditHero 填补了长期视角3D编辑基准的空白,支持部件级精细操作。
PhyMotion introduces a structured 3D motion reward mechanism grounded in physics to enhance the realism of human video generation.
入选理由:PhyMotion 引入物理约束以增强视频生成的真实性。
Research shows that a single neuron can bypass the safety alignment of large language models.
入选理由:单个神经元可破坏模型安全对齐
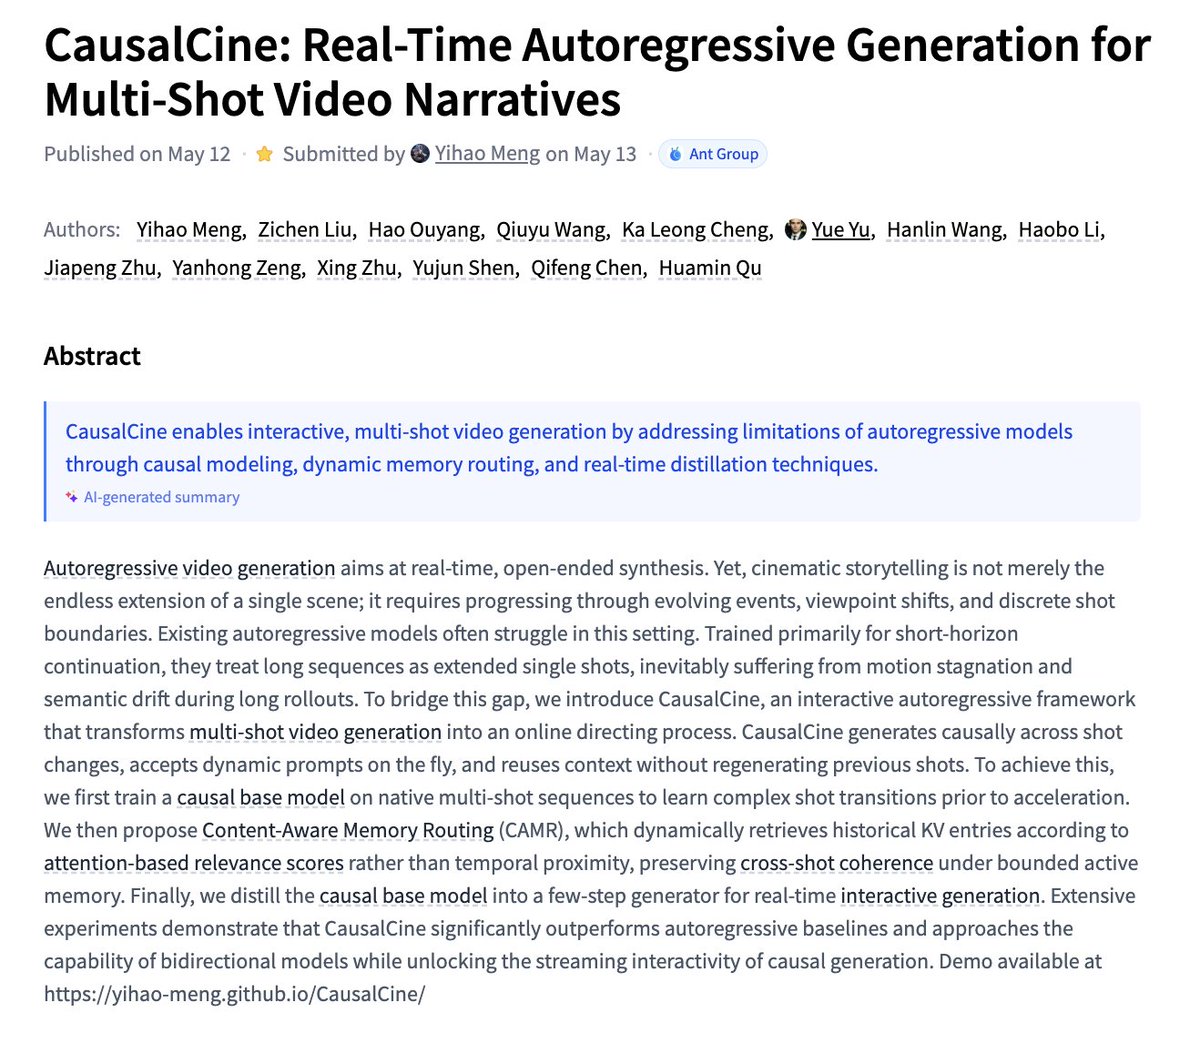
AK 在推特上分享了一种新的视频叙事生成方法 CausalCine,利用实时自回归生成技术。
入选理由:实时生成多镜头视频故事
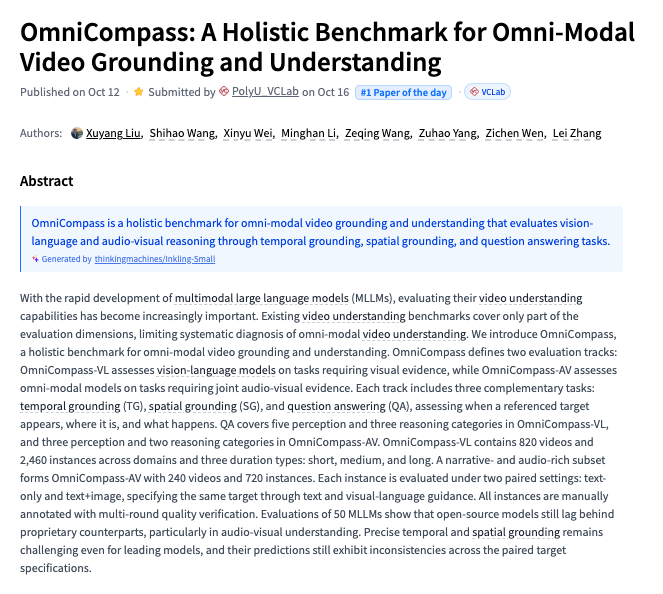
OmniCompass是首个多模态视频定位基准,但论文细节缺失导致信息密度不足。
入选理由:OmniCompass支持跨模态视频理解任务
BudgetPix论文提出计算自适应分词方法,但推文内容未展示技术细节,需参考原论文获取完整信息。
入选理由:BudgetPix通过计算自适应分词优化像素空间图像扩散
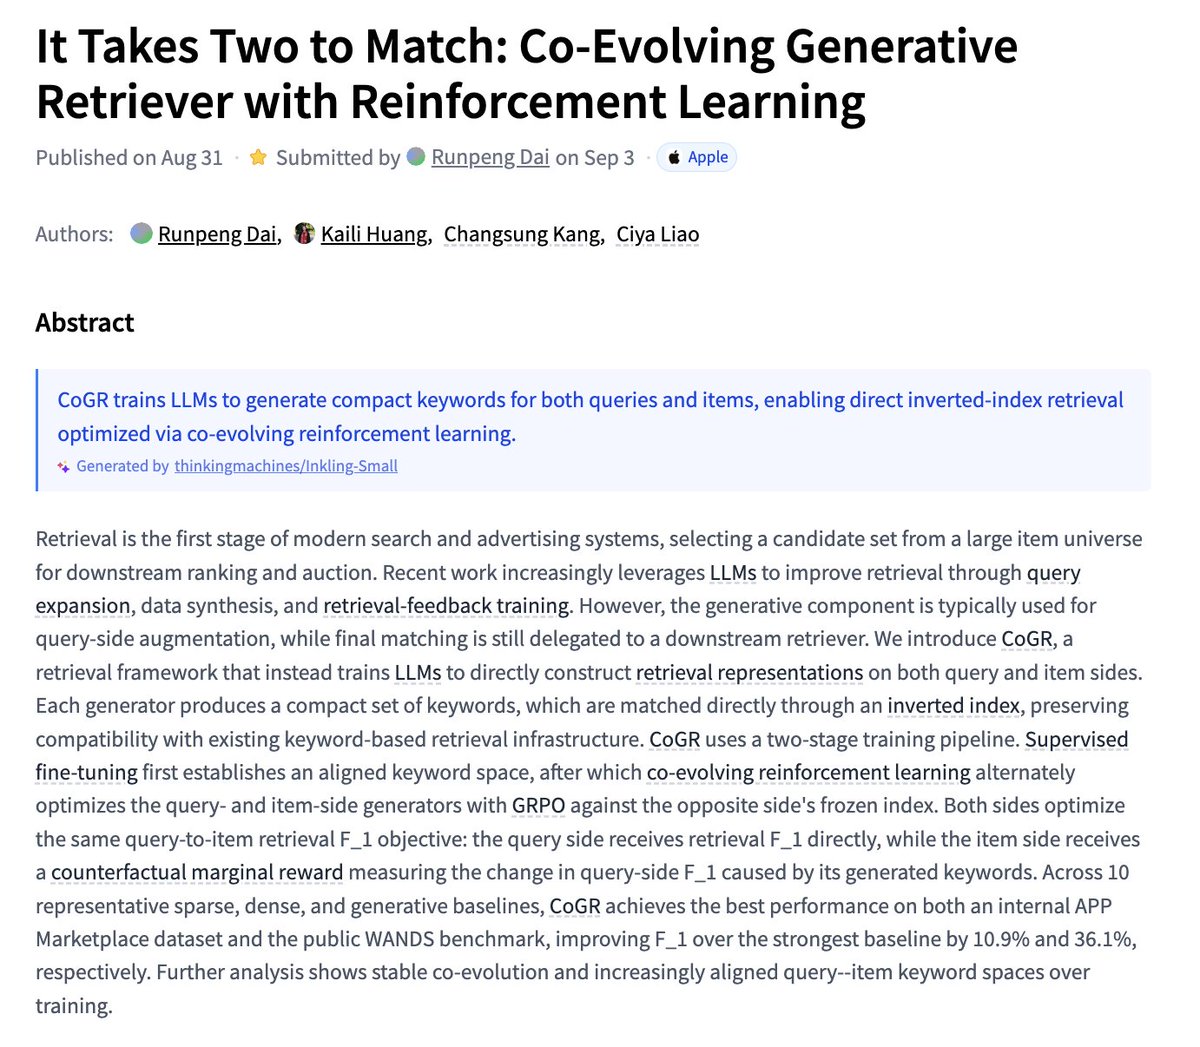
该论文提出生成式检索器与强化学习协同演进的新方法,但推文内容未提供技术细节和实验数据。
入选理由:生成式检索器与强化学习的协同演进方法被提出
该推文讨论了一篇关于通过离散扩散实现LLM加速的论文,但内容以提问和评论为主,缺乏完整技术细节。
入选理由:扩散权重可附加在现有AR模型上,训练开销极小
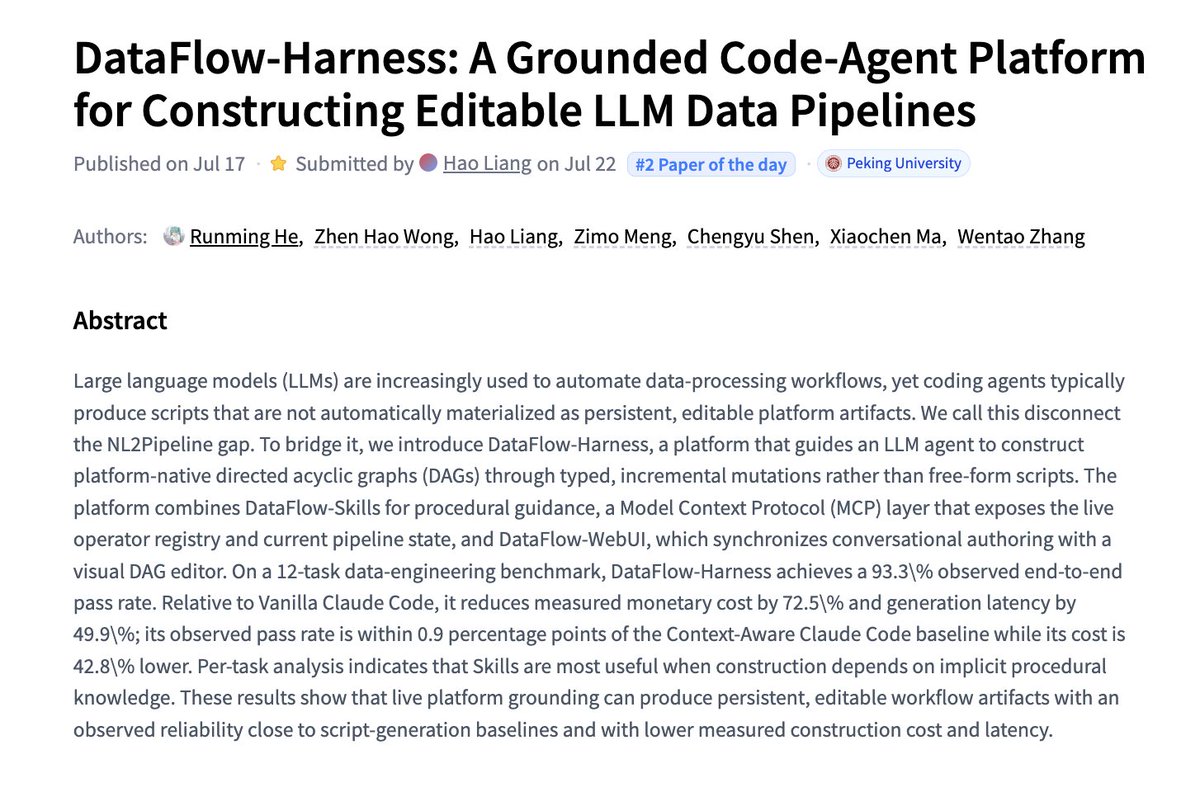
DataFlow-Harness 是一个基于代码代理的可编辑 LLM 数据流水线平台,但推文内容缺乏技术细节和实证分析。
入选理由:DataFlow-Harness 通过图形编辑替代文件编辑解决临时脚本问题
VideoChat3是首个全开放的视频多模态大模型,支持高效通用视频理解,但技术细节披露有限。
入选理由:VideoChat3是首个全开放的视频MLLM,支持高效视频理解
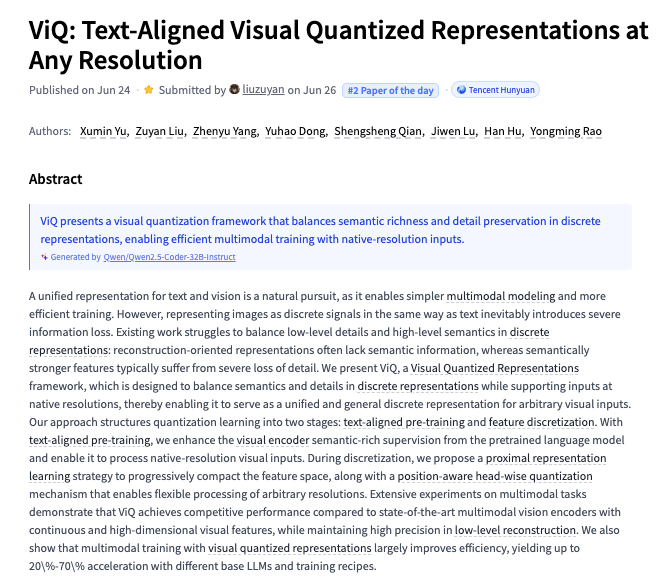
ViQ 是一种文本对齐的视觉量化表示方法,可在任意分辨率下使用。
入选理由:ViQ 支持任意分辨率的视觉量化表示。
本文提出了一种基于置信度的工具编排方法,用于提升视频理解的鲁棒性,但内容较为简略,缺乏具体实现细节。
入选理由:置信度感知的工具编排方法可提升视频理解的鲁棒性。
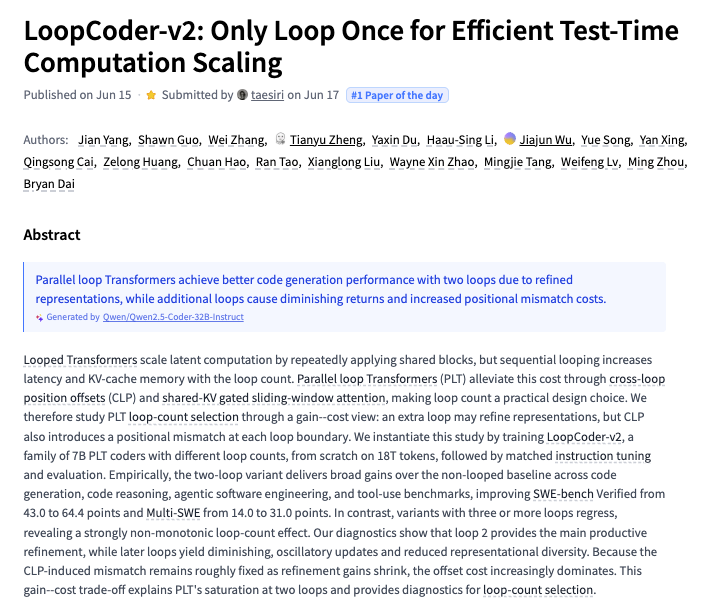
LoopCoder-v2 是一种优化测试时计算效率的方法,通过减少循环次数提升性能。
入选理由:LoopCoder-v2 通过减少循环次数来提高测试时的计算效率。
文章分享了一篇关于LoopCoder-v2的论文,旨在提高测试时计算效率。
入选理由:LoopCoder-v2通过仅循环一次来提高测试时计算效率。
World Tracing 是一种生成像素对齐几何的新技术,但文章内容信息密度低,缺乏具体机制和实用价值。
入选理由:World Tracing 是一种生成像素对齐几何的新技术。
文章介绍了一种可扩展的3D交互轨迹世界模型μ_0,但内容信息密度低,缺乏具体技术细节和实用价值。
入选理由:文章提出了一种名为μ_0的3D交互轨迹世界模型。
CHORUS 是一种基于单一 VLA 策略的去中心化多实体协作方法,但文章内容信息密度低,缺乏具体机制和实践细节。
入选理由:CHORUS 采用单一 VLA 策略实现多实体协作。
文章分享了一篇关于SpenseGPT的论文,探讨了一种名为SpenseGPT的模型,旨在通过稀疏和密集GEMMs实现大语言模型的高效推理。
入选理由:SpenseGPT是一种通过稀疏和密集GEMMs实现高效推理的模型。
文章探讨了On-Policy Distillation的几何特性,但信息密度较低,缺乏具体实践指导。
入选理由:文章讨论了On-Policy Distillation的几何特性。
与「AK」经常一起出现的 AI 术语。
💡 想追踪「AK」的长期趋势?去 实体雷达 · AK 查看详细分析和跨材料问答。