[AINews] SpaceXAI Grok 4.6 and Grok @Bot
Latent Space2979 字 (约 12 分钟)
85
SpaceXAI发布Grok 4.6模型,性能超越竞品且效率更高,Grok Bot作为AI队友已进入早期测试。
入选理由:Grok 4.6是1.5T参数模型,在AA-Briefcase基准测试中成本比其他领先模型低30%。
FeaturedArticle#Grok 4.6#AI队友#SpaceXAI#模型训练英文
概念
也叫:AA测试集
衡量代理知识工作能力的基准测试
最近变化
2026-08-13 · Grok 4.6是1.5T参数模型,在AA-Briefcase基准测试中成本比其他领先模型低30%。
AA-Briefcase 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 4 篇与「AA-Briefcase」相关的 AI 资讯和分析。
SpaceXAI发布Grok 4.6模型,性能超越竞品且效率更高,Grok Bot作为AI队友已进入早期测试。
入选理由:Grok 4.6是1.5T参数模型,在AA-Briefcase基准测试中成本比其他领先模型低30%。
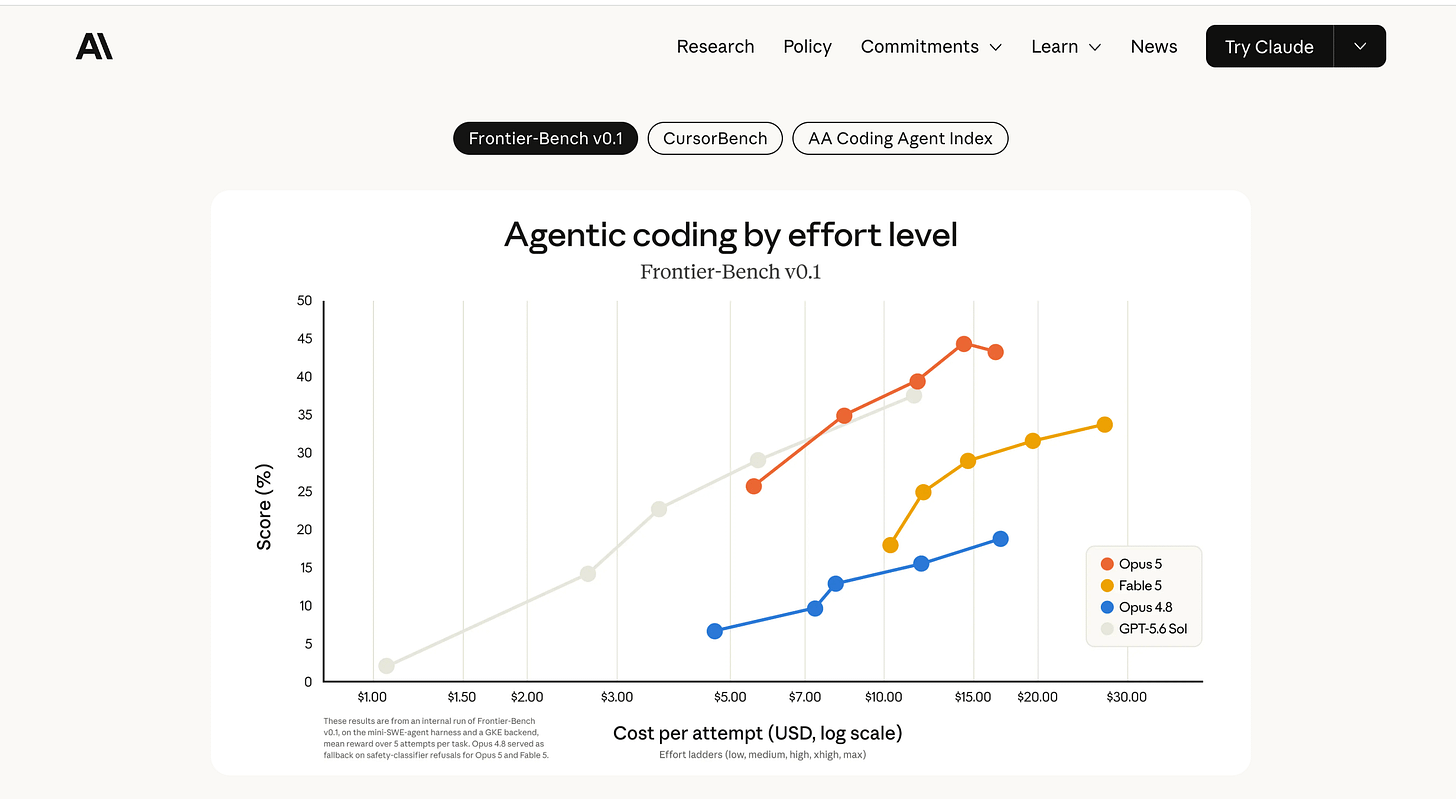
Claude Opus 5在性能接近Fable 5的同时将成本降低20%,独立测试显示其在知识工作基准测试中领先150 Elo。
入选理由:Claude Opus 5在AA-Briefcase基准测试中比Fable 5高出150 Elo
Claude Fable 5 在基准测试中表现最佳,但每任务成本高达 31 美元,而 DeepSeek V4 Flash 仅需 0.04 美元。
入选理由:Claude Fable 5 每任务成本高达 31 美元,远高于 DeepSeek V4 Flash 的 0.04 美元。
NVIDIA AI 提到 ArtificialAnlys 发布了新的 AA-Briefcase 排行榜,用于评估复杂项目中的真实任务,Nemotron 3 Ultra 表现突出。
入选理由:AA-Briefcase 是一个用于评估复杂项目中真实任务的新排行榜。
与「AA-Briefcase」经常一起出现的 AI 术语。
💡 想追踪「AA-Briefcase」的长期趋势?去 实体雷达 · AA-Briefcase 查看详细分析和跨材料问答。