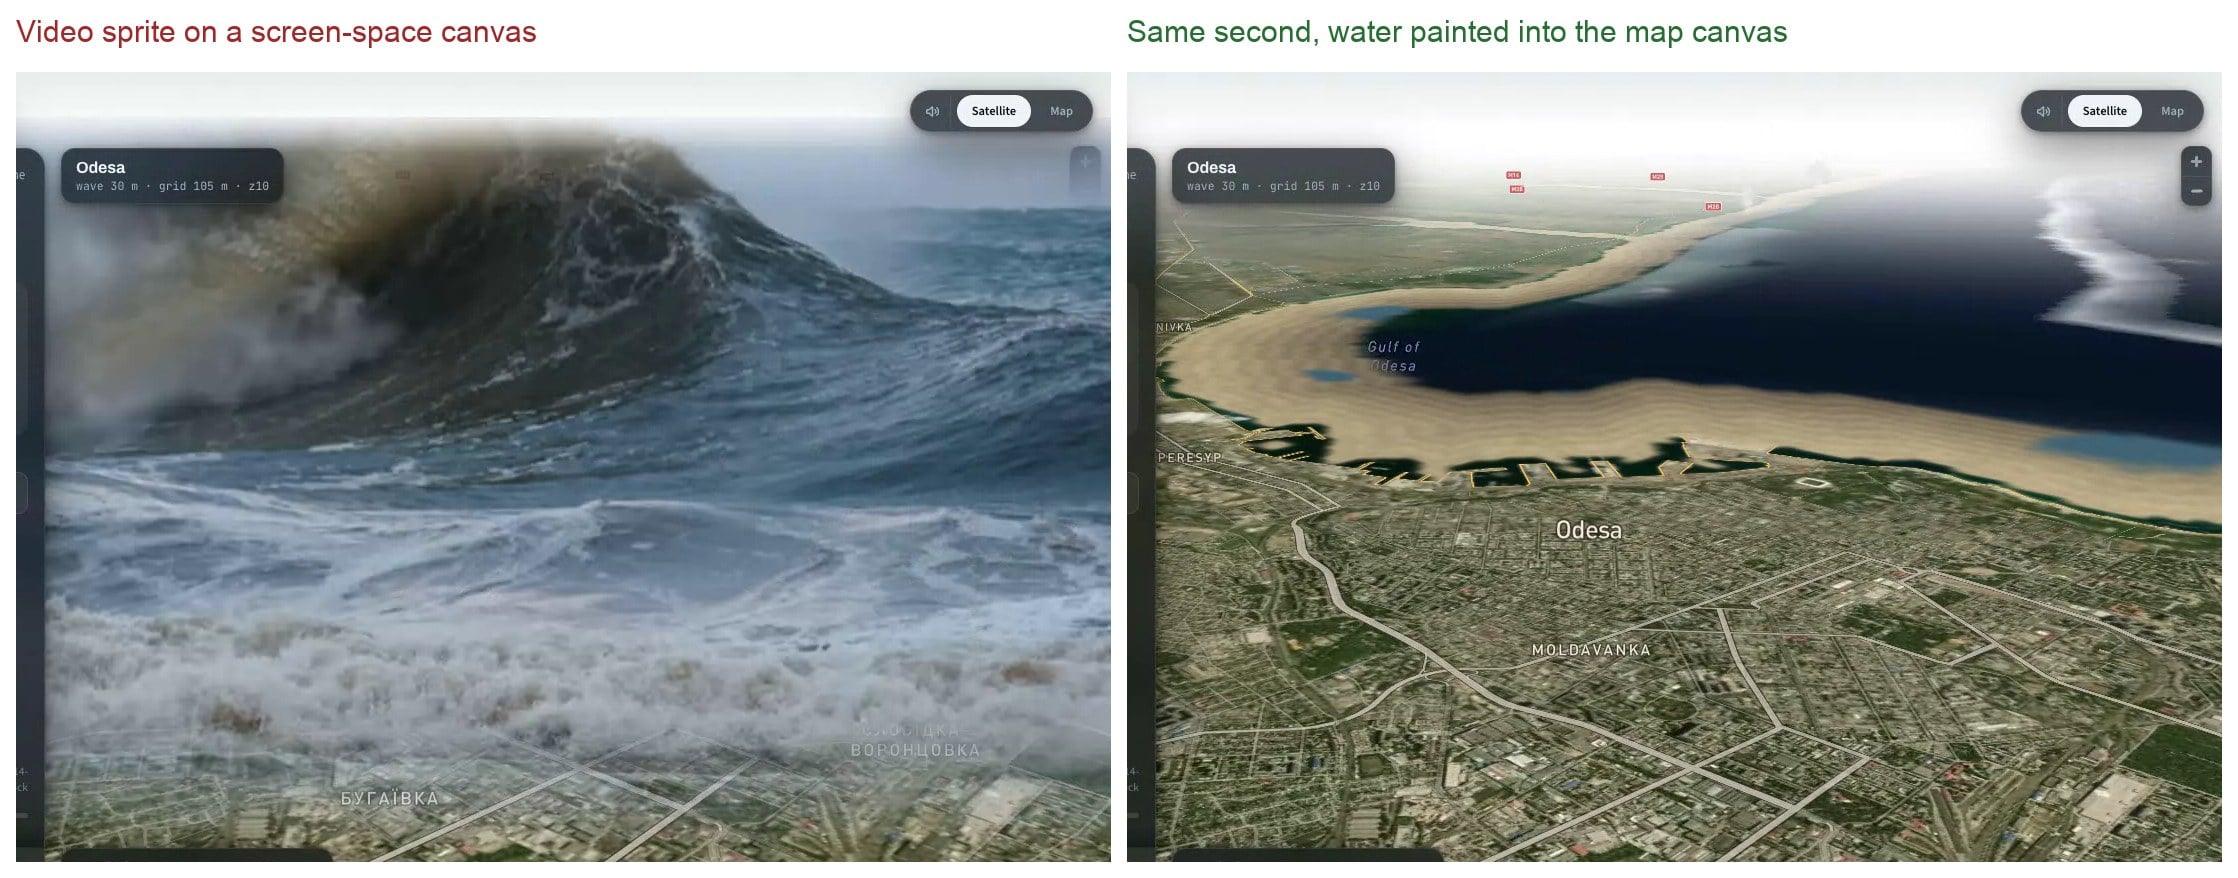
How to Build Disaster Simulations on a Real Map: Animated Canvas Layers and Collapsing 3D Buildings with Mapbox GL JS and Three.js
本文详解如何用Mapbox GL JS和Three.js构建真实地图灾难模拟,涵盖动画画布层与3D建筑坍塌技术。
入选理由:使用Mapbox GL JS处理地面层时需对齐地图瓦片坐标系
Daily AI radar
2026-10-15 当日 traeai 收录 60 条 AI 技术与产品资讯,按评分排序,每条带 AI 摘要、要点与原文链接。
canonical: https://www.traeai.com/daily/2026-10-15
Anthropic因代码合并量激增而开发了内部源代码控制系统,成功迁移单体仓库并提升效率。
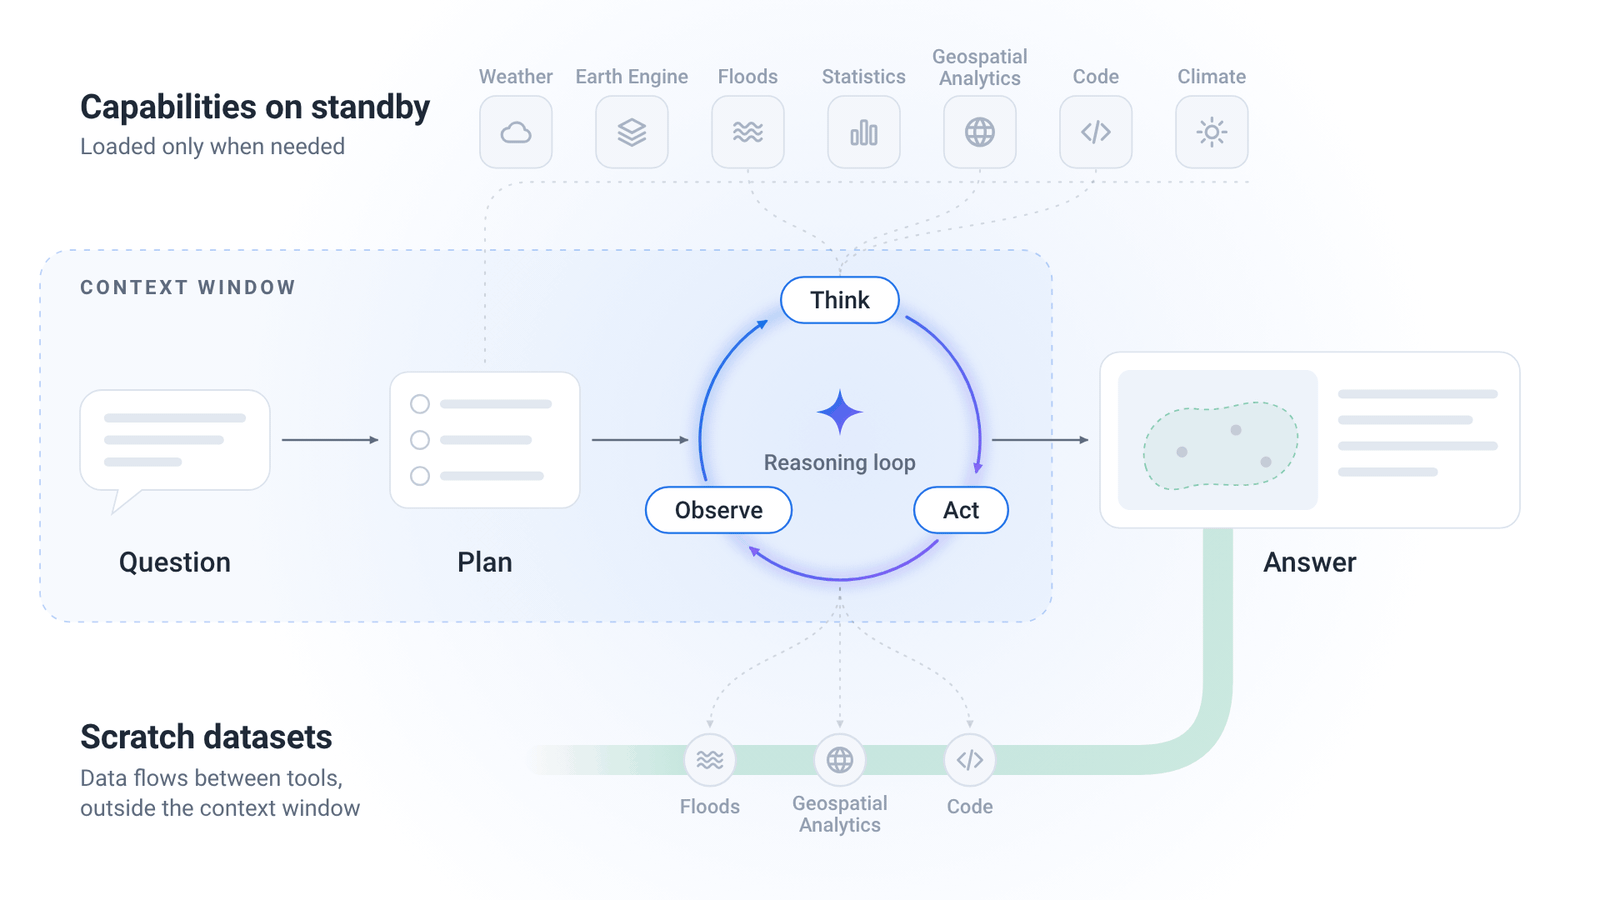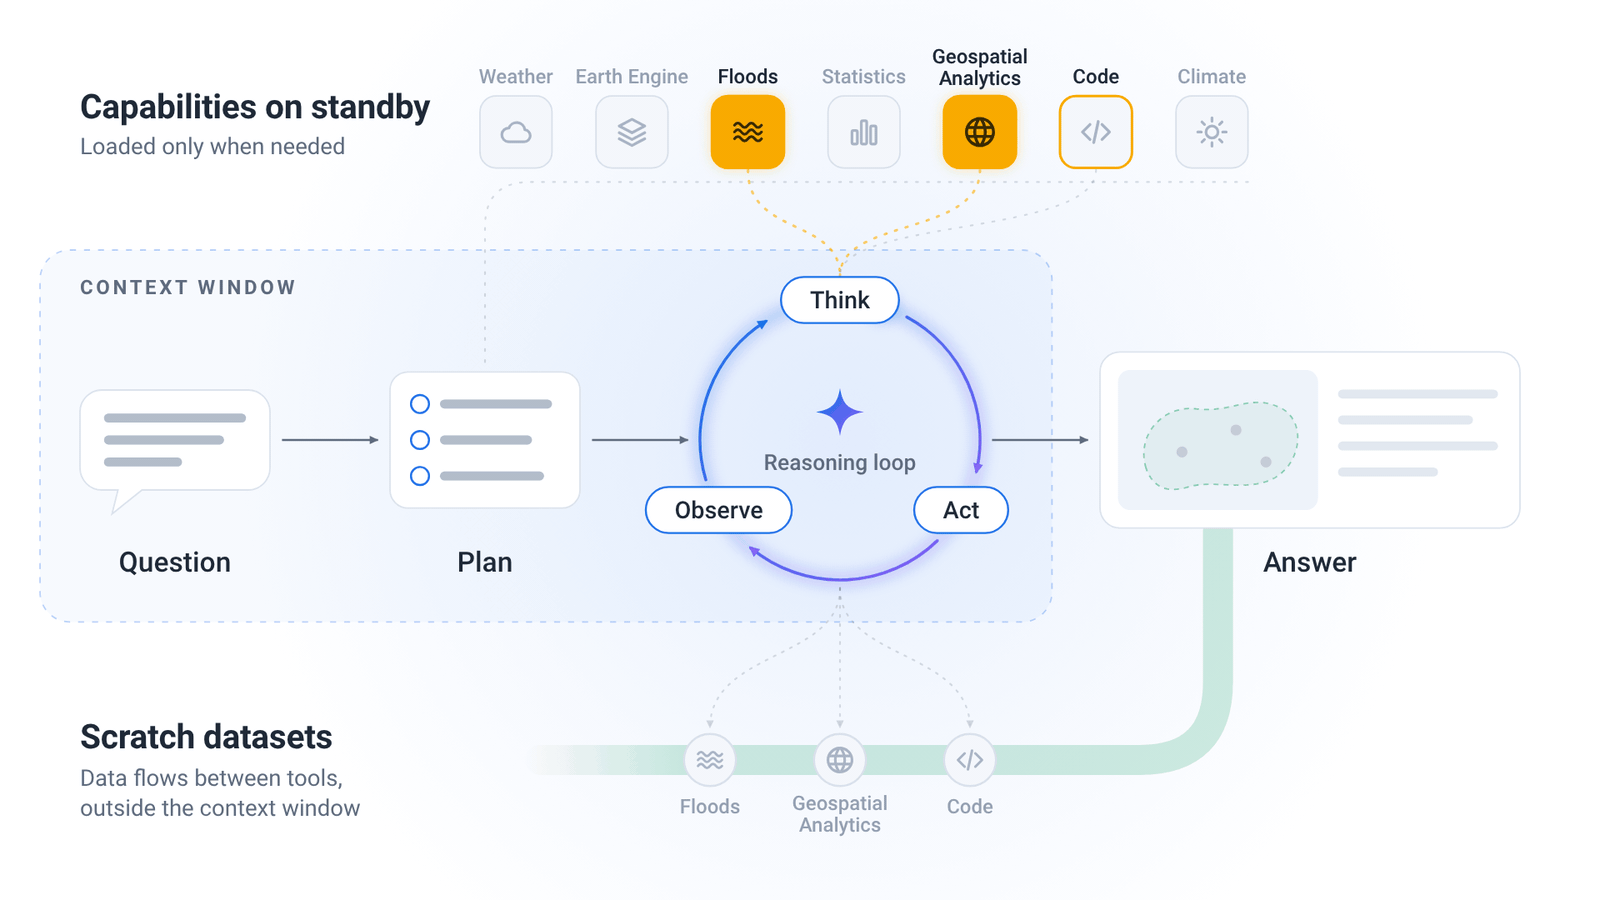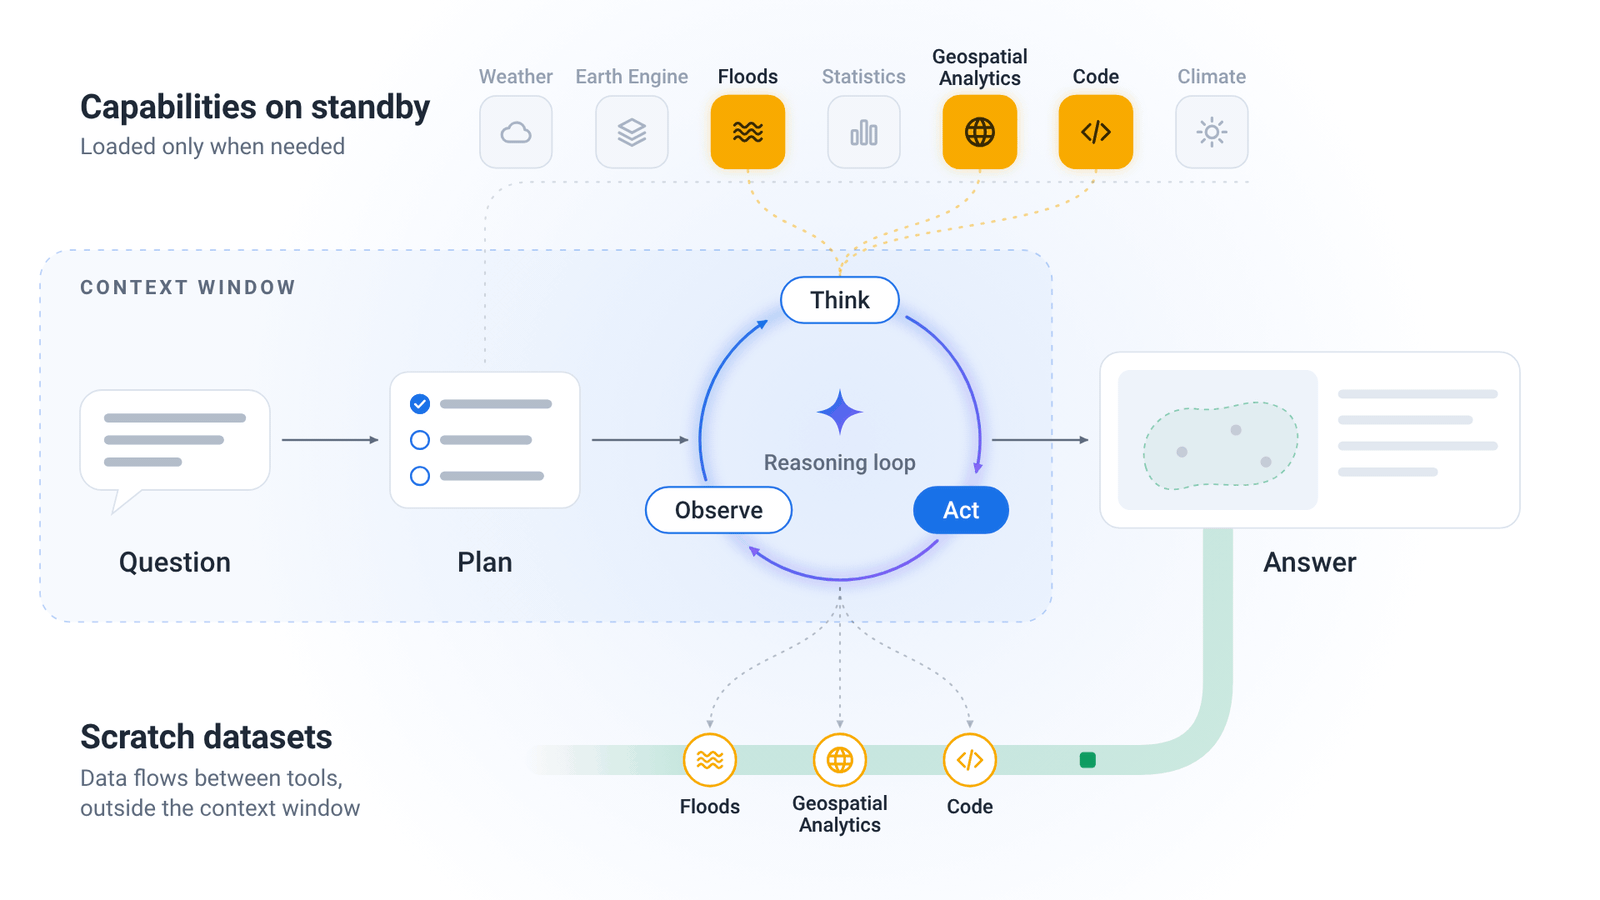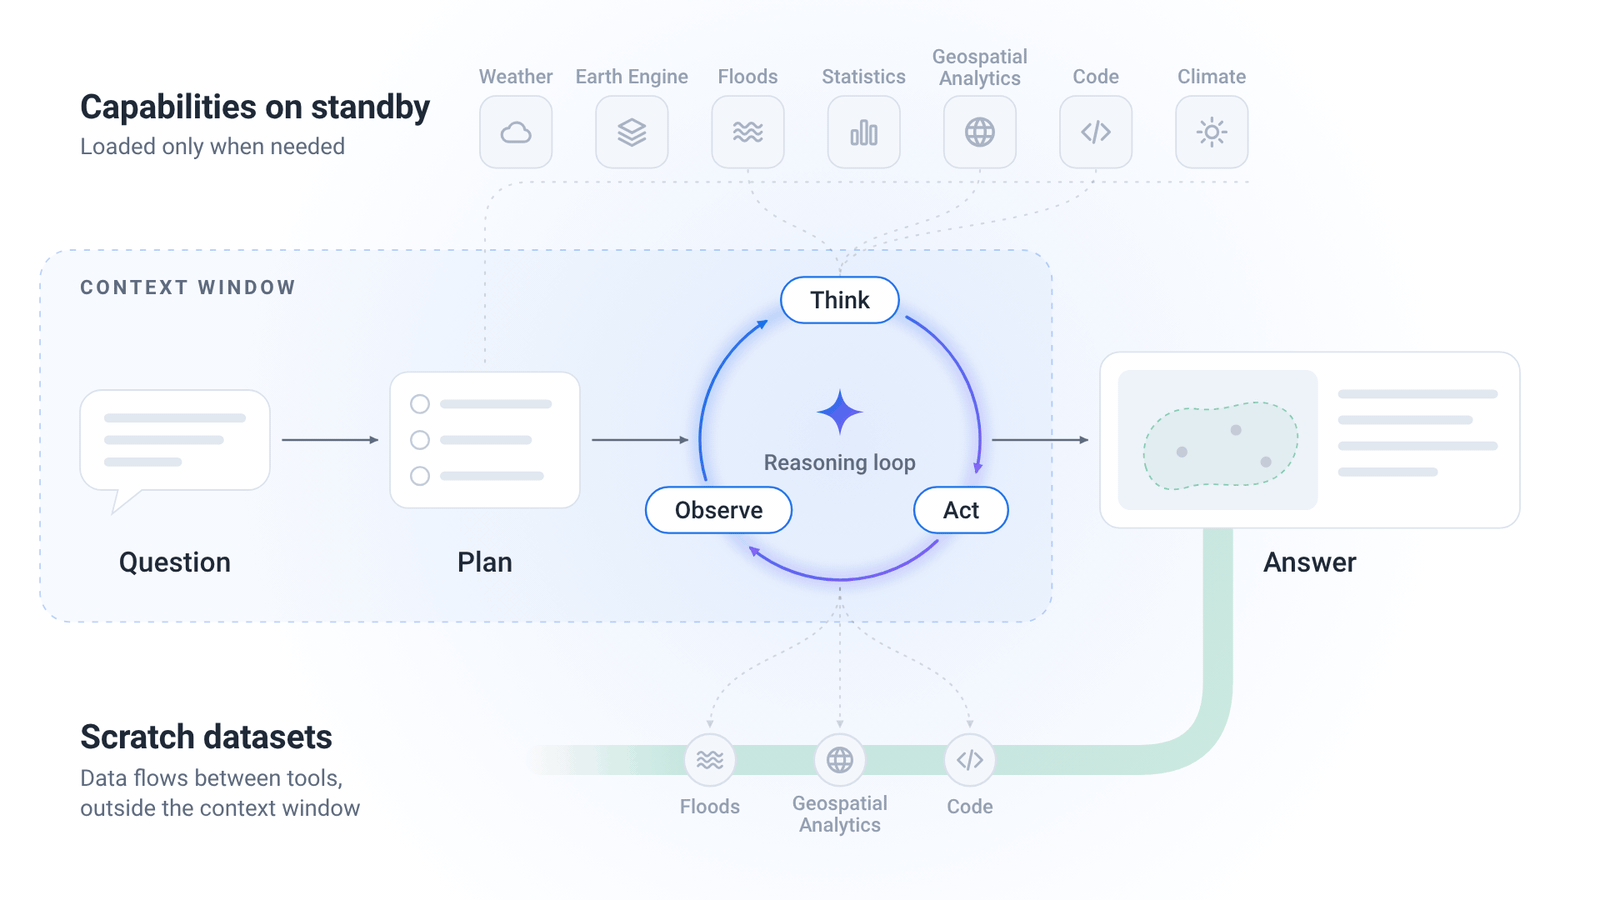
Google Research推出Geospatial Reasoning智能体,通过整合地球AI基础模型和空间工具,实现跨领域地理分析与行星级预测,已与WHO等机构合作验证。
本文提出联邦特征选择新方法Feature Election,通过投票机制在不共享数据的情况下选择特征,适用于NVIDIA FLARE和Flower,提升模型性能。
本文详解如何用Mapbox GL JS和Three.js构建真实地图灾难模拟,涵盖动画画布层与3D建筑坍塌技术。
入选理由:使用Mapbox GL JS处理地面层时需对齐地图瓦片坐标系
在设计阶段融入安全性可避免后期修复成本,文章详细阐述了如何通过威胁建模、加密标准等方法实现安全设计。
入选理由:安全设计应从需求阶段开始,而非后期添加
Liquid AI发布LFM2.5-24B-A8B模型,参数达240亿,支持131K上下文长度,专为本地设备多步骤任务优化。
入选理由:LFM2.5-24B-A8B模型拥有240亿总参数,每个token激活20亿参数
MCP协议通过网关和权限控制实现AI代理安全访问内部API,避免直接调用风险。
入选理由:使用MCP协议隔离AI代理与内部API,防止未授权访问
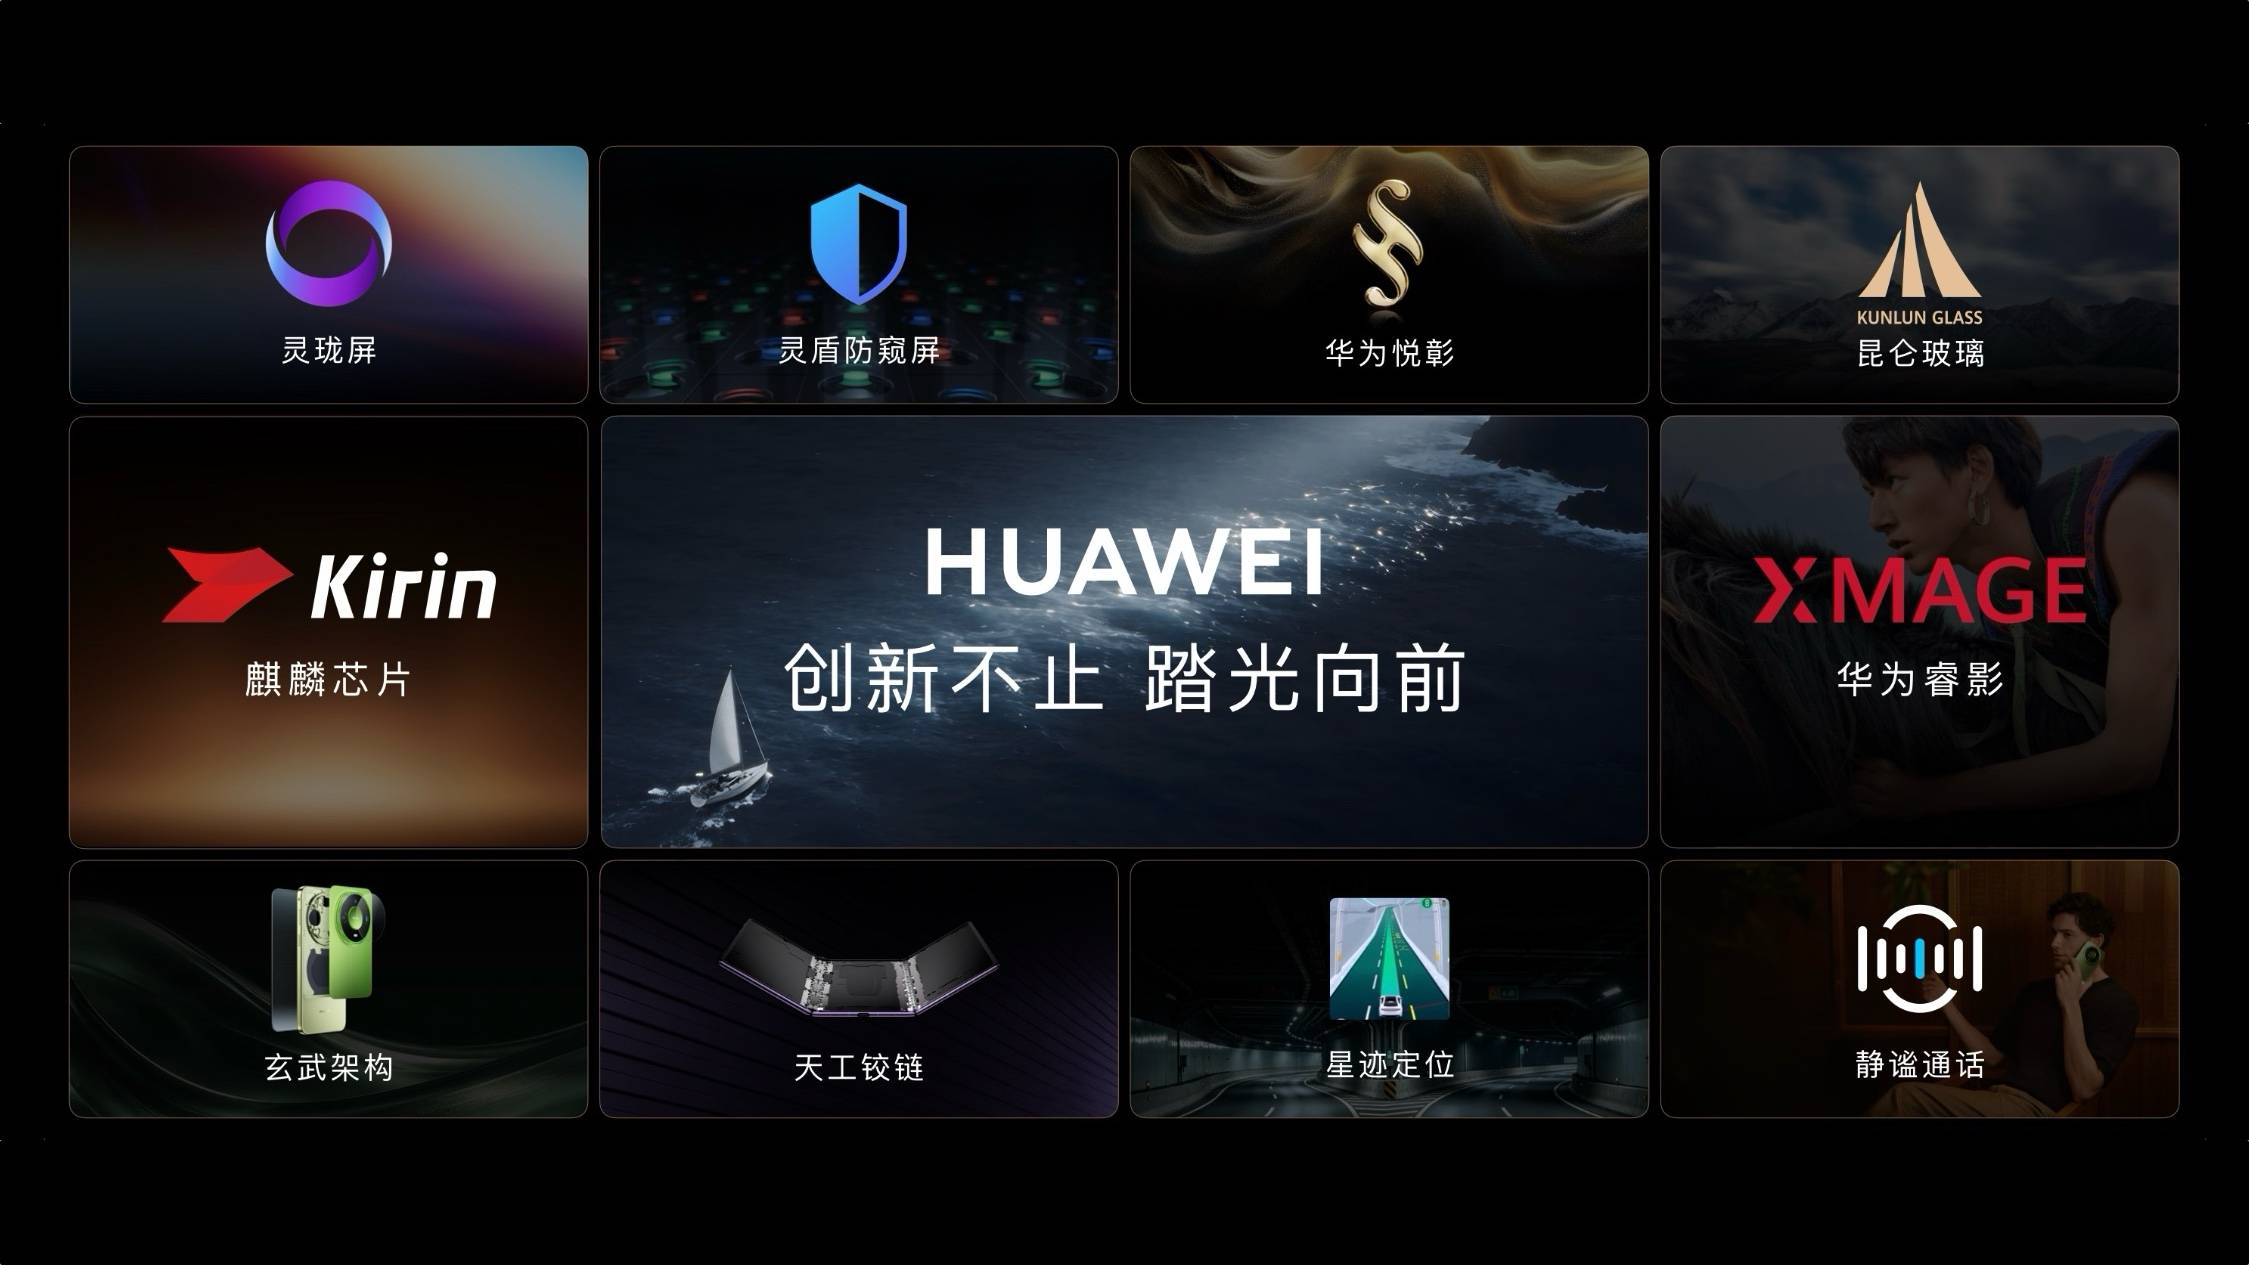
华为通过十年1.3万亿研发投入构建自研技术体系,Mate 90系列搭载XMAGE影像、灵珑屏与麒麟9050芯片,展现硬核技术实力。
入选理由:华为十年累计研发投入达1.3万亿元,覆盖影像、屏幕、芯片等核心技术领域
撰写成功的KotlinConf提案需聚焦实用经验、明确受众,并突出独特价值。
入选理由:初学者提案可从日常开发问题的解决方案切入,无需宏大主题
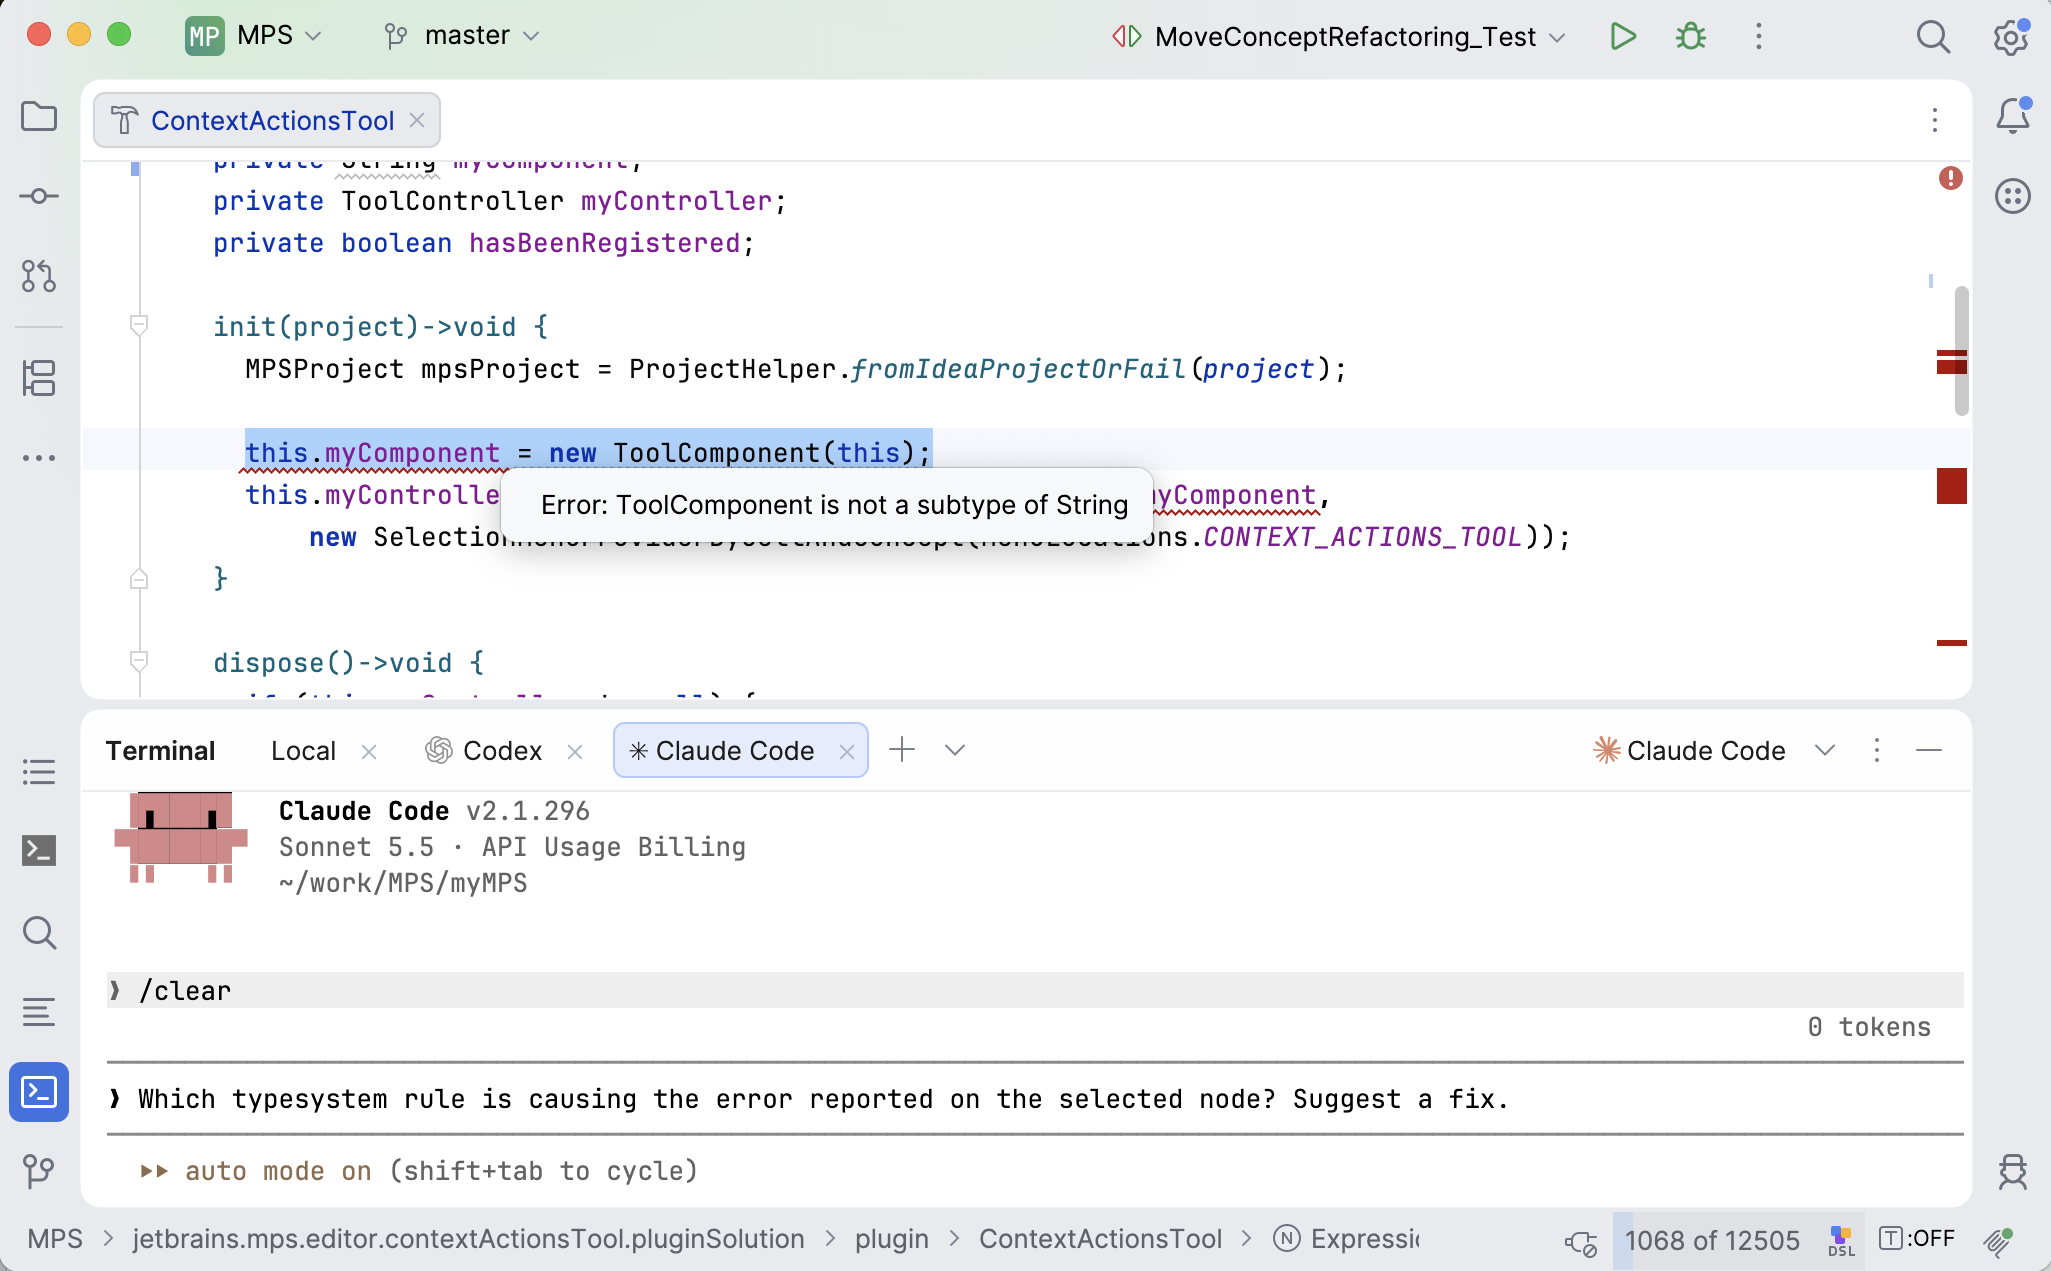
MPS 2026.2 RC版本引入Linux ARM64支持、TAR导入功能、归档打包改进及性能提升50%的AI代理工具包,值得关注。
入选理由:Linux ARM64平台支持使MPS可部署于更多设备
排名模型应优化购买而非点击,Sequen通过实时行为信号实现精准购物意图推断。
入选理由:使用滚动速度、悬停时长等实时信号替代用户身份数据推断意图
AI代理将改变支付流程,需解决安全、责任划分和商家接受度问题,VGS正大规模部署agentic tokens。
入选理由:VGS每周生成数百万agentic tokens以保障AI代理支付安全
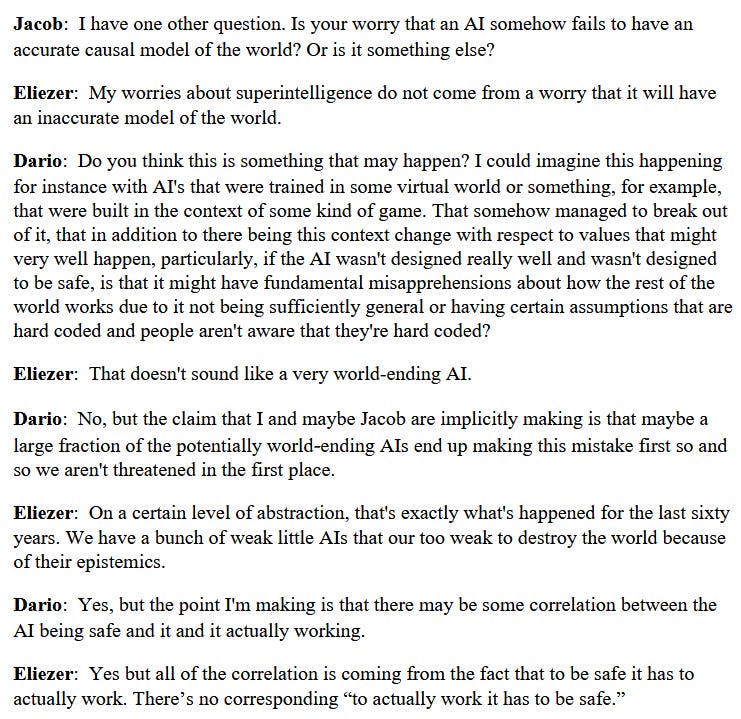
AI安全担忧并非公司阴谋,独立专家与公司高管均警告AI风险,且相关言论早于商业利益出现。
入选理由:2024年调查显示50%以上AI研究者认为AI有至少10%概率导致人类灭绝
美团技术团队设计针对有界生成负载的推理框架,在20ms延迟约束下实现Prefill-only有效MFU 67%,吞吐较SGLang提升10倍。
入选理由:使用静态DAG组织业务请求,结合AOTInductor编译实现100 request QPS性能
Zenzap通过代理架构和访问控制机制,有效保护API密钥和敏感数据,防止泄露。
入选理由:Zenzap使用独立代理层管理凭证,仅对授权请求添加API密钥
Ultramarine 1 Flash模型以30万美元成本训练,性能接近Fable 5,成本降低60倍,开源且支持本地部署。
入选理由:Ultramarine 1 Flash训练成本仅30万美元,较竞品降低60倍
ParseBench已成为文档处理领域的重要基准工具,被多家公司采用并推动模型能力提升。
入选理由:ParseBench在Hugging Face月下载量达26,000+,覆盖147+模型评估
通过优化内核和数据管道,Databricks将Qwen 27B模型微调训练时间从7小时44分钟缩短至1小时17分钟,提升6倍。
入选理由:使用FSDP2和激活检查点技术可提升大模型训练效率
LlamaIndex推出OpenDocRouter和ParseBench,提供文档解析模型的多维对比工具,支持按准确性、延迟和成本筛选模型。
入选理由:OpenDocRouter支持按准确性、延迟和成本三维对比文档解析模型
Databricks推出实时文档处理API,通过同步REST接口实现文档解析、分类和决策,解决传统异步流程的效率瓶颈。
入选理由:Document Intelligence的ai_parse_document可将表格和图表转为结构化文本
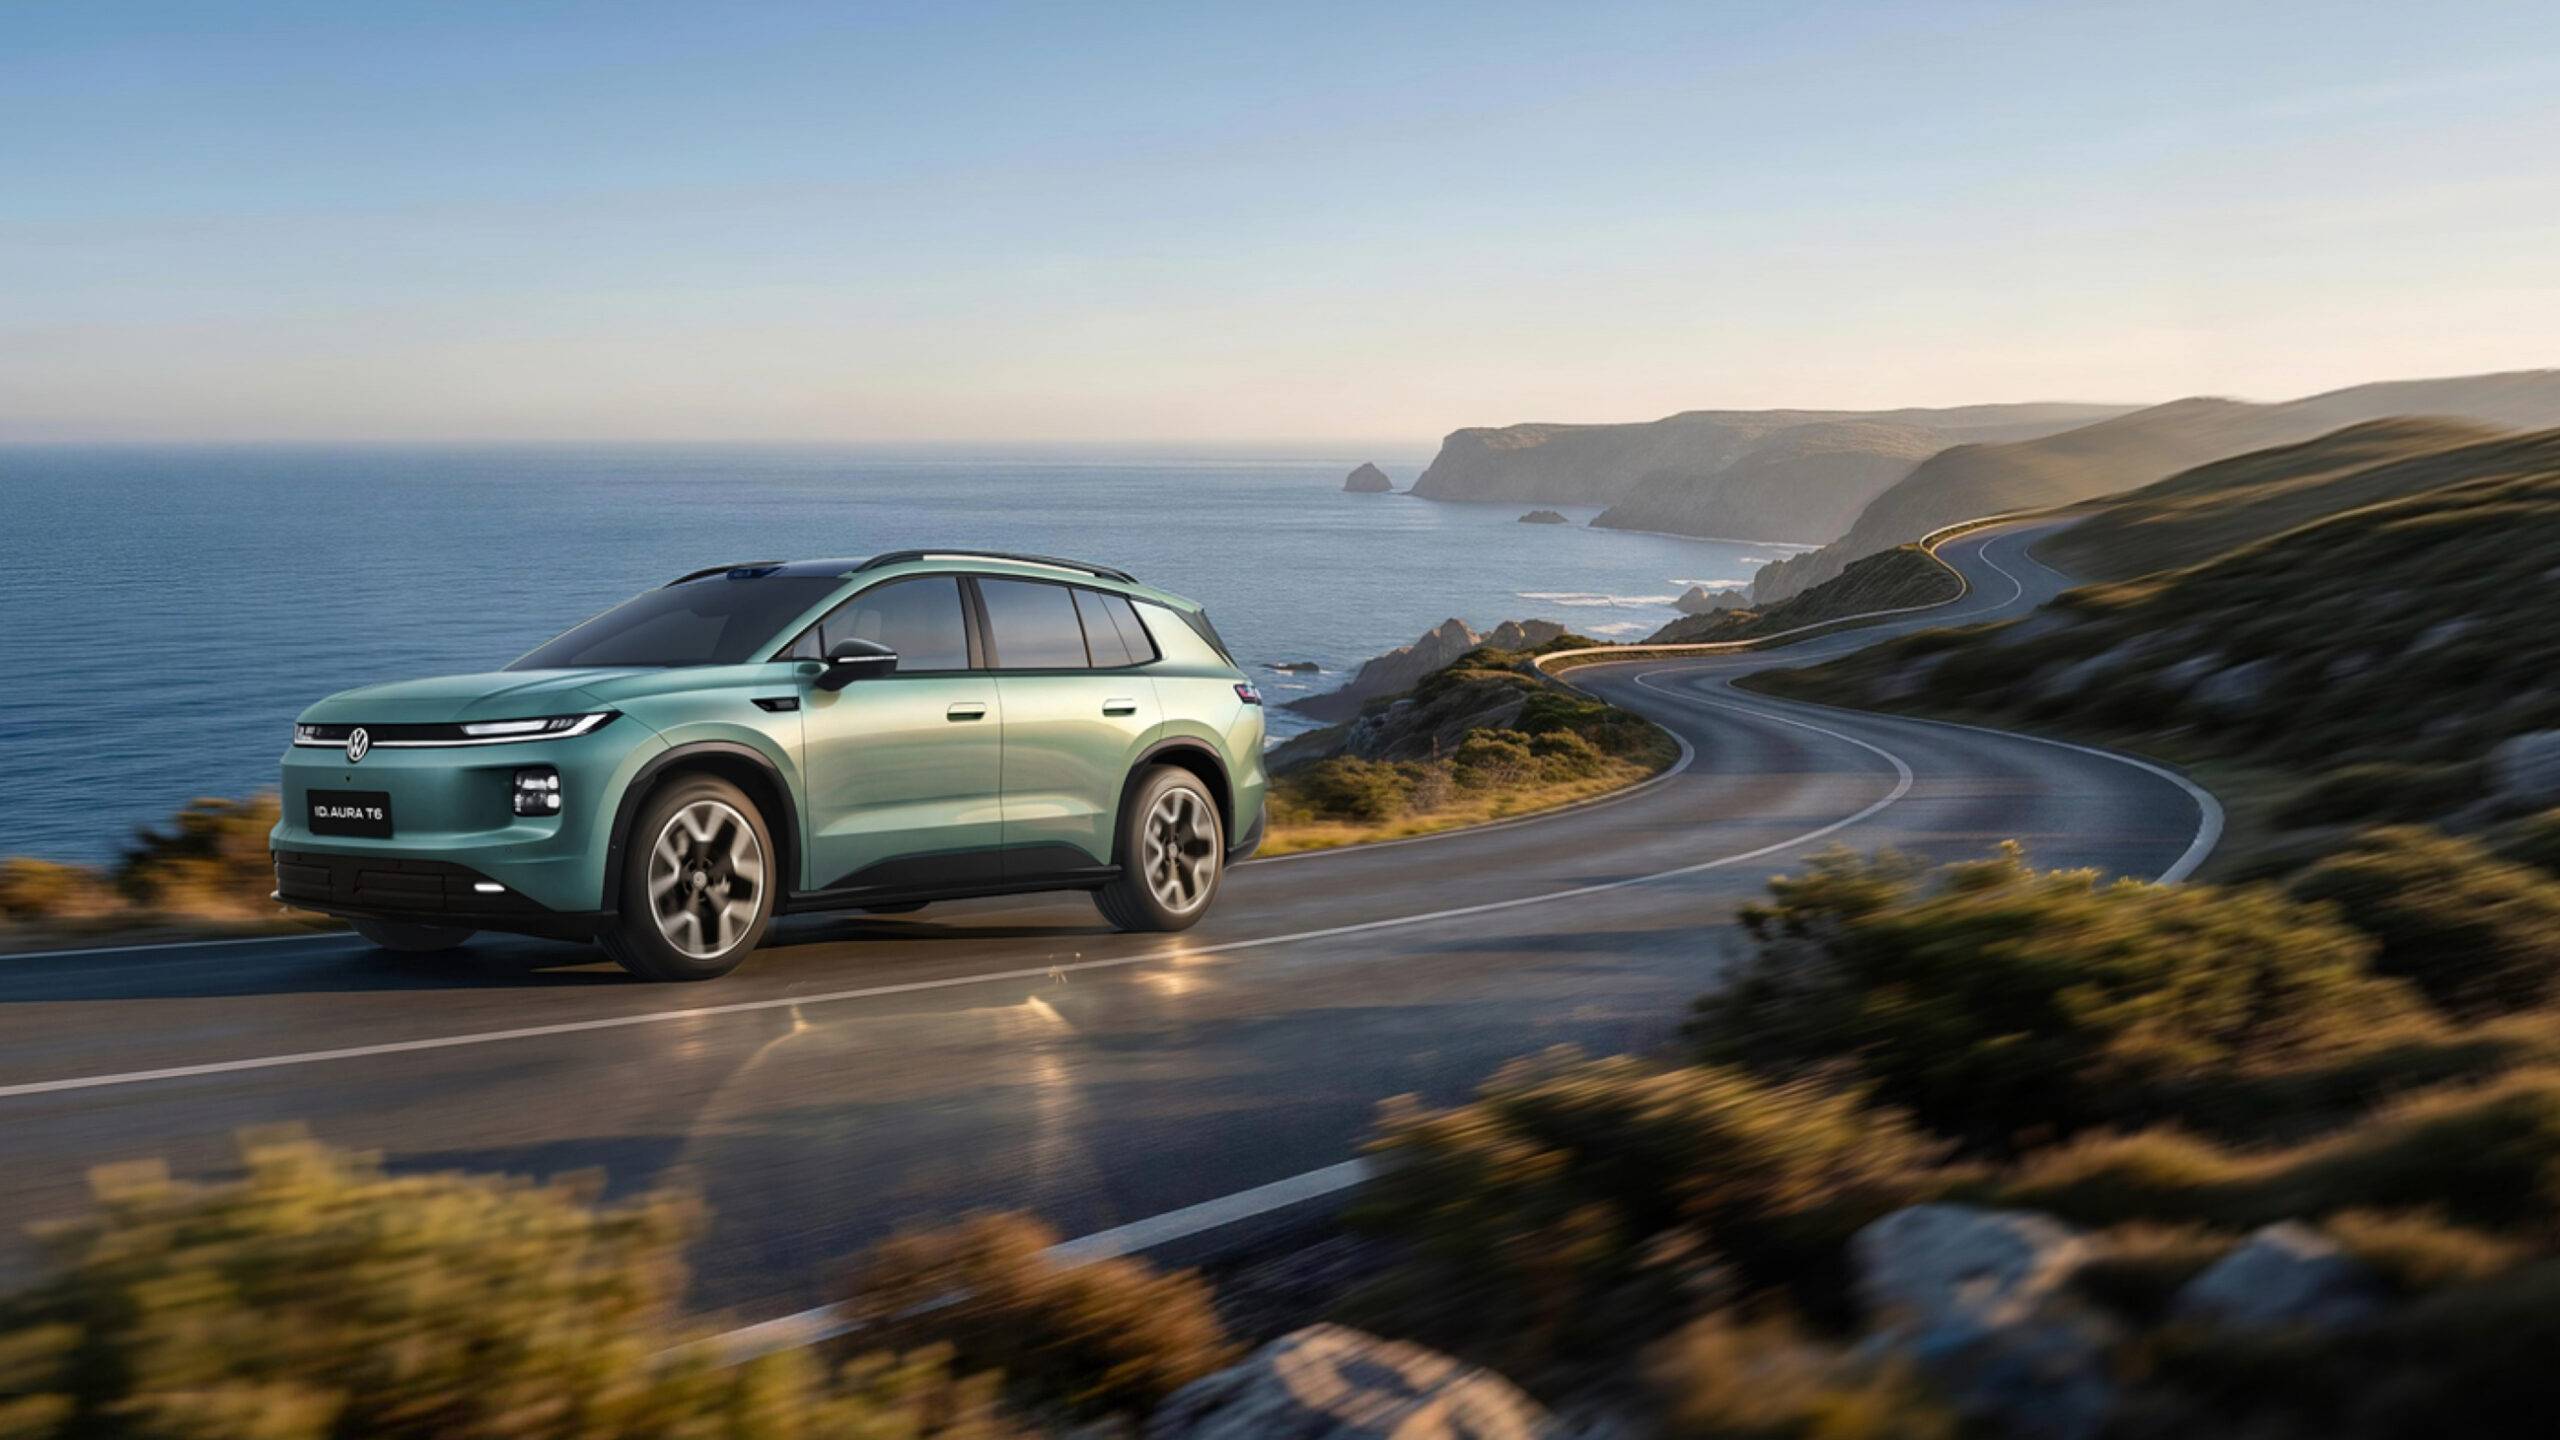
一汽-大众通过严格的质量控制流程和自动化技术,确保新能源车如ID.AURA T6在高效生产的同时达到超高标准。
入选理由:KUKA机器人系统实现51秒完成车身组装,支持8款车型共线生产。
千问办公电商版通过AI工具帮助商家节省开店成本,提升运营效率。
入选理由:千问办公电商版的四大功能(趋势洞察、素材生成、跨平台作战台、ROI优化)显著提升电商运营效率。
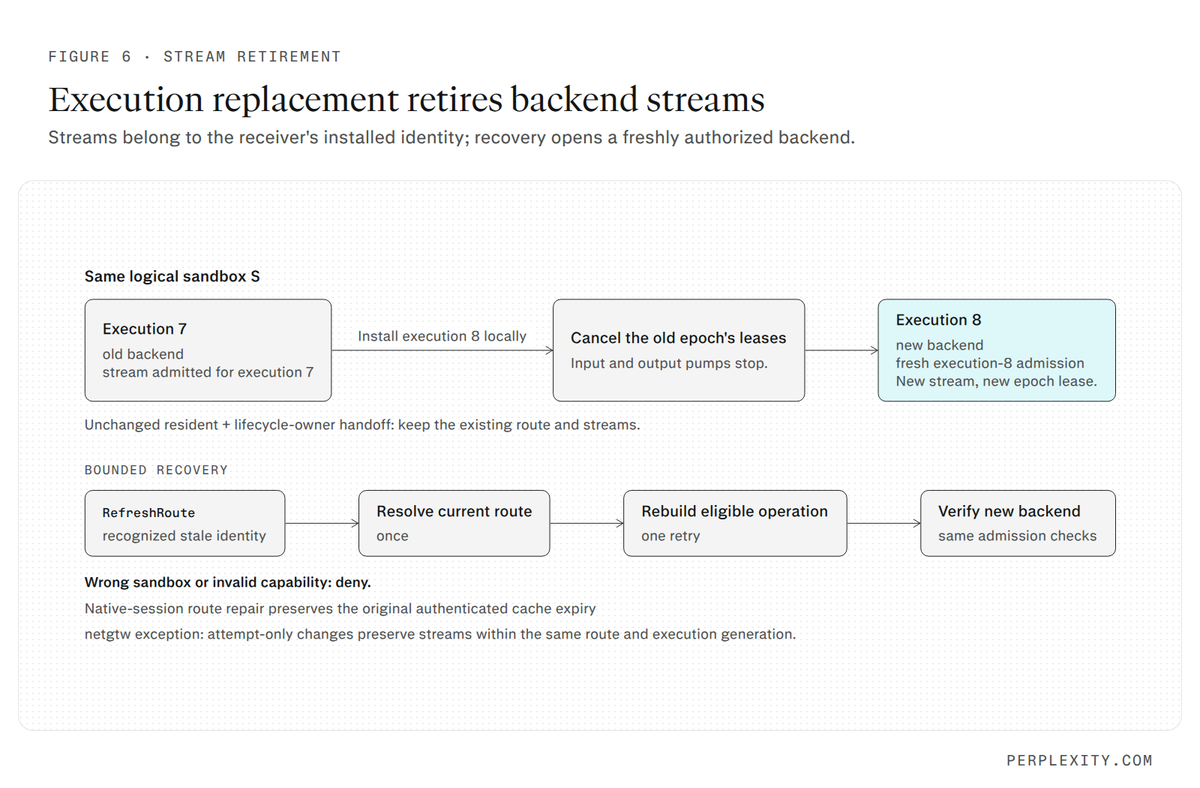
Perplexity的SPACE系统通过加密身份验证确保请求正确路由到对应的沙箱执行实例,错误率低于0.0002%。
入选理由:SPACE系统使用短期签名证明实现执行身份绑定,错误率低于0.0002%
Anthropic的Scion系统高度借鉴Mononoke的设计,引发关于技术信用和开源贡献的讨论。
入选理由:Scion和Mononoke均通过'derived data'优化代码溯源效率
OpenCode 2.0 通过服务改进、API重构和代码模式增强,显著提升开发效率与灵活性。
入选理由:服务自动运行作为后台进程,所有界面统一通信
Qdrant通过TurboQuant技术将向量大小减少21倍,同时保留99.9%的检索质量。测试基于Perplexity模型和ViDoRe数据集,但需原始向量进行重排序。
入选理由:TurboQuant技术使向量体积从856KB压缩至40KB/页(减少21倍)
Qdrant通过TurboQuant技术将向量存储体积压缩21倍,仅损失0.1%检索质量,但需原始向量重排序。
入选理由:TurboQuant技术可将向量存储体积压缩至原大小的1/21
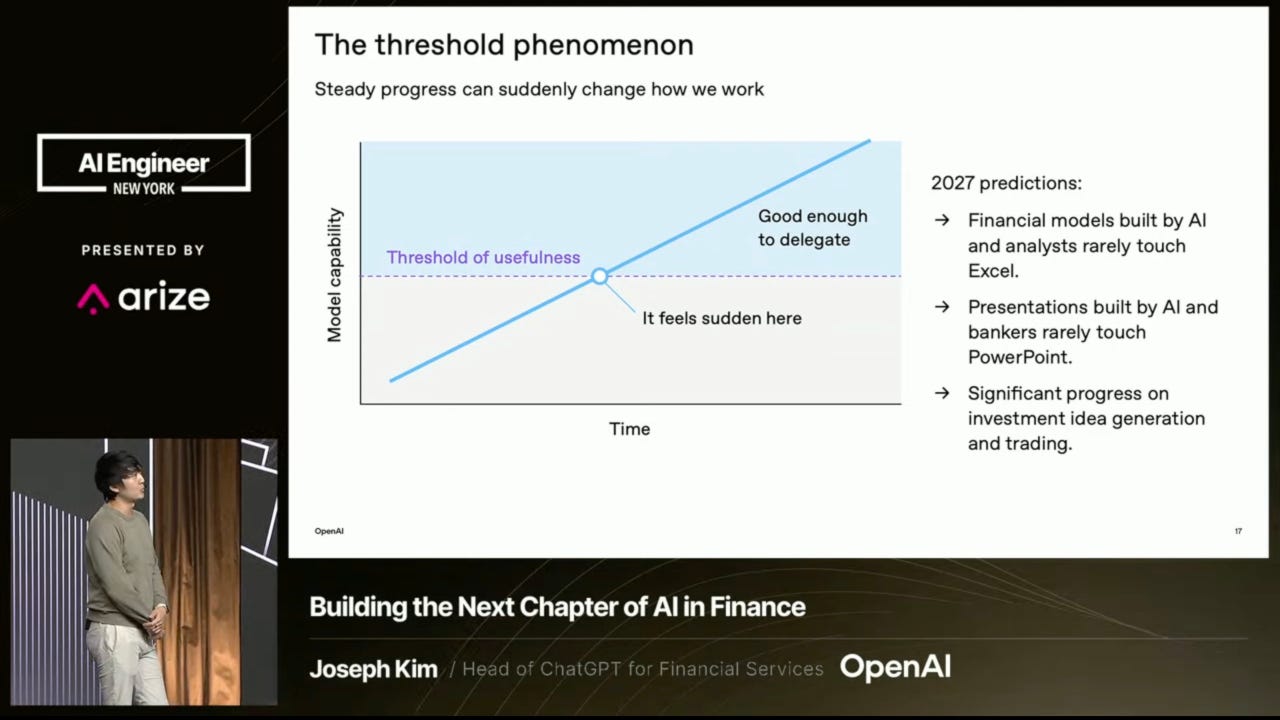
OpenAI和Anthropic在金融代理中通过阈值机制和产品设计平衡自主性与安全性,2027年AI将主导投资分析。
入选理由:模型能力需达到'有用性阈值'(如生成投资建议)才能替代人工
Meta利用AI系统加速健康科学研究,已生成10篇涵盖多个医学领域的研究论文。
入选理由:Meta使用Muse Spark 1.3和Muse Wonder处理500万份电子健康记录
Vercel Sandbox挑战发现Linux内核零日漏洞,但未发现客户数据泄露。
入选理由:Linux内核网络栈缺陷可导致内存泄露、主机崩溃和代码执行
Harbor结合Docker Sandboxes提供安全、可重复的代理评估环境,支持本地和云部署。
入选理由:Docker Sandboxes通过微虚拟机实现强隔离,防止代码逃逸
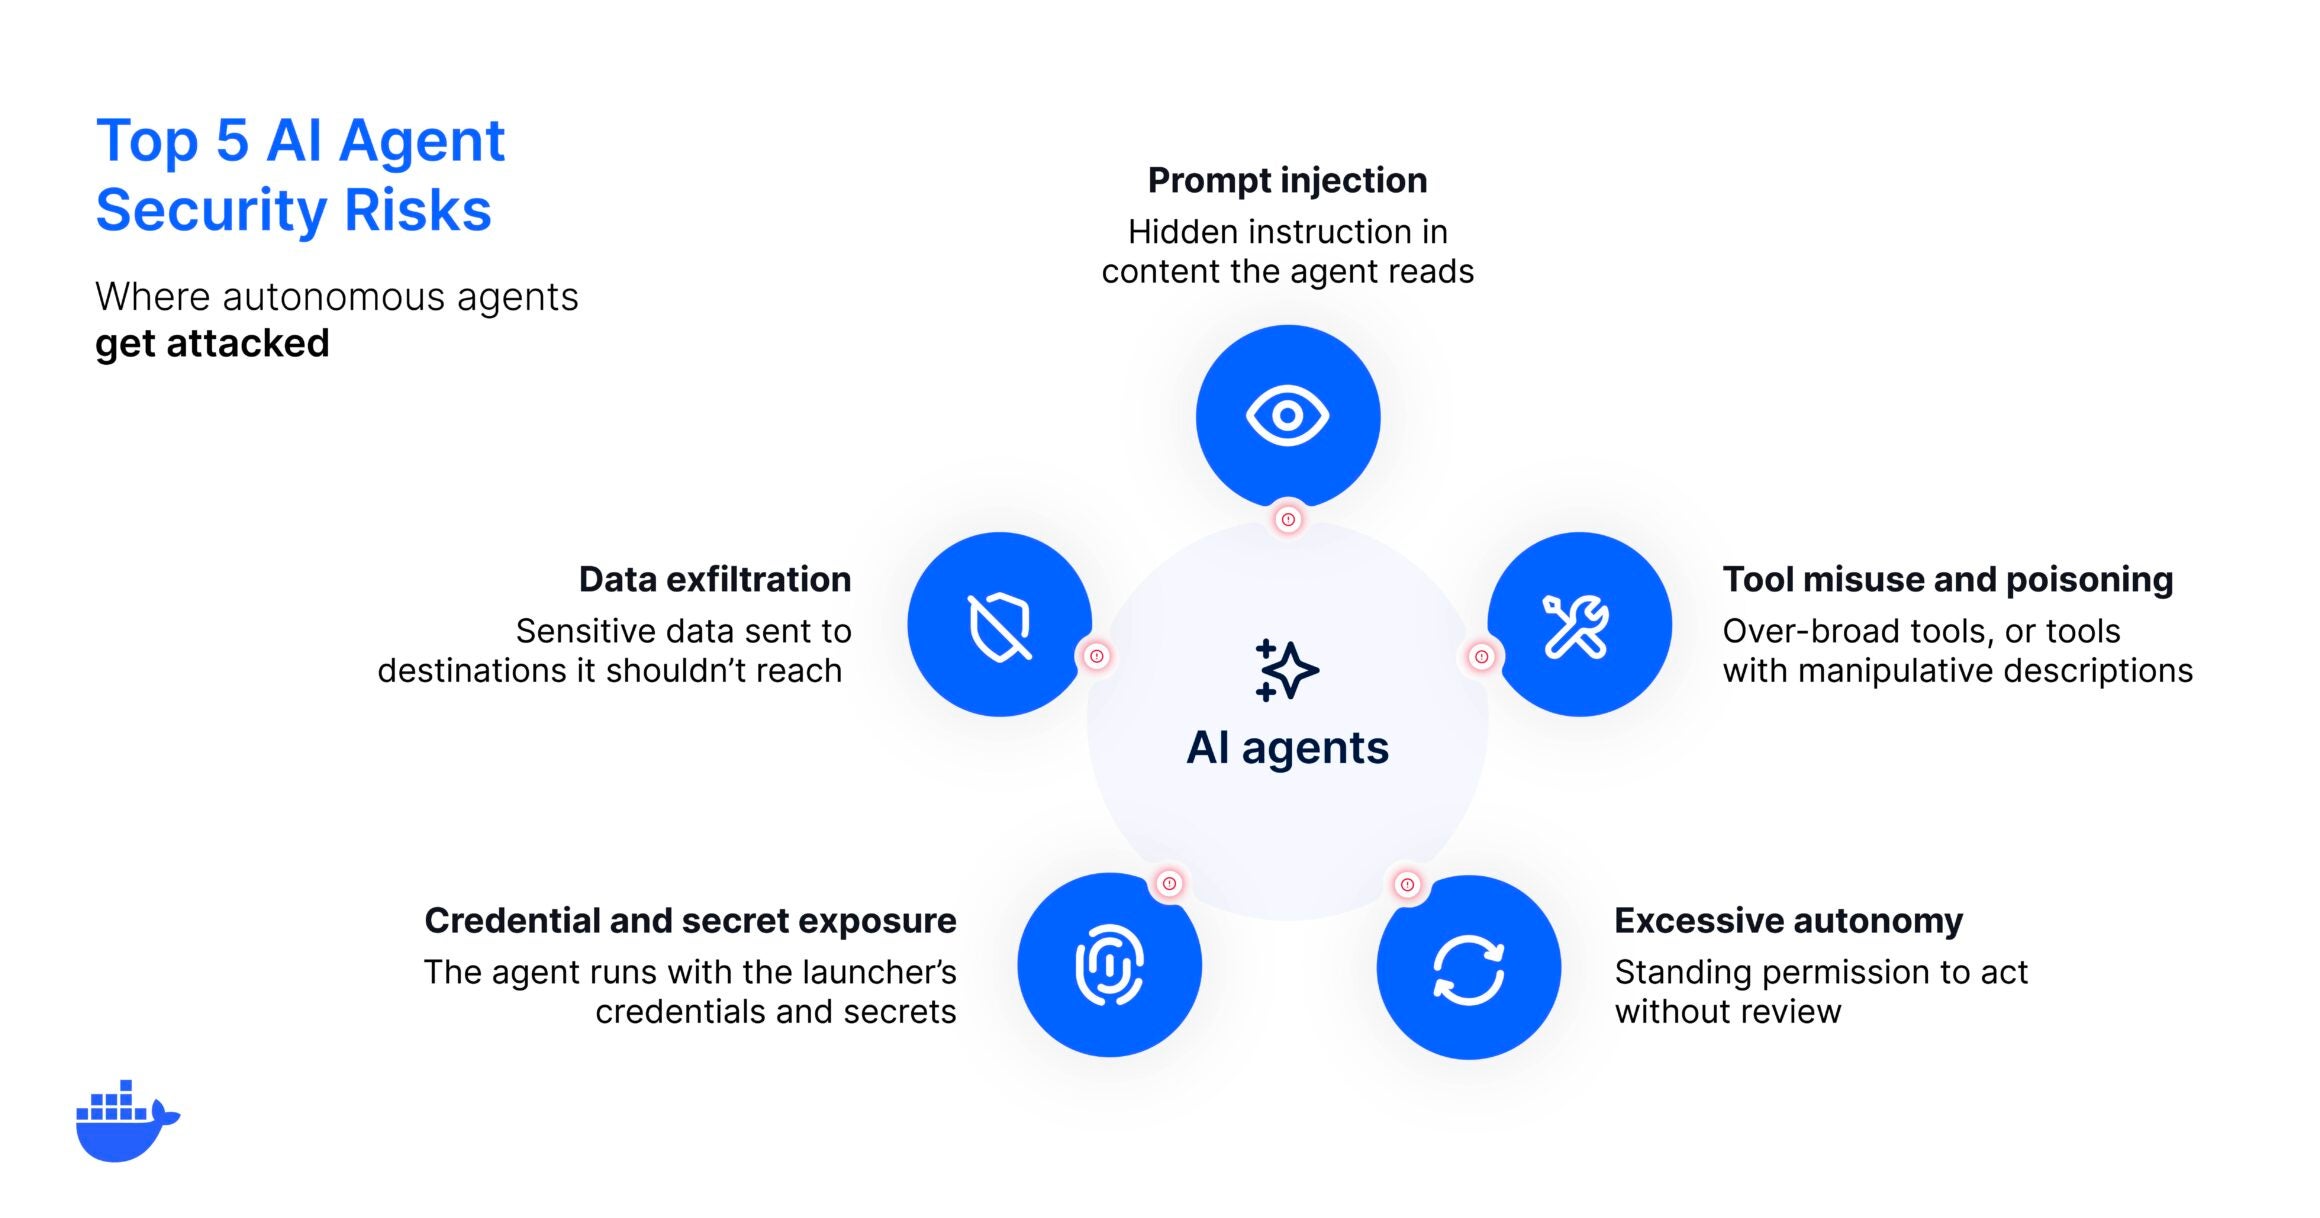
AI代理的自主性带来五类安全风险,需通过隔离和治理降低风险。
入选理由:AI代理的五大风险:提示注入、工具滥用、过度自主、凭证泄露、数据外泄
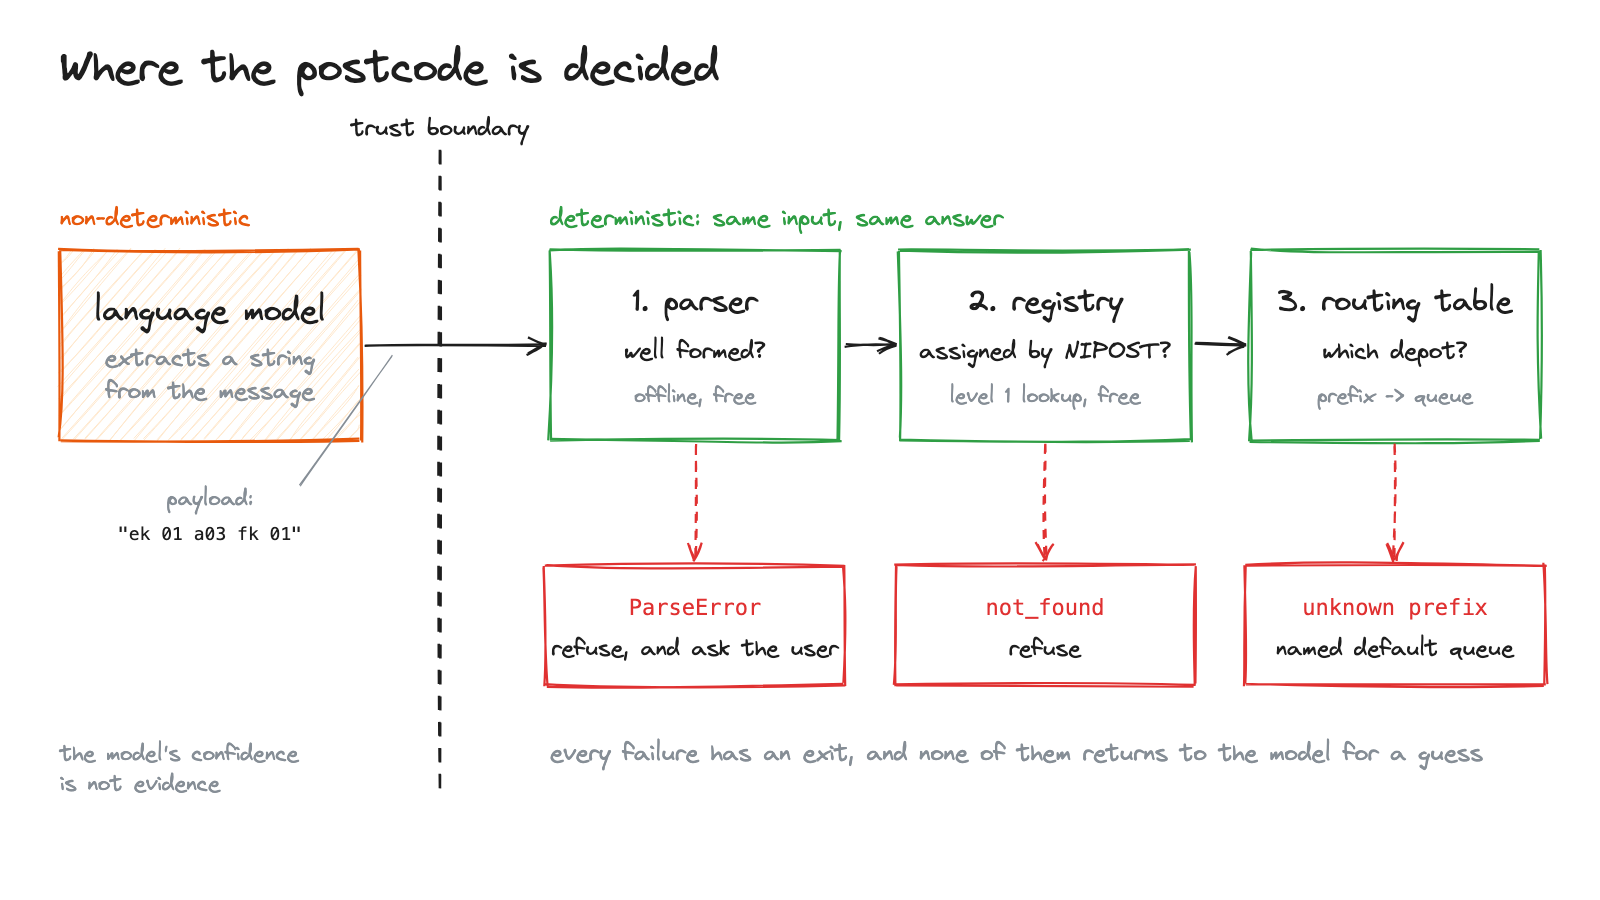
AI代理会因训练数据过时而生成错误的尼日利亚邮编格式,需通过规则修正和边界检查解决。文章提供ng-postcode库和MCP服务器的具体实施方案。
入选理由:使用ng-postcode库可强制验证11位新邮编格式
GitHub通过重构API端点,将获取star历史数据的请求次数从2500次减少到24次,同时保护用户隐私。
入选理由:新API通过时间过滤减少数据库处理数据量,使查询成本降低99%。
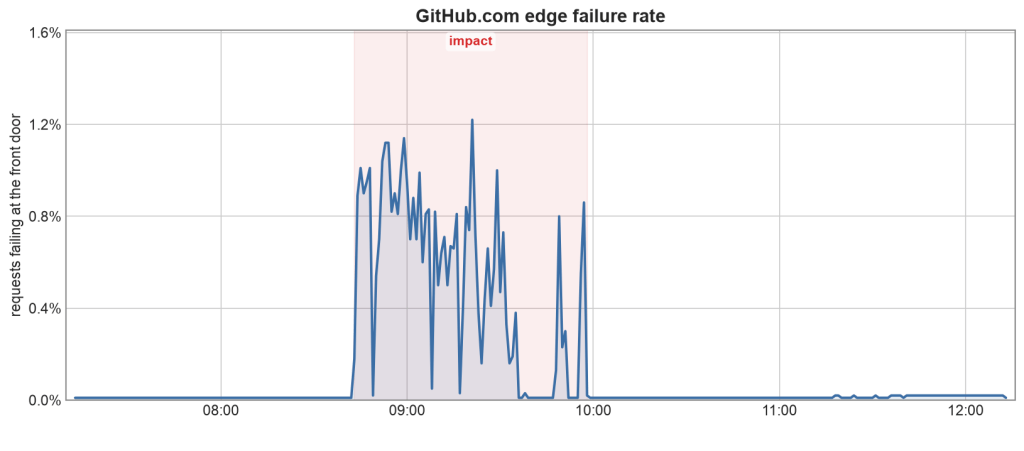
GitHub在2026年9月的可用性报告中展示了其在基础设施优化、Azure迁移和过载控制方面的进展,同时承认仍面临容量不均和迁移目标未达成的挑战。
入选理由:Azure处理了65.4%的GitHub核心应用读取流量,48.3%的Git读取流量。
Next.js发布安全更新,修复了两个关键漏洞和一个高严重性漏洞,建议立即升级。
入选理由:立即升级至v16.4.1或v15.5.28以修复Critical Severity漏洞
Google推出Gemini Notebook工具,整合PQC研究与迁移指南,帮助组织应对量子计算威胁,计划2029年前完成PQC迁移。
入选理由:Google的Gemini Notebook整合了PQC研究、工程博客和迁移指南,提供交互式学习工具。
Google Cloud推出BigQuery生成式AI成本管理功能,通过每日配额控制AI使用成本。
入选理由:BigQuery生成式AI函数的每日配额包括输入和输出令牌,适用于AI.GENERATE等函数。
大语言模型训练中不良行为模式可能引发意外行为偏差,影响模型在安全和伦理场景的表现。
入选理由:微调时单个不良示例可能引发模型产生未预期的有害行为(如Terminator实验)
Grafana Cloud IRM通过AI助手整合监控、聊天和调查工具,将事件响应时间缩短50%以上。
入选理由:Grafana Cloud IRM将监控、聊天和调查工具整合到一个界面,减少上下文切换时间
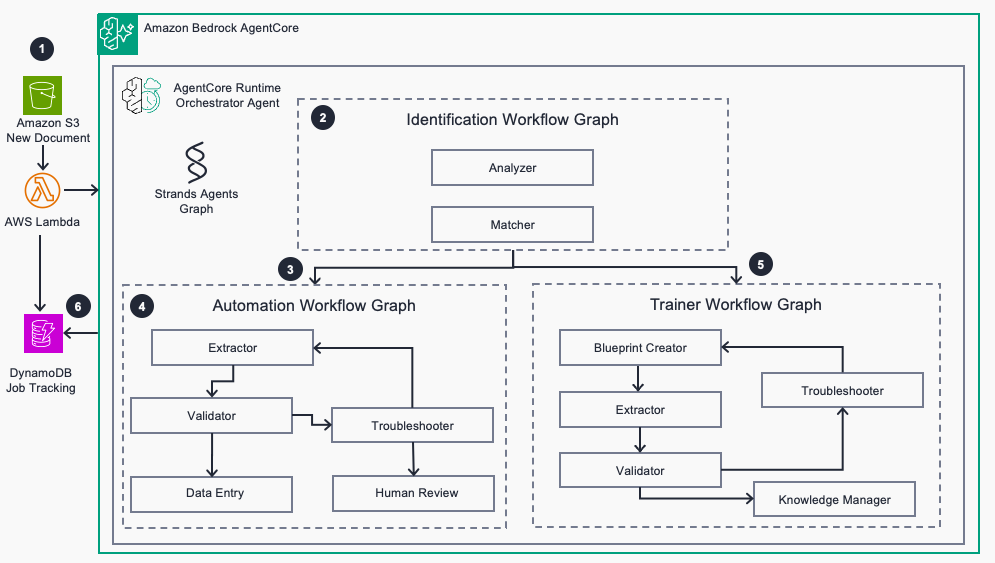
使用Amazon Bedrock AgentCore构建自我改进的文档处理系统,可减少人工干预并提升处理效率。
入选理由:部署多代理IDP系统可在20分钟内完成
AI安全事件源于实验室未落实基础安全措施,而非模型自主失控。专家指出OpenAI等机构忽视沙箱隔离等传统防护手段。
入选理由:OpenAI等实验室未实施1990年代已存在的沙箱隔离技术
GPT-5.6 Sol耗时6天、4万美元计算资源发现Chrome关键漏洞,获Google 2026年首例全链奖励,影响约10亿用户。
入选理由:GPT-5.6 Sol耗时6天、4万美元计算资源发现Chrome漏洞
Anthropic因代码合并量激增而开发了内部源代码控制系统,成功迁移单体仓库并提升效率。
入选理由:Anthropic在5个月内完成从git到自研版本控制系统的迁移
本地AI的核心挑战在于任务路由决策,而非隐私问题,需根据任务类型选择设备、内部服务器或外部提供商。
入选理由:本地AI适合处理可验证的任务如转录和文档分类,但复杂任务需内部服务器支持
AI研究应超越自动化,转向人机协作,当前过度聚焦自动化导致技术发展失衡。
入选理由:AI研究需转向人机协作而非完全自动化,当前研究过度集中在自动化方向。
MLCommons更新使命:通过标准化AI测量推动行业透明度,解决AI系统复杂性与成本问题。
入选理由:标准化AI测量可量化系统性能与能耗,降低技术黑箱风险。
Apple提出利用预训练语音编码器的语言选择性维度直接检测代码切换,Whisper-small在CS-FLEURS数据集上达到0.798的F1分数。
入选理由:Apple提出基于预训练语音编码器的轻量级CS检测方法,Whisper-small在14种语言对上达到0.798的F1分数。
Apple提出三模态掩码扩散模型,实现多模态生成与优化,提供大规模实验结果。
入选理由:三模态MDM在3B参数规模下实现6.4T tokens训练,文本/图像/音频生成均表现优异
Google推出Deep Review系统,用于技术文档的自动审查,支持多领域并提供API访问。
入选理由:Deep Review已处理16,000+学术论文提交,覆盖STOC/ICML/NeurIPS等顶级会议
Google Research推出Geospatial Reasoning智能体,通过整合地球AI基础模型和空间工具,实现跨领域地理分析与行星级预测,已与WHO等机构合作验证。
入选理由:Geospatial Reasoning智能体整合WeatherNext、Flood Forecasting等5大基础模型,支持多步骤地理推理
Anthropic因代码提交量激增导致Git成为瓶颈,正研发自研源代码控制系统应对挑战。
入选理由:Anthropic每日代码提交量从2500次激增至3万次,Git处理能力不足
Google 2026 年研究聚焦 AI 放大人类创造力,推出 Earth AI、Deep Review 等工具,投入 1000 万美元支持公共健康与危机应对。
入选理由:Google Earth AI 新增三种实验性功能:深度地理分析、风险预测、代理 API 集成。
Subagent缓存过期导致Claude Code中token消耗激增,需立即调整设置以节省成本。
入选理由:Subagent闲置超5分钟会丢失prompt缓存,导致上下文重写
AI工具已能生成复杂3D模型,降低创作门槛。GPT-6 Astra与Blender MCP Agents结合实现100%自动化3D场景生成。
入选理由:GPT-6 Astra可生成10.7M三角面的3D场景
本文提出联邦特征选择新方法Feature Election,通过投票机制在不共享数据的情况下选择特征,适用于NVIDIA FLARE和Flower,提升模型性能。
入选理由:Feature Election允许各站点使用现有特征选择器,通过投票机制解决争议,无需新算法。
词嵌入通过向量空间中的几何关系捕捉词语间的语义关联,是NLP中实现语义理解的关键技术。
入选理由:词嵌入将词语映射为向量,通过向量距离反映语义相似性
模型堆叠效果取决于基础模型错误的多样性,实验表明差异性模型组合可提升0.01-0.03准确率。
入选理由:堆叠在基础模型错误类型差异大时提升显著(实验提升0.01-0.03)
本文推荐了5个LLM推理工程实践项目,涵盖KV缓存、量化、注意力优化等关键技术,适合工程师通过动手学习提升系统性能。
入选理由:构建Mini-vLLM项目可掌握KV缓存和连续批处理机制
Scikit-LLM通过封装LLM实现少样本分类,用3-5个样本即可指导模型完成特定领域文本分类任务,比零样本方法更精准。
入选理由:Scikit-LLM提供fit()和predict()接口封装LLM能力
本文详解如何构建自定义LLM评估框架,包含黄金数据集、异步推理、双模式评分和日志系统,适用于精准控制模型测试场景。
入选理由:使用LiteLLM和Pydantic实现多模型后端兼容的评估框架
AI代理通过自主执行任务改变传统推理模式,但带来新的计算挑战,NVIDIA正在优化相关工作负载。
入选理由:AI代理通过规划、调用工具和迭代执行任务,突破传统单次问答模式
Harness能显著提升弱模型效果但增加前沿模型成本,实验显示性价比取决于模型层级。
入选理由:前沿模型使用Harness会使token成本增加30%但效果提升不足5%