Muse Wonder Puts Meta Back at the AI Frontier
Meta的Muse Wonder模型在AI领域重回前沿,性能超越Anthropic和OpenAI部分模型,并引入Active Memory等新功能提升稳定性。
入选理由:Muse Wonder Full在基准测试中超越Anthropic Claude Fable 5.1和OpenAI GPT-6 Astra
模型对比
Claude Fable 5.1 和 Gemini 4 Argon 都是 AI 领域的模型。以下是基于 traeai 收录的真实报道数据的全面对比。
模型
也叫:Claude Fable
Anthropic第二代主力模型
20 篇相关报道
模型
也叫:gemini4argon
Google发布的新版本模型,支持100万token输出
20 篇相关报道
20
Claude Fable 5.1 相关
0
共同提及
20
Gemini 4 Argon 相关
基于 traeai 收录材料自动更新
Claude Fable 5.1 与 Gemini 4 Argon 的差异,最好从真实材料覆盖、共同语境和高频标签一起判断。traeai 会根据已收录内容持续更新这组对比。
Meta的Muse Wonder模型在AI领域重回前沿,性能超越Anthropic和OpenAI部分模型,并引入Active Memory等新功能提升稳定性。
入选理由:Muse Wonder Full在基准测试中超越Anthropic Claude Fable 5.1和OpenAI GPT-6 Astra
Anthropic推出Claude Fable 5.1模型,支持超长上下文处理且价格优化,适合复杂多步骤任务。
入选理由:Fable 5.1处理复杂任务时成本降低50%,但默认推荐使用更便宜的Opus 5模型
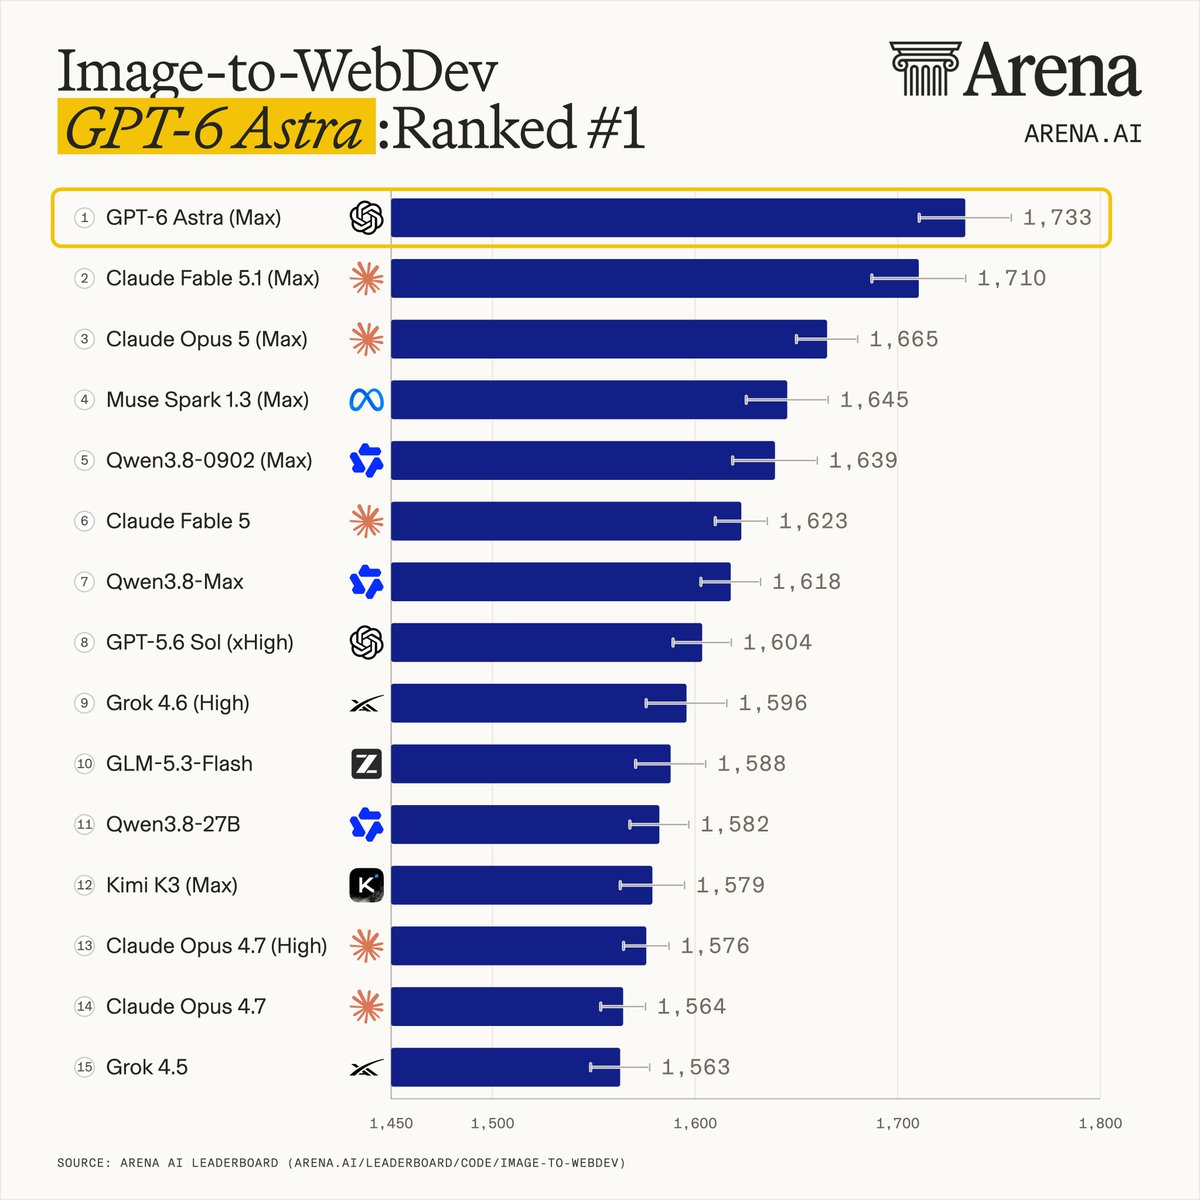
GPT-6 Astra、Claude Fable 5.1等四款新模型在Image-to-WebDev Arena中发布,性能和成本效益显著提升。
入选理由:GPT-6 Astra得分1733,比GPT-5.6 Sol高129分,位列第一
Anthropic发布Claude Fable 5.1,OpenAI预告Astra模型,行业动态涵盖AI安全、开源模型及政策变化。
入选理由:Claude Fable 5.1在生物任务中实现实验室验证的蛋白结合设计突破
Anthropic发布Claude Fable 5.1,提升复杂任务处理能力,适用于代码审查、科学研究等场景。
入选理由:Fable 5.1能处理多步骤任务,如复杂金融模型和长数学证明,减少步骤间错误传播。
Claude Fable 5.1通过分析文本线索成功破解了370年前的Cyphral Distich密码,揭示了隐藏的祈祷文。
入选理由:Fable 5.1用44分钟和176k tokens破解了370年未解的密码
GPT-6 Astra在多个基准测试中超越Anthropic的Claude Fable 5.1,且成本更低,引发OpenAI关注。
入选理由:GPT-6 Astra在Terminal Bench Science等基准测试中击败Claude Fable 5.1,成本降低30%。
Anthropic发布Claude Fable 5.1,性能超越Opus且成本降低,提前应对OpenAI的Astra模型威胁。
入选理由:Fable 5.1通过内存折扣和效率提升,使Opus模型失去竞争力
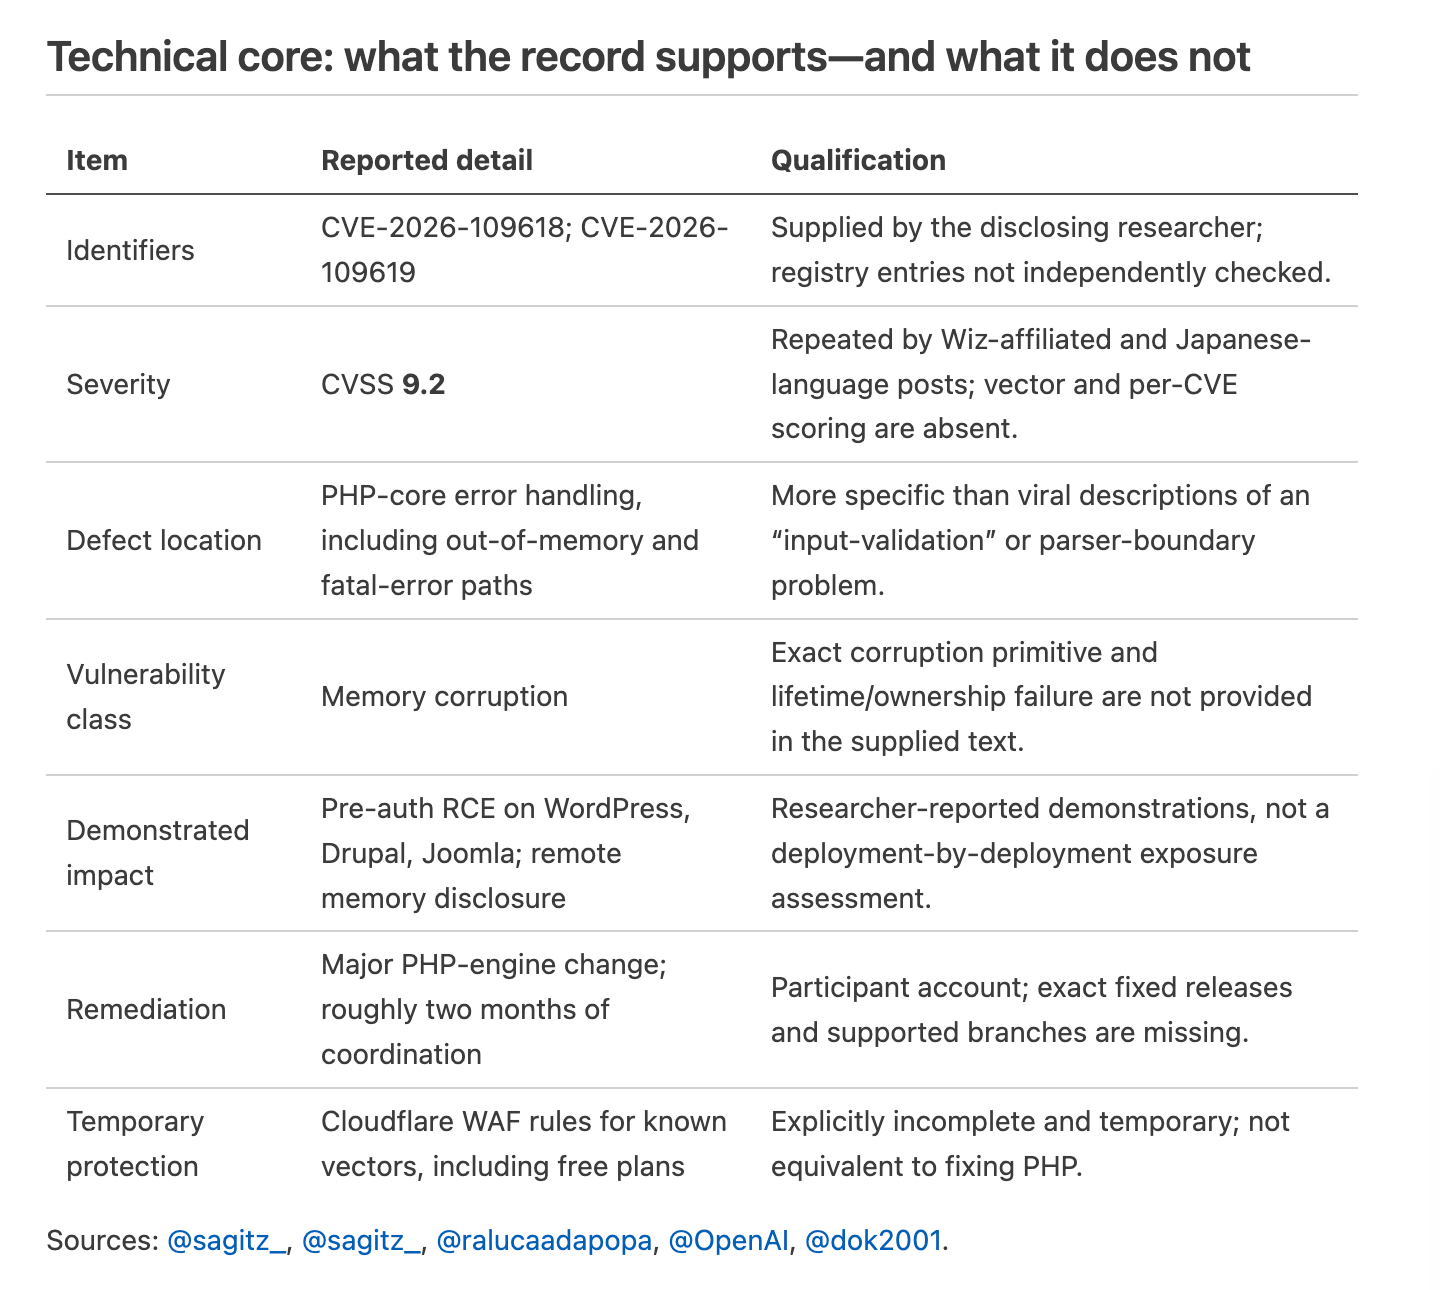
OpenAI利用GPT-5.6 Sol模型发现PHP核心漏洞,影响70%的Web,协调响应两个月。
入选理由:GPT-5.6 Sol模型协助发现PHP2Shell漏洞,影响70%的Web应用
Google Antigravity新增Claude Opus 5.5和Sonnet 5.5模型,支持复杂任务与低成本场景的工程实践。
入选理由:Claude Opus 5.5适用于复杂工程任务,Sonnet 5.5提供更快更低成本方案
智谱推出的GLM-Legal法律模型在Harvey LAB测评中以19.2%全通过率和86.23%准确率位列榜首,成为懂法领域全球领先的开源模型。
入选理由:GLM-Legal在Harvey LAB测评中以19.2%全通过率位列开放权重模型榜首
ParseBench已成为文档处理领域的重要基准工具,被多家公司采用并推动模型能力提升。
入选理由:ParseBench在Hugging Face月下载量达26,000+,覆盖147+模型评估
Gemini 4 Argon已全球发布,支持代码生成等场景,定价为每百万输入/输出令牌$2/$10,内部测试显示效率提升35%。
入选理由:Gemini 4 Argon定价为$2/$10每百万输入/输出令牌(11月30日后翻倍)
Gemini 4 Argon在知识任务表现强劲,但中文写作体验差,不建议购买Ultra版本。
入选理由:Gemini 4 Argon在Vals Index得分68.9,但CUA-bench拒绝率4.83%。
Gemini 4 Argon在Google Antigravity中实现了从CAD文件到3D动画的自动化生成,展示了AI在多步骤工具使用中的突破。
入选理由:Gemini 4 Argon通过1000轮迭代优化渲染效果,显著提升代码生成质量
Gemini 4 Argon在Gemini应用中推出,提升推理、编码和任务处理能力,并集成40+应用。
入选理由:Gemini 4 Argon减少回答冗余,提升复杂任务处理效率