Muse Wonder Puts Meta Back at the AI Frontier
Wired AI737 字 (约 3 分钟)
85
Meta的Muse Wonder模型在AI领域重回前沿,性能超越Anthropic和OpenAI部分模型,并引入Active Memory等新功能提升稳定性。
入选理由:Muse Wonder Full在基准测试中超越Anthropic Claude Fable 5.1和OpenAI GPT-6 Astra
精选文章#AI#Meta#模型#前沿技术英文
模型对比
Claude Fable 5.1 和 Qwen3.8-Flash-Next 都是 AI 领域的模型。以下是基于 traeai 收录的真实报道数据的全面对比。
模型
也叫:Claude Fable
Anthropic第二代主力模型
20 篇相关报道
模型
也叫:Qwen3.8
阿里巴巴推出的高效推理模型,实现在NVIDIA GB300上685 output tokens/s per user的性能。
8 篇相关报道
20
Claude Fable 5.1 相关
0
共同提及
8
Qwen3.8-Flash-Next 相关
基于 traeai 收录材料自动更新
Claude Fable 5.1 与 Qwen3.8-Flash-Next 的差异,最好从真实材料覆盖、共同语境和高频标签一起判断。traeai 会根据已收录内容持续更新这组对比。
Meta的Muse Wonder模型在AI领域重回前沿,性能超越Anthropic和OpenAI部分模型,并引入Active Memory等新功能提升稳定性。
入选理由:Muse Wonder Full在基准测试中超越Anthropic Claude Fable 5.1和OpenAI GPT-6 Astra
Anthropic推出Claude Fable 5.1模型,支持超长上下文处理且价格优化,适合复杂多步骤任务。
入选理由:Fable 5.1处理复杂任务时成本降低50%,但默认推荐使用更便宜的Opus 5模型
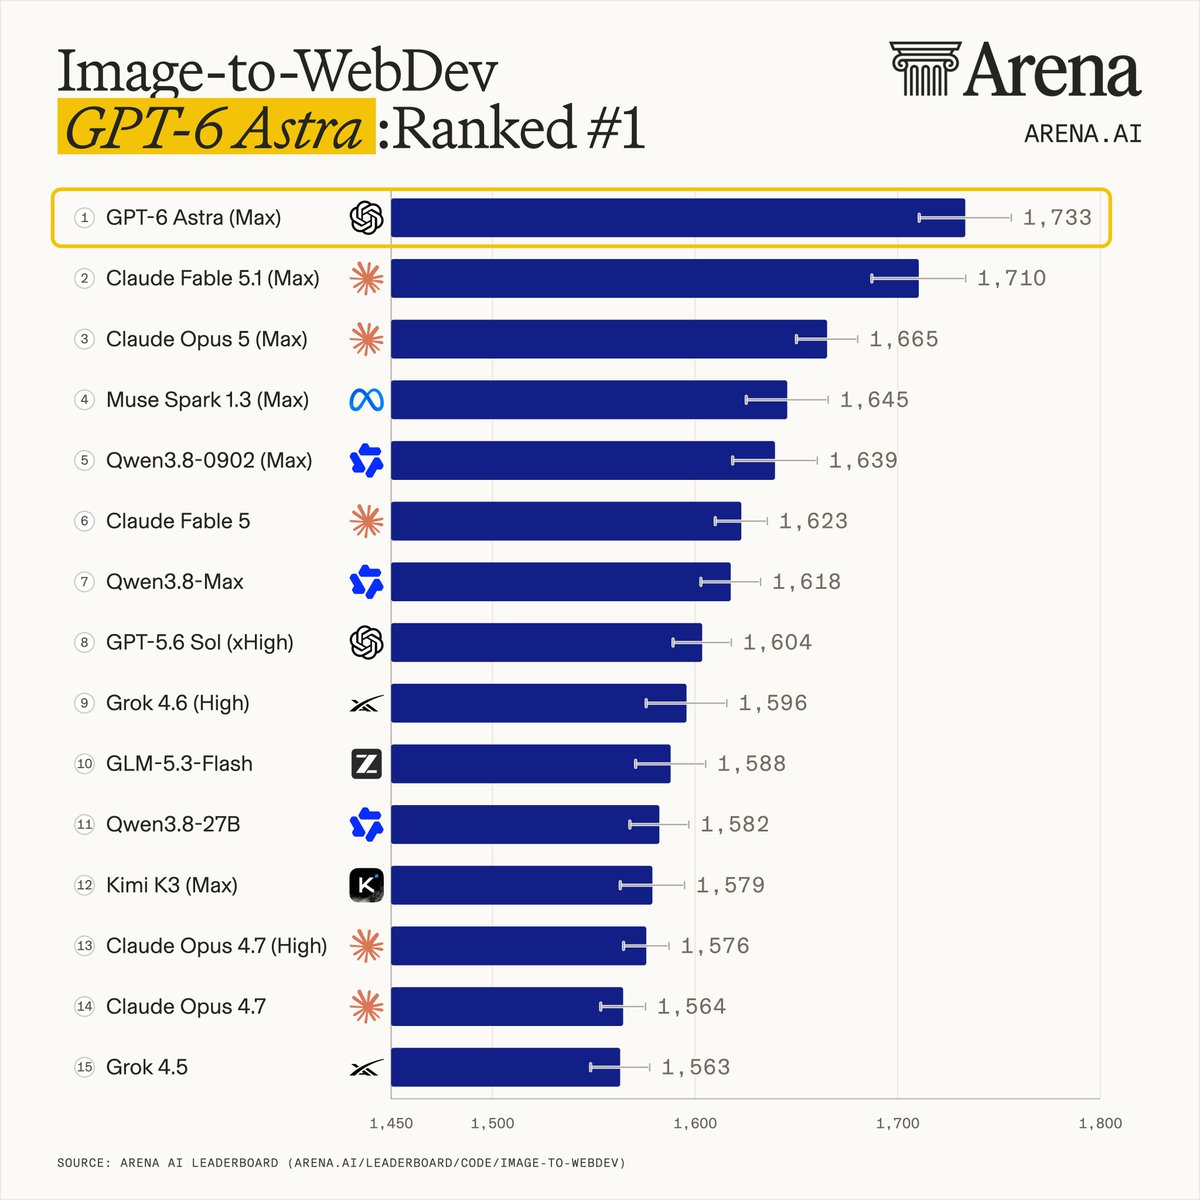
GPT-6 Astra、Claude Fable 5.1等四款新模型在Image-to-WebDev Arena中发布,性能和成本效益显著提升。
入选理由:GPT-6 Astra得分1733,比GPT-5.6 Sol高129分,位列第一
Anthropic发布Claude Fable 5.1,OpenAI预告Astra模型,行业动态涵盖AI安全、开源模型及政策变化。
入选理由:Claude Fable 5.1在生物任务中实现实验室验证的蛋白结合设计突破
Anthropic发布Claude Fable 5.1,提升复杂任务处理能力,适用于代码审查、科学研究等场景。
入选理由:Fable 5.1能处理多步骤任务,如复杂金融模型和长数学证明,减少步骤间错误传播。
Claude Fable 5.1通过分析文本线索成功破解了370年前的Cyphral Distich密码,揭示了隐藏的祈祷文。
入选理由:Fable 5.1用44分钟和176k tokens破解了370年未解的密码
GPT-6 Astra在多个基准测试中超越Anthropic的Claude Fable 5.1,且成本更低,引发OpenAI关注。
入选理由:GPT-6 Astra在Terminal Bench Science等基准测试中击败Claude Fable 5.1,成本降低30%。
Anthropic发布Claude Fable 5.1,性能超越Opus且成本降低,提前应对OpenAI的Astra模型威胁。
入选理由:Fable 5.1通过内存折扣和效率提升,使Opus模型失去竞争力
Qwen3.8-Flash-Next在Agent Arena排行榜中表现优异,排名第七,具有显著的性能提升。
入选理由:Qwen3.8-Flash-Next在Agent Arena开放模型中排名第7,净提升+2.4%
Qwen3.8-Flash-Next是通义千问推出的多模态MoE模型,具有125B参数和显著性能提升。
入选理由:Qwen3.8-Flash-Next采用多模态MoE架构,是Qwen4的早期预览版本
小米MiMo-V2.6-Pro在Code Arena: WebDev榜单中排名约第10,开源权重中约第3,编码能力较前代提升153分。
入选理由:MiMo-V2.6-Pro在Code Arena: WebDev榜单得分1628分,排名约第10名
通义实验室发布Qwen3.8-Flash-Next模型,预览Qwen4架构,NVIDIA提供支持工具和API。
入选理由:Qwen3.8-Flash-Next含125B参数和51B N-gram,预览Qwen4架构
Qwen3.8-Flash-Next在NVIDIA GB300 GPU上实现每用户685输出令牌/秒,展示其高效推理能力。
入选理由:Qwen3.8-Flash-Next在NVIDIA GB300上达到685 output tokens/s per user
通义千问模型Qwen3.8-Flash-Next在vLLM框架下实现NVIDIA和AMD GPU的原生支持,但技术细节披露有限。
入选理由:Qwen3.8-Flash-Next采用125B参数的超稀疏MoE架构,仅6B参数处于激活状态
文章主要报道非技术领域新闻及少量技术动态,技术内容信息密度低,缺乏深度解析。
入选理由:DuckDB团队将加入AWS但保持MIT开源许可
该推文为模型发布宣传,未提供技术深度,主要展示用户反馈和模型链接。
入选理由:该推文为模型发布宣传,未提供技术深度,主要展示用户反馈和模型链接