Gemma 4 12B:开发者指南
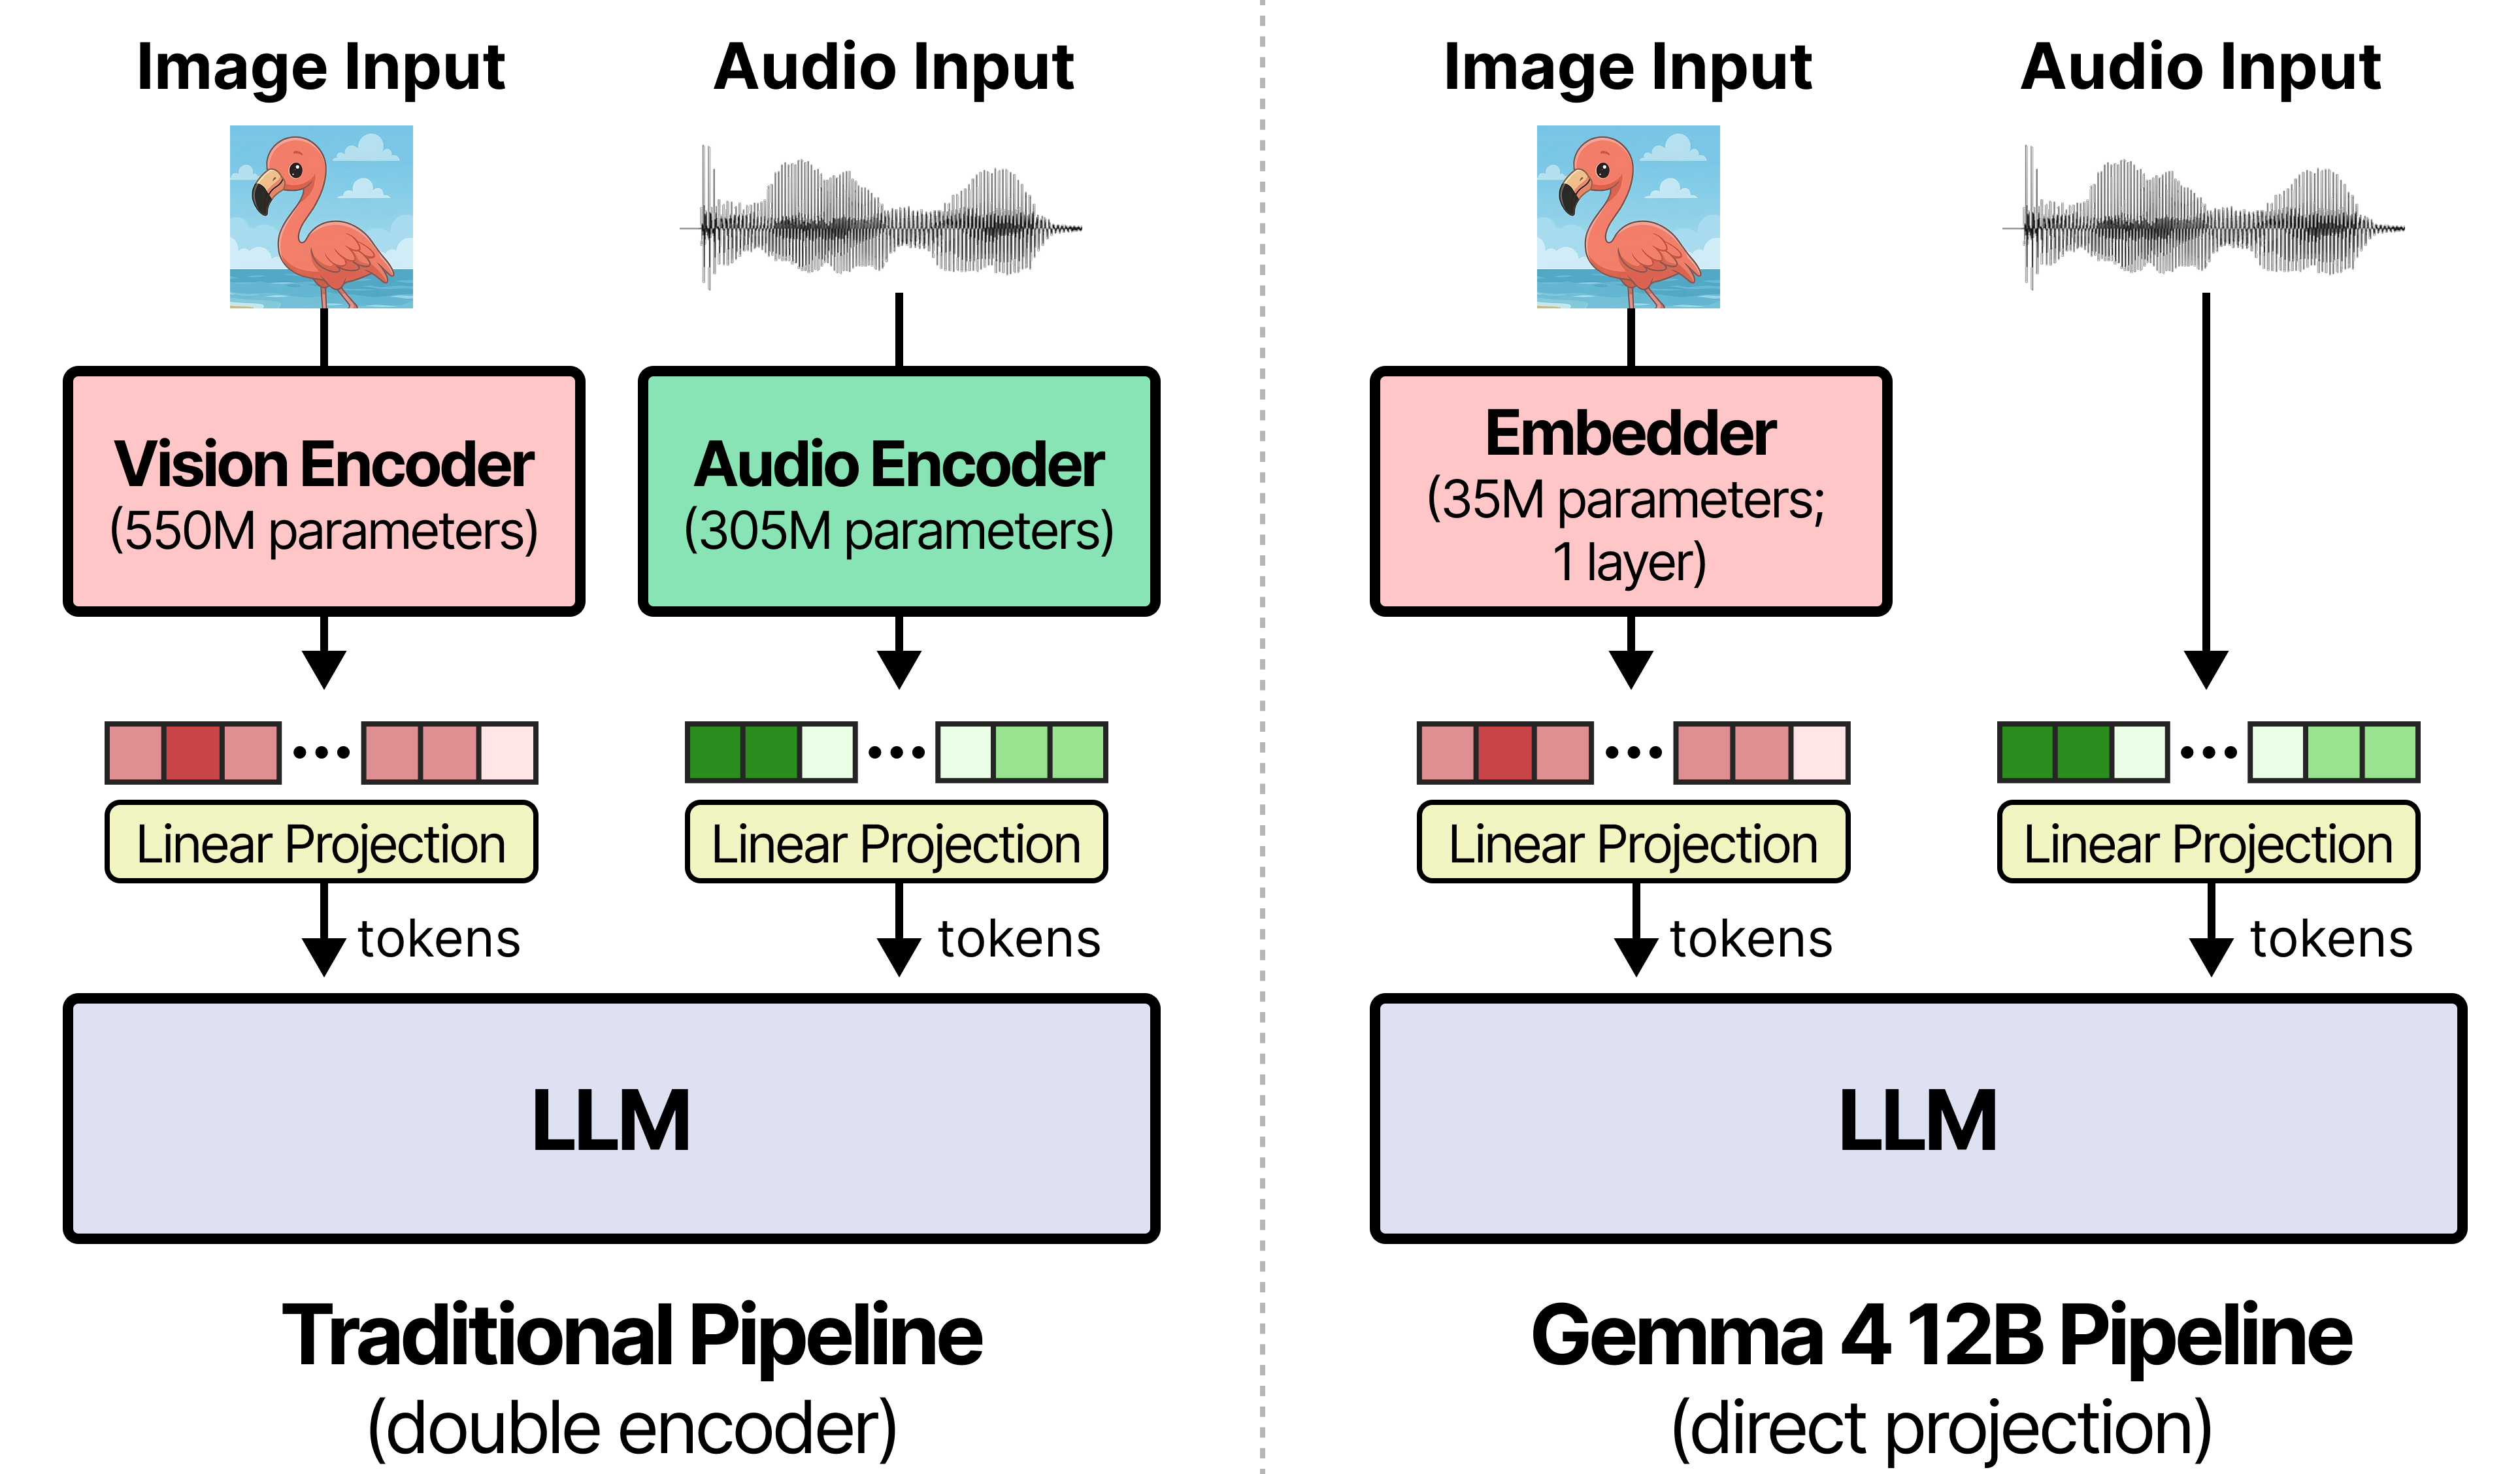
Gemma 4 12B采用无编码器多模态架构,可在16GB显存设备上本地运行并原生支持音频输入。该模型通过移除独立视觉与音频编码器显著降低延迟,配合专用MTP模型提升推理速度,是首个支持macOS桌面端全离线交互的中型多模态模型。
入选理由:Gemma 4 12B移除独立编码器,视觉仅用35M参数嵌入层,音频直接线性投影至LLM输入空间
公司
也叫:UnslothAI
提供Qwen3.5决策模型训练方案
最近变化
2026-10-10 · OpenAI Decisions API单次请求成本0.10美元/百万输入token,速度提升10倍
Unsloth 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 4 篇与「Unsloth」相关的 AI 资讯和分析。
Gemma 4 12B采用无编码器多模态架构,可在16GB显存设备上本地运行并原生支持音频输入。该模型通过移除独立视觉与音频编码器显著降低延迟,配合专用MTP模型提升推理速度,是首个支持macOS桌面端全离线交互的中型多模态模型。
入选理由:Gemma 4 12B移除独立编码器,视觉仅用35M参数嵌入层,音频直接线性投影至LLM输入空间
Qwen3.8-Flash-Next是通义千问推出的多模态MoE模型,具有125B参数和显著性能提升。
入选理由:Qwen3.8-Flash-Next采用多模态MoE架构,是Qwen4的早期预览版本
DiffusionGemma 模型通过并行生成文本块,实现高达 4 倍的文本生成速度,适用于需要高速处理的本地交互场景。
入选理由:DiffusionGemma 在 NVIDIA H100 上每秒生成 1000+ tokens,速度比传统模型快 4 倍。
决策模型成为AI新赛道,OpenAI、Perplexity等推出竞品,TypeSafe/Jev以100M ARR验证市场潜力。
入选理由:OpenAI Decisions API单次请求成本0.10美元/百万输入token,速度提升10倍
与「Unsloth」经常一起出现的 AI 术语。
💡 想追踪「Unsloth」的长期趋势?去 实体雷达 · Unsloth 查看详细分析和跨材料问答。