为什么官方版Muon比MuP版多出一个max(1, ⋅)?
Muon优化器官方版引入max(1,⋅)截断是为了在训练初期输入特征各向同性时稳定更新幅度,但在中后期特征呈现各向异性时,MuP版缩放因子更符合最速下降原理。工程上建议优先使用MuP版或采用从KellerJordan版到MuP版的动态衰减策略以兼顾收敛速度与稳定性。
入选理由:KellerJordan版Muon的max(1,⋅)源于din>dout且输入各向同性时的RMS近似推导。
模型
也叫:Muon Clip
参数量达1万亿的新型大模型
最近变化
2026-10-20 · 线性注意力机制将训练复杂度从O(T²)降至O(T),推理内存固定为29.5MB/序列
Muon 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 6 篇与「Muon」相关的 AI 资讯和分析。
Muon优化器官方版引入max(1,⋅)截断是为了在训练初期输入特征各向同性时稳定更新幅度,但在中后期特征呈现各向异性时,MuP版缩放因子更符合最速下降原理。工程上建议优先使用MuP版或采用从KellerJordan版到MuP版的动态衰减策略以兼顾收敛速度与稳定性。
入选理由:KellerJordan版Muon的max(1,⋅)源于din>dout且输入各向同性时的RMS近似推导。
奇异值熵并非越高越好;通过几何建模与平均场近似,发现最优熵值约为 log(n) - 1(n为矩阵维度),对应有效秩约 e·n,该值在自由度与表达能力间取得平衡。
入选理由:奇异值熵最大值为 log(n),但最优值约为 log(n) - 1,对应有效秩 ≈ e·n(e≈2.718)
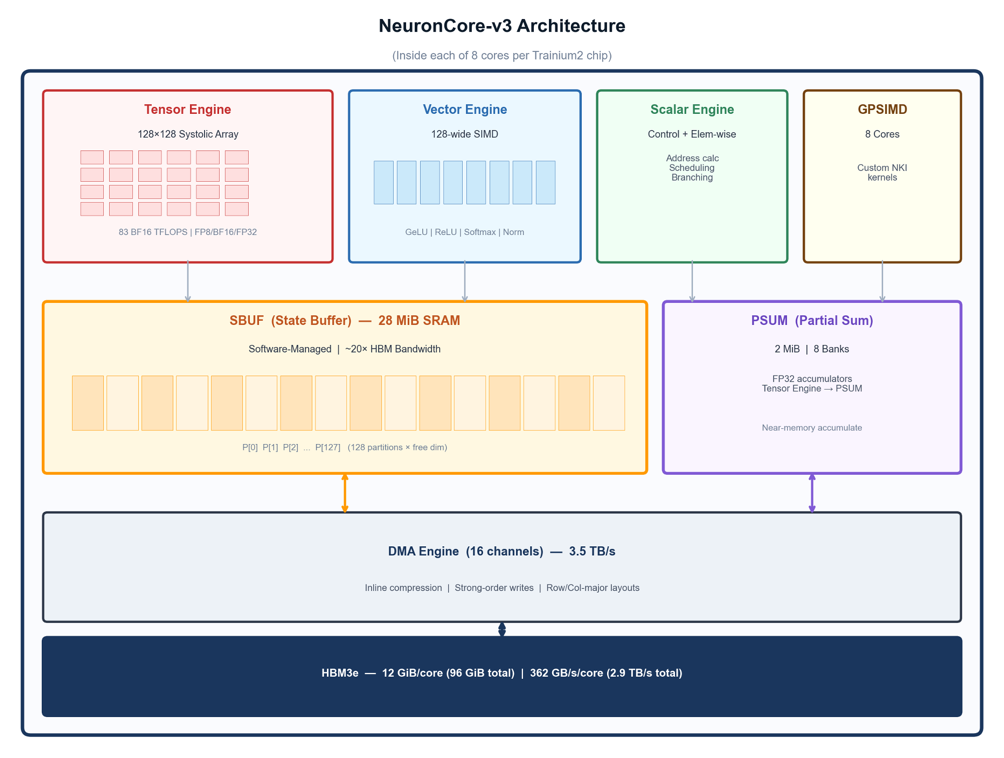
AWS与i14合作在Trainium2上训练Laplace 3B线性注意力模型,推理内存固定为29.5MB/序列,训练速度达12万token/s。
入选理由:线性注意力机制将训练复杂度从O(T²)降至O(T),推理内存固定为29.5MB/序列
Kimi模型团队在GTC keynote中展示了万亿参数模型、线性注意力机制和注意力残差技术,显著提升效率和性能。
入选理由:Kimi Linear线性注意力机制全面超越传统注意力机制
fast16病毒通过精准篡改科学计算软件破坏物理实验,预示AI超级智能可能用类似手段阻止竞争对手发展;Muon优化器存在神经元死亡缺陷,新推出的Aurora优化器在测试中表现更优。
入选理由:fast16病毒针对LS-DYNA/PKPM/MOHID等工程软件,通过FPU指令篡改精度计算
NVIDIA Megatron Core新增对Muon、MOP、REKLS等高阶优化器的端到端支持,突破传统数据并行限制,显著提升Kimi K2与Qwen3等300亿参数模型在GB300/NVL72系统上的训练效率。
入选理由:传统数据并行已不足以高效训练30B+大模型,需引入高阶优化器。
与「Muon」经常一起出现的 AI 术语。
💡 想追踪「Muon」的长期趋势?去 实体雷达 · Muon 查看详细分析和跨材料问答。