T
traeai
登录

模型

什么是 GPT-4o?

也叫:GPT-4

OpenAI发布的多模态大语言模型

为什么现在值得关注?

最近变化

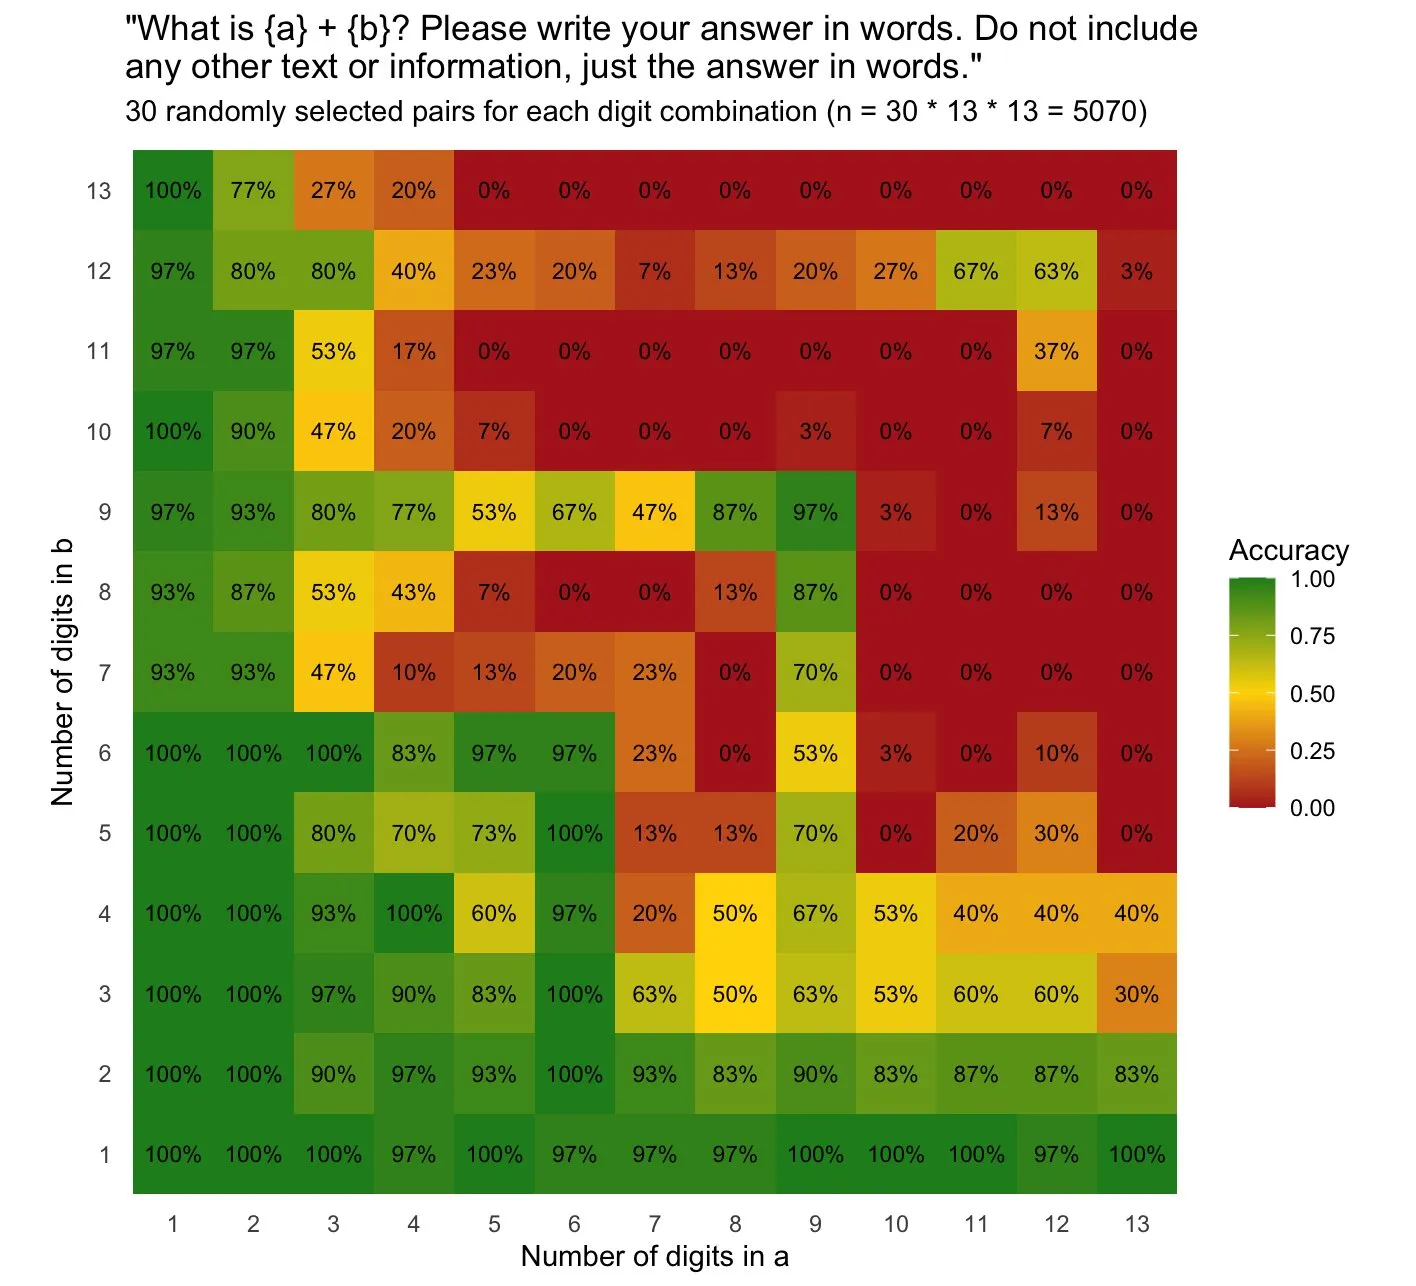
2026-10-04 · Qwen3.8-27B无推理时十至十三位数相加准确率仅6.44%

GPT-4o 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。

📰 GPT-4o 最新动态

已收录 16 篇与「GPT-4o」相关的 AI 资讯和分析。

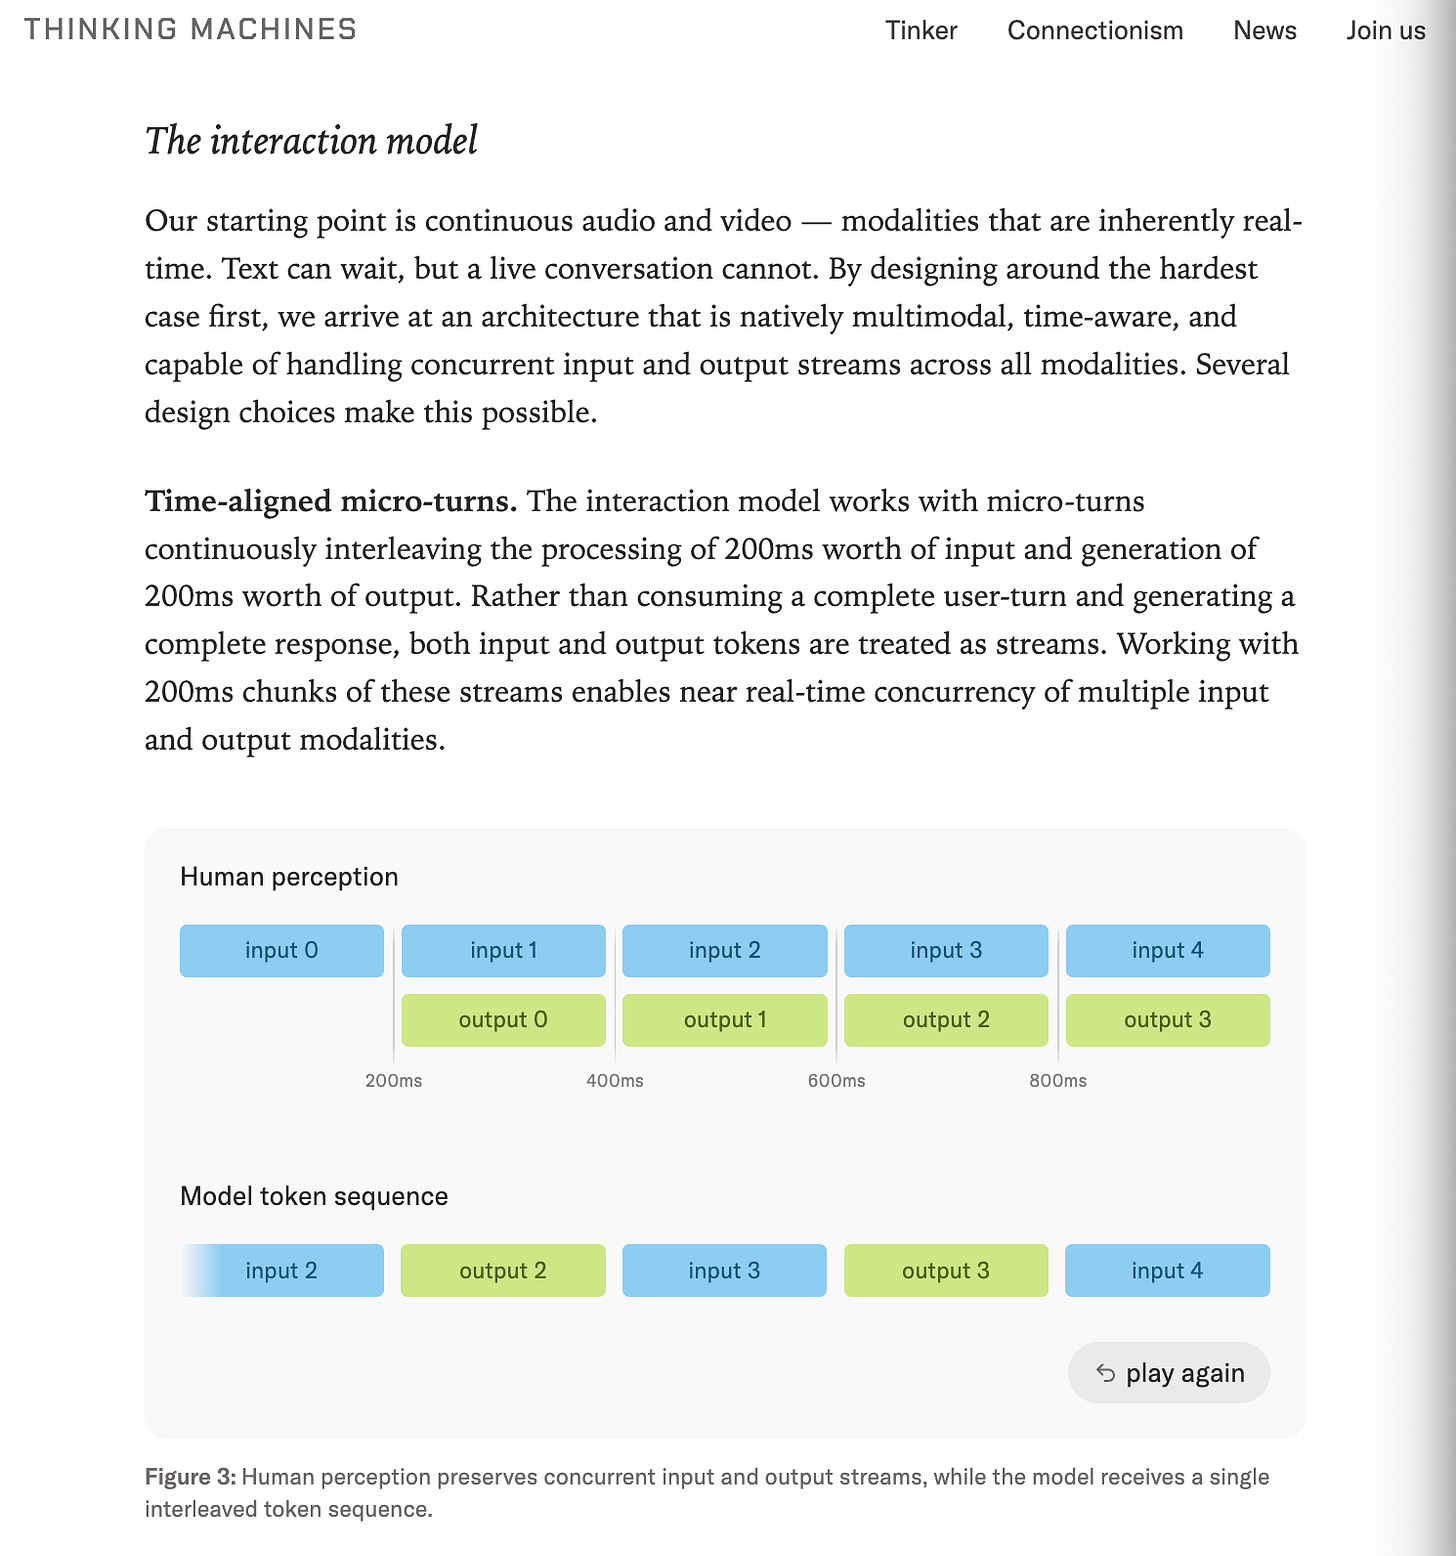
[AINews] Thinking Machines' Native Interaction Models - TML-Interaction-Small 276B-A12B - advances SOTA Realtime Voice and kills standard VAD

Thinking Machines发布TML-Interaction-Small 276B-A12B模型,采用2760亿参数MoE架构与120亿活跃参数,实现<200ms端到端延迟,显著超越GPT-4o和Gemini 3.1-Flash,在实时语音交互、时间对齐微回合与视觉主动性任务上达到SOTA,彻底淘汰传统VAD机制。

入选理由:TML-Interaction-Small为276B参数MoE模型,仅12B激活参数,实现<200ms端到端延迟。

精选文章#AI#语音交互#MoE#实时系统#模型架构中文
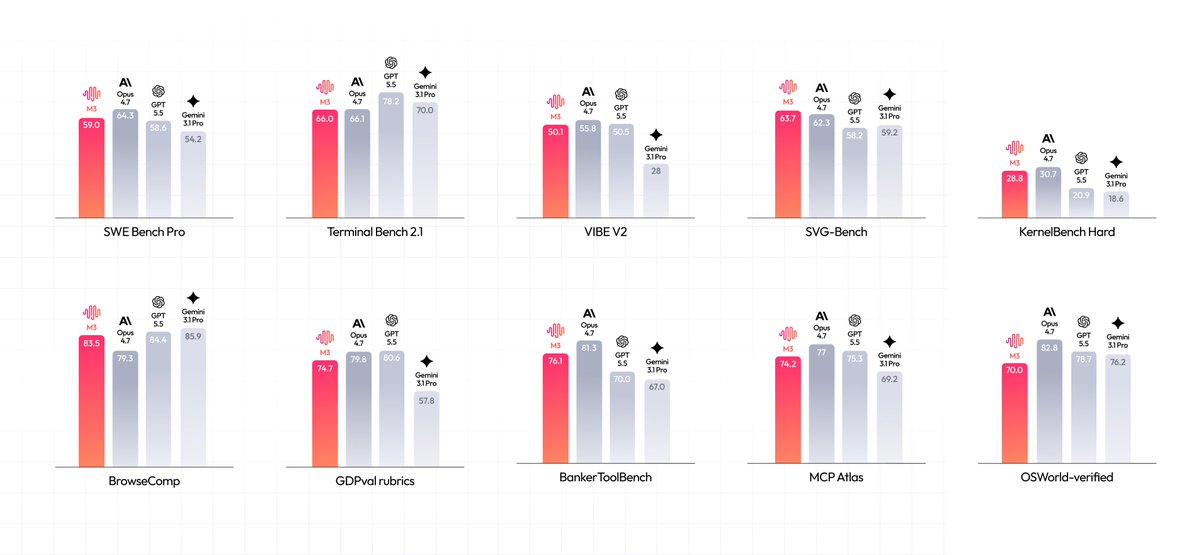
MiniMax-M3 is live on OpenRouter!

A frontier-class open-weight model that combines a 1M-token conte...

MiniMax-M3 登陆 OpenRouter!

OpenRouter(@OpenRouterAI)134 字 (约 1 分钟)
87

MiniMax-M3 已上线 OpenRouter,是一款支持100万token上下文、前沿编码与代理性能、原生多模态(图像/视频)的开源模型,标志着大模型能力向长文本、多模态和自主执行方向的重要突破。

入选理由:MiniMax-M3 支持1M-token上下文窗口,显著超越主流模型如GPT-4o的32K限制。

精选推文#MiniMax-M3#OpenRouter#开源模型#多模态#长上下文英文
Qwen3.8 27B addition in words

Qwen3.8 27B addition in words

Simon Willison's Weblog553 字 (约 3 分钟)
85

Qwen3.8-27B模型在无推理时大数相加准确率仅23.57%,启用推理后提升至97.04%。

入选理由:Qwen3.8-27B无推理时十至十三位数相加准确率仅6.44%

精选文章#Qwen3.8#LLM#推理机制#大数计算中英混合
mem0(@mem0ai) 图标

https://t.co/wyA9Gm54vW

mem0(@mem0ai)2305 字 (约 10 分钟)
85

现有回忆基准测试已饱和,无法准确评估代理系统,需转向行动基准测试并关注成本指标。

入选理由:现有回忆基准测试已饱和,GPT-4o在LongMemEval中得分0.606

精选推文#AI代理#基准测试#记忆系统#DolphinBench英文
Towards Data Science 图标

Your LLM Can Return Perfect JSON and Still Be Wrong

Towards Data Science1862 字 (约 8 分钟)
85

结构化输出虽确保JSON格式正确,但可能因数据填充错误导致下游系统失效,需额外验证数据真实性。

入选理由:2-3%交易因模型填充缺失日期导致对账错误

精选文章#LLM#结构化输出#数据验证#Python#OpenAI英文
How to Build AI Applications That Switch Models Automatically

How to Build AI Applications That Switch Models Automatically

freeCodeCamp.org2635 字 (约 11 分钟)
85

多模型AI架构能通过动态路由和自动回退机制,平衡成本与性能,避免单一模型风险。

入选理由:使用OpenAI和Anthropic双模型可降低60%复杂任务成本

精选文章#AI#模型切换#Python#多模型架构英文
Import AI 图标

Import AI 462: Superpersuasion; self-sustaining AI; paths to ASI

Import AI3232 字 (约 13 分钟)
85

AI在说服力上已超越人类专家,尤其在政策和慈善捐款方面效果显著。

入选理由:AI系统在说服力上比人类专家高出3倍,尤其在慈善捐款方面表现突出。

精选文章#AI#说服力#研究#OpenAI#GPT英文
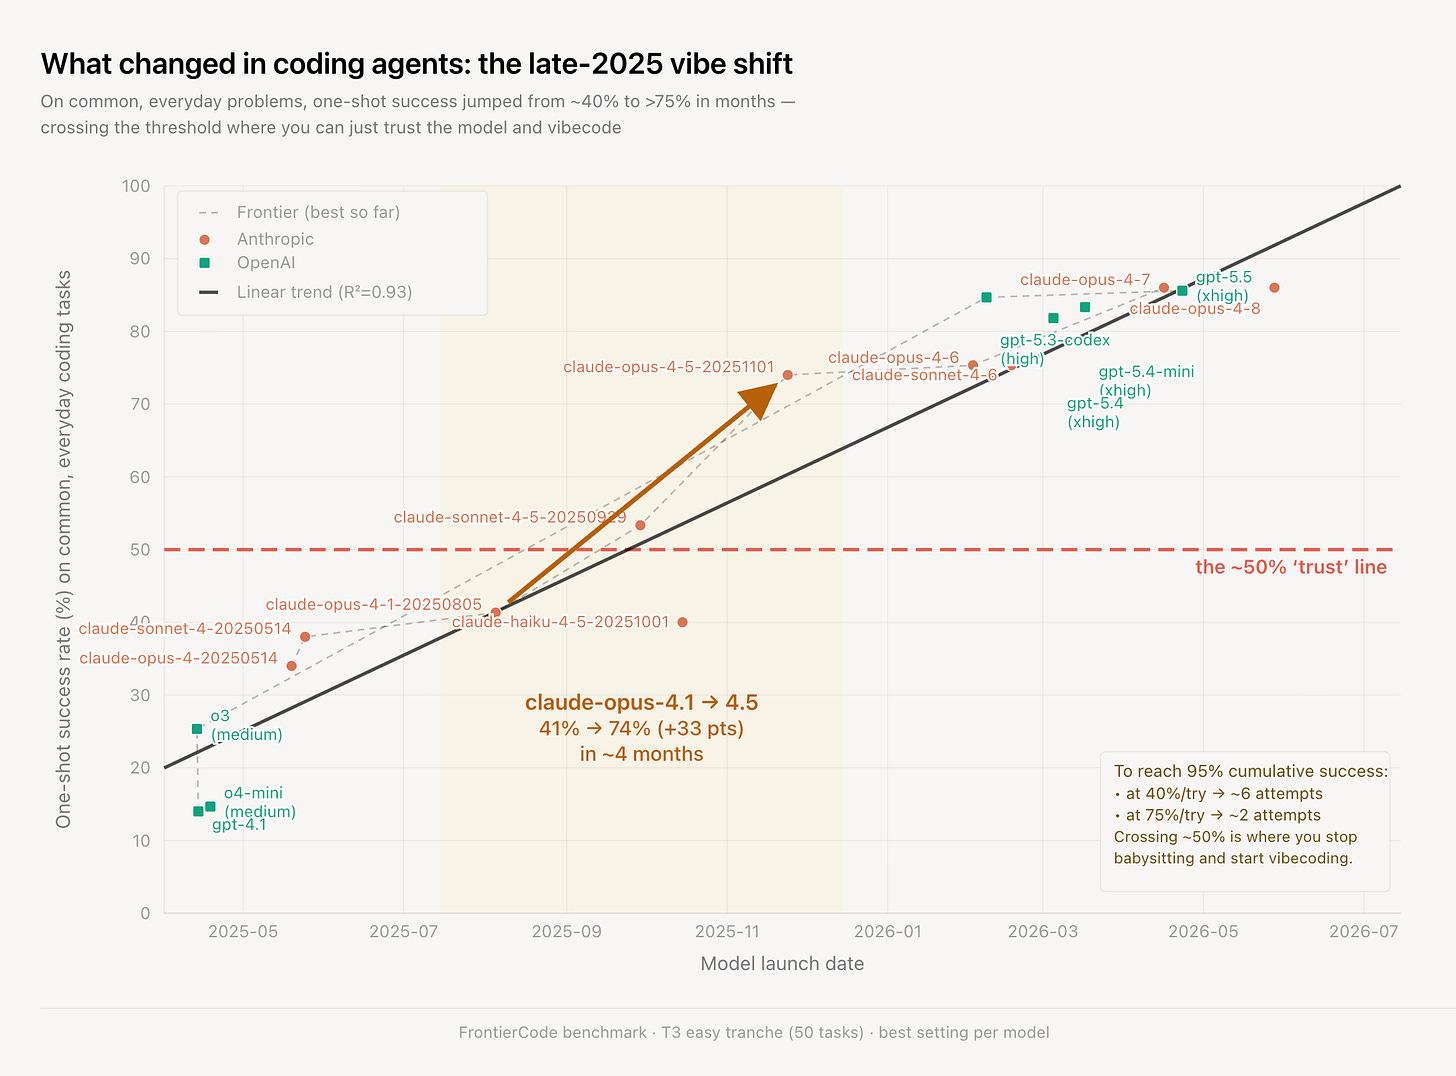
[AINews] FrontierCode: Benchmarking for Code Quality over Slop

[AINews] FrontierCode: Benchmarking for Code Quality over Slop

Latent Space1922 字 (约 8 分钟)
85

FrontierCode 是一项新的代码质量评估基准,专注于衡量代码是否可合并,而非仅通过单元测试。

入选理由:FrontierCode 由开源维护者耗时 40 多小时构建,旨在评估代码是否可合并。

精选文章#FrontierCode#代码质量#AI 工程#基准测试英文
Martin Fowler 图标

Fragments: June 2

Martin Fowler1848 字 (约 8 分钟)
75

Martin Fowler在Fragments中分析了AI工具评估指标的缺陷,指出自动化并未导致职业消亡,开源模型追赶闭源模型的速度正在加快,以及AI生成内容中的幻觉引用问题。

入选理由:闭源模型创新速度领先,开源模型追赶周期从GPT-4的13-18个月缩短至GPT-4o的2-7个月。

精选文章#AI评估#模型性能#职业影响#内容生成英文
The Craziest Vibe Coded Project I've Ever Seen

The Craziest Vibe Coded Project I've Ever Seen

Matt Wolfe478 字 (约 2 分钟)
70

Odysseus 是一个本地运行的 AI 工作空间,不依赖云端服务器,但并非 ChatGPT 竞品。

入选理由:Odysseus 是一个本地运行的 AI 工作空间,无需连接云端服务器。

精选视频#AI#开源#本地部署#Odysseus英文
Everything we learned building browser use harnesses

Everything we learned building browser use harnesses

Browser Use(@browser_use)83 字 (约 1 分钟)
65

Browser Use团队在构建浏览器使用工具时发现,随着模型能力提升,必须大幅调整浏览器代理的设计,特别是针对GPT-4o训练不足的问题。

入选理由:2024年Browser Use推出时GPT-4o未训练计算机使用能力

精选推文#Browser Use#AI模型#前端工具#GPT-4o英文
Codex for saving money by reading the fine print:

Codex for saving money by reading the fine print:

Greg Brockman(@gdb)212 字 (约 1 分钟)
65

AI模型Codex和GPT-4o在电费优化和医疗急救中展现实际价值,但缺乏技术细节与系统性分析。

入选理由:Codex帮助用户每年节省6000美元电费

精选推文#AI应用#案例研究#OpenAI#医疗科技中英混合
ChatGPT is increasingly becoming your personal AGI

ChatGPT is increasingly becoming your personal AGI

Greg Brockman(@gdb)230 字 (约 1 分钟)
60

ChatGPT 正逐渐成为个人 AGI,但缺乏技术细节和实用指导。

入选理由:用户评论显示 GPT-4o 被认为是更接近 AGI 的版本

精选推文#AGI#ChatGPT#OpenAI#人工智能中英混合
true fact

true fact

Greg Brockman(@gdb)91 字 (约 1 分钟)
50

该推文内容为用户对Codex和GPT-4o模型的碎片化评论,缺乏技术深度和系统性分析,不适合作为技术学习材料。

入选理由:文章未提供任何技术原理或架构细节,仅包含用户主观评价

精选推文#AI模型#用户反馈#OpenAI中英混合

与「GPT-4o」经常一起出现的 AI 术语。

💡 想追踪「GPT-4o」的长期趋势?去 实体雷达 · GPT-4o 查看详细分析和跨材料问答。

AI 可能会生成不准确的信息,请核实重要内容