Article: Distributed Spring Batch Without a Message Broker
InfoQ4403 字 (约 18 分钟)
85
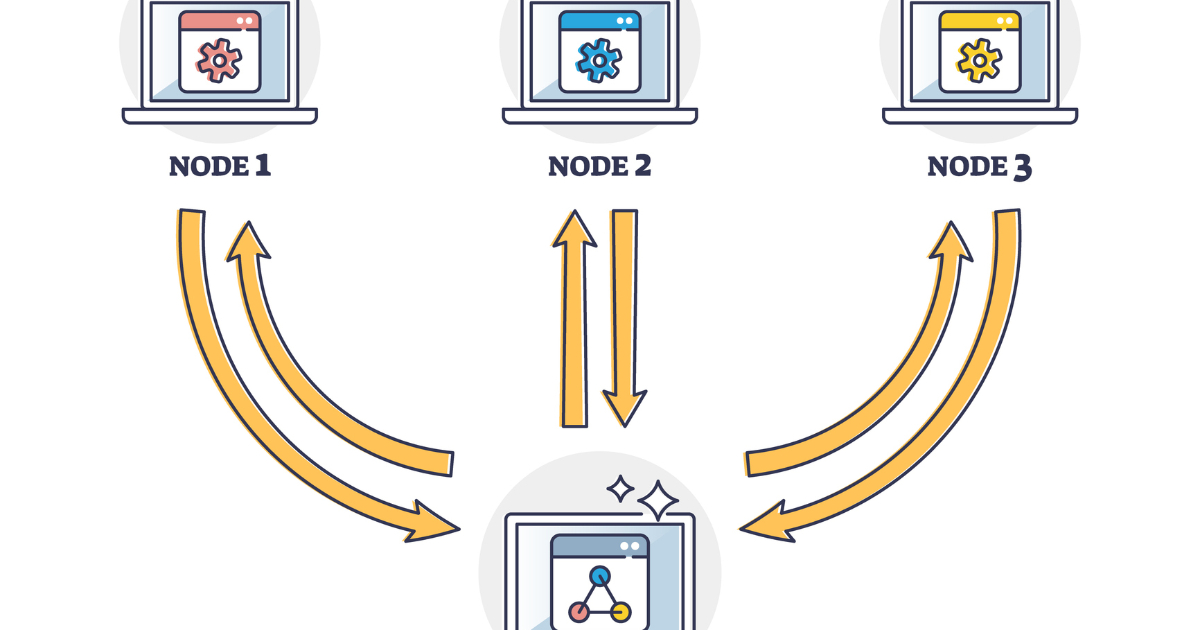
Spring Batch可通过关系数据库实现分布式处理而无需消息代理,适合中小团队的横向扩展需求。
入选理由:使用关系数据库作为协调平面可替代消息代理实现分布式Spring Batch
精选文章#Spring Batch#分布式系统#Java#消息队列#数据库协调英文
产品
也叫:kafka
分布式流处理平台
最近变化
2026-10-21 · 使用关系数据库作为协调平面可替代消息代理实现分布式Spring Batch
Apache Kafka 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 5 篇与「Apache Kafka」相关的 AI 资讯和分析。
Spring Batch可通过关系数据库实现分布式处理而无需消息代理,适合中小团队的横向扩展需求。
入选理由:使用关系数据库作为协调平面可替代消息代理实现分布式Spring Batch
Malachyte通过Google Cloud的实时AI和神经网络技术,解决零售冷启动问题,帮助零售商提升销售。
入选理由:使用Bigtable和Kafka使零售商销售翻倍甚至三倍
Cloudflare 通过优化 Kafka 和引入新的扫描架构,将安全扫描吞吐量提升了 10 倍,显著提高了扫描频率和覆盖范围。
入选理由:Cloudflare 将安全扫描吞吐量从每秒 10 次提升至每秒 100 次,提升了 10 倍。
Apache Kafka 正在向云原生架构转型,通过存储去耦合改变了经济模式,降低了运营成本,提高了灵活性。
入选理由:存储去耦合使 Kafka 经济模式发生变化,将成本从基础设施预配转移到云 API 使用,减少了不高效的消费者访问模式带来的运营费用。
通过使用基于判别器的模式来合并事件模式,可以解决Kafka和Flink管道中的模式泛滥问题,从而简化查询和维护。
入选理由:一对一事件到模式映射导致复杂性增加,应使用判别器字段合并模式。
与「Apache Kafka」经常一起出现的 AI 术语。
💡 想追踪「Apache Kafka」的长期趋势?去 实体雷达 · Apache Kafka 查看详细分析和跨材料问答。