How AI Models Learn
No Priors191 字 (约 1 分钟)
85
生成模型通过压缩数据学习结构,压缩效率与模式识别能力直接相关。
入选理由:生成模型(如自回归模型)通过压缩数据学习结构
精选视频#AI模型#生成模型#数据压缩#机器学习英文
模型
别名:diffusion model
通过噪声扩散过程生成数据的模型
已跟踪 10 条高相关材料
最近变化
2026-10-05 · 生成模型(如自回归模型)通过压缩数据学习结构
为什么值得关注
扩散模型 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
How AI Models Learn
No Priors · 8.5 分
生成模型通过压缩数据学习结构,压缩效率与模式识别能力直接相关。
Betting on Diffusion
No Priors · 8.5 分
扩散模型在推理时的并行处理优势使其成为未来LLM的潜在方向,相比Transformer的顺序生成更高效。
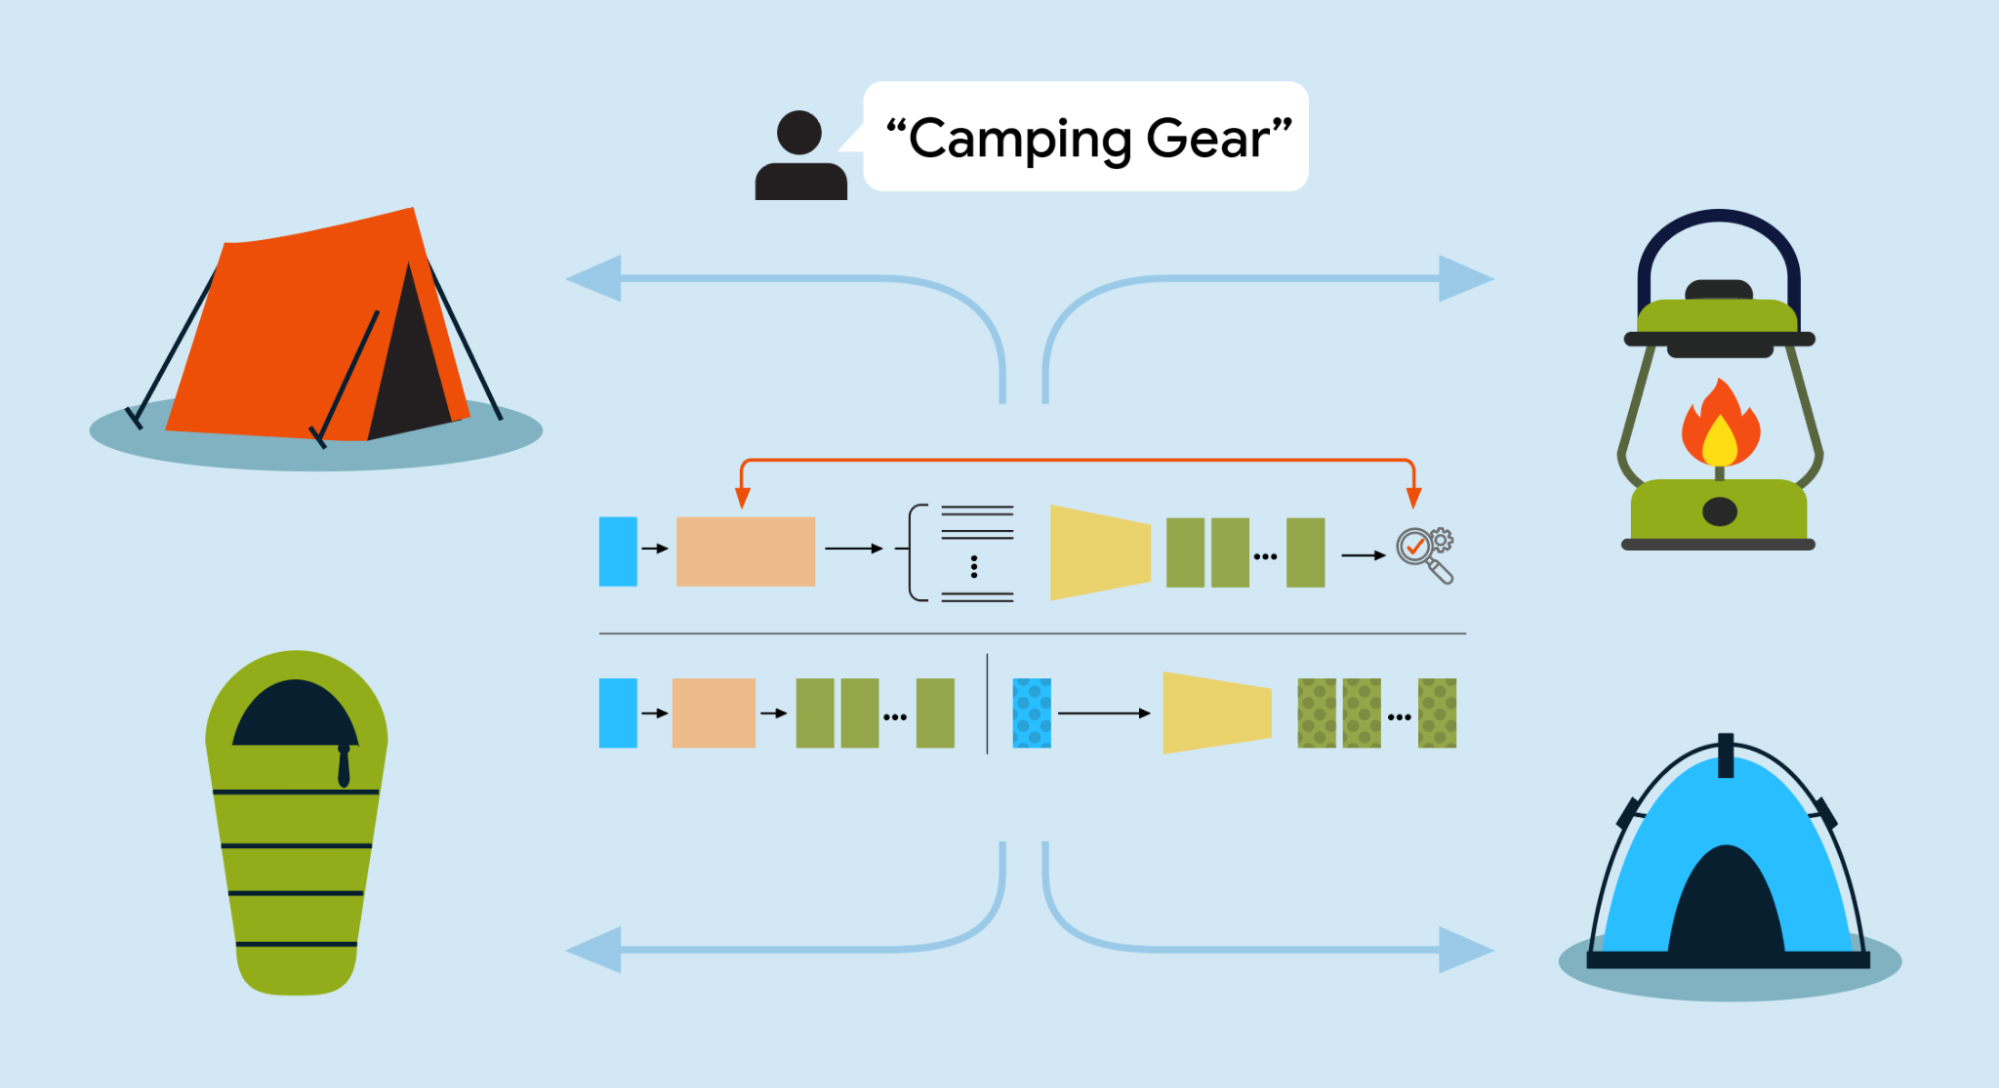
Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train
Google Research Blog · 8.5 分
Google提出Retrieve-for-Train框架,通过强化学习训练轻量扩散模型,无需推理阶段计算即可生成满足多样性和覆盖性的搜索结果集。
已收录 10 条与 扩散模型 相关的内容,按评分排序。
生成模型通过压缩数据学习结构,压缩效率与模式识别能力直接相关。
入选理由:生成模型(如自回归模型)通过压缩数据学习结构
扩散模型在推理时的并行处理优势使其成为未来LLM的潜在方向,相比Transformer的顺序生成更高效。
入选理由:Transformer推理需顺序生成,导致内存瓶颈,扩散模型可并行处理
Google提出Retrieve-for-Train框架,通过强化学习训练轻量扩散模型,无需推理阶段计算即可生成满足多样性和覆盖性的搜索结果集。
入选理由:使用强化学习预训练扩散模型,消除推理阶段的计算瓶颈
微软研究院提出通过反向匹配机制提升扩散模型强化学习训练的可扩展性,解决了后训练阶段复杂度高的问题。
入选理由:扩散模型预训练简单但后训练复杂度高,限制了应用
微软研究院提出二项式流模型,通过去噪和流匹配解决离散序数数据生成问题,填补连续与分类扩散模型间的空白。
入选理由:二项式流模型专为整数型离散数据设计,支持-1/0/1等有序数值
Meta推出Muse Image和Muse Video,通过多模态扩散模型实现高质量图像/视频生成,支持文本到视频的端到端生成。
入选理由:Muse Video支持文本到视频的端到端生成,帧率可达30fps
Uno方法通过结合扩散模型和自回归模型,实现LLM推理速度的提升,但缺乏具体技术细节。
入选理由:Uno方法声称能实现自回归质量与扩散速度的结合
该视频展示了谷歌推出的新型扩散模型,其推理速度达到每秒1,000个token,但不适用于大规模云部署。
入选理由:谷歌的新扩散模型推理速度达到每秒1,000个token,是现有模型的11倍。
扩散模型生成高质量图像和视频通常需要20到50次去噪步骤,但实际应用中需考虑速度和实用性。
入选理由:扩散模型通常需要20到50次去噪步骤以生成高质量图像和视频。
Vidu S1模型实现实时交互式视频生成,采用扩散模型与动态控制机制,推理速度达30FPS。
入选理由:Vidu S1模型通过动态控制机制实现30FPS实时视频生成