在Amazon Elastic Kubernetes Service上部署多阶段多模态推荐系统
本文详细阐述了在Amazon EKS上部署多阶段多模态推荐系统的完整生产方案,通过Bloom过滤器、内存特征缓存和Kubeflow持续微调,实现毫秒级延迟与百万级商品实时推荐。
入选理由:使用Bloom过滤器在检索后临时屏蔽用户近期交互商品,降低冗余推荐率37%。
模型
别名:SBERT
用于生成句子嵌入向量的预训练模型
已跟踪 2 条高相关材料
最近变化
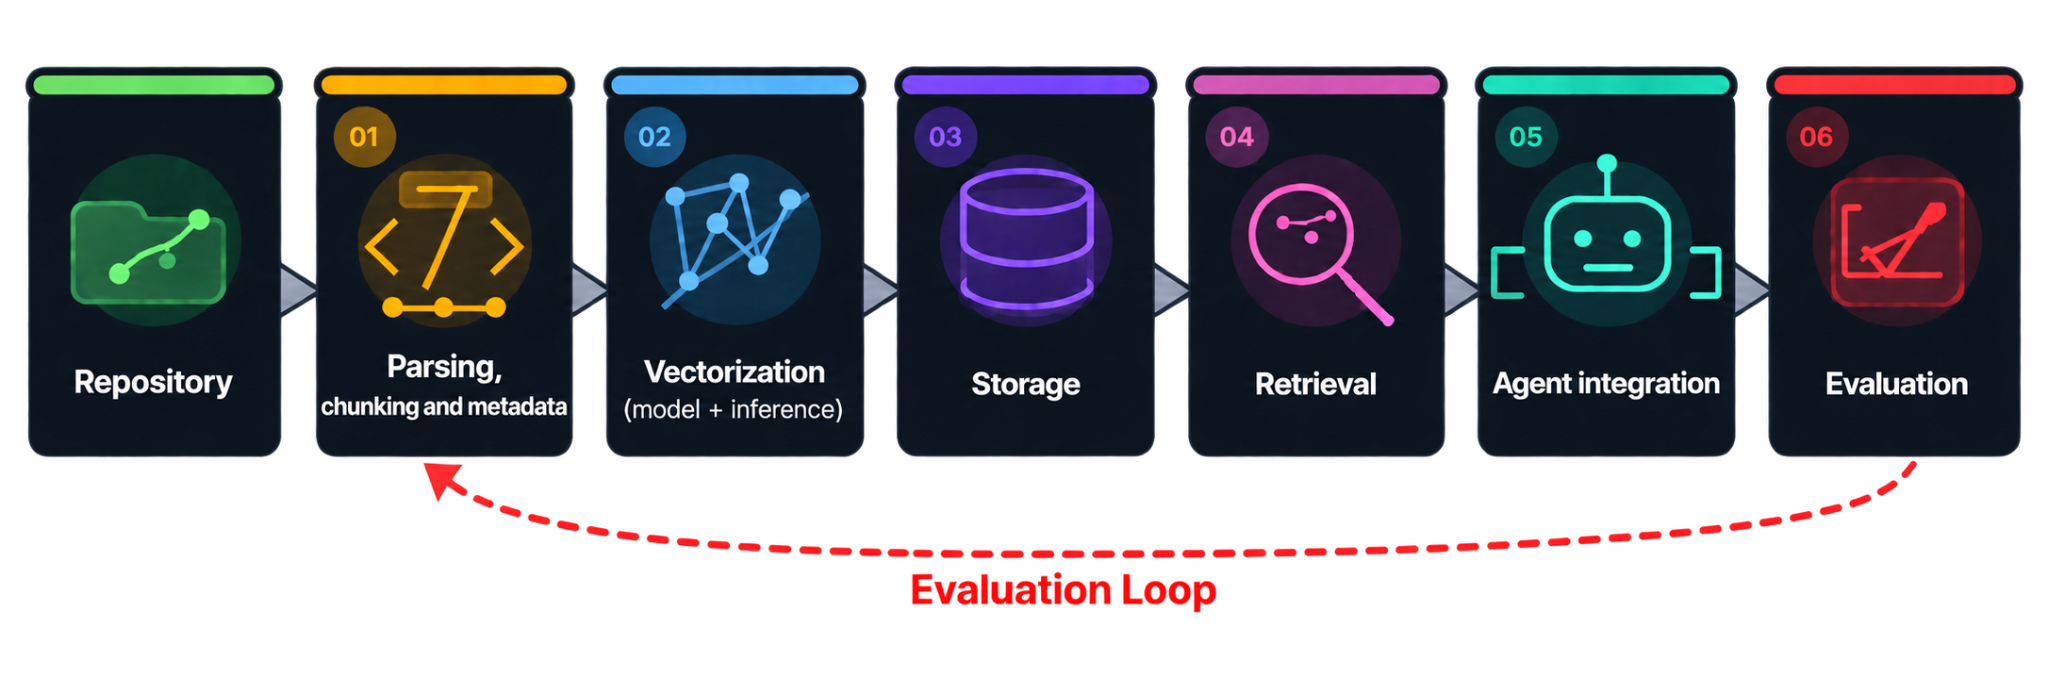
2026-09-17 · 代码解析与分块是RAG管道的基础,需处理多语言语法差异
为什么值得关注
Sentence-BERT 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Deploying a Multistage Multimodal Recommender System on Amazon Elastic Kubernetes Service
Towards Data Science · 8.7 分
本文详细阐述了在Amazon EKS上部署多阶段多模态推荐系统的完整生产方案,通过Bloom过滤器、内存特征缓存和Kubeflow持续微调,实现毫秒级延迟与百万级商品实时推荐。
Building a RAG Pipeline for Semantic Code Search: A Developer Diary and Field Notes
The JetBrains Blog · 8.5 分
JetBrains分享了构建RAG管道进行语义代码搜索的实践经验,涵盖解析、分块、向量化等关键步骤,揭示生产环境中的技术挑战与优化策略。
已收录 2 条与 Sentence-BERT 相关的内容,按评分排序。
本文详细阐述了在Amazon EKS上部署多阶段多模态推荐系统的完整生产方案,通过Bloom过滤器、内存特征缓存和Kubeflow持续微调,实现毫秒级延迟与百万级商品实时推荐。
入选理由:使用Bloom过滤器在检索后临时屏蔽用户近期交互商品,降低冗余推荐率37%。
JetBrains分享了构建RAG管道进行语义代码搜索的实践经验,涵盖解析、分块、向量化等关键步骤,揭示生产环境中的技术挑战与优化策略。
入选理由:代码解析与分块是RAG管道的基础,需处理多语言语法差异