Claude 通过率不到4%,SaaS-Bench撕碎了Computer-Use的「全自动办公」幻想
量子位2718 字 (约 11 分钟)
92
SaaS-Bench评测显示主流大模型在真实办公任务中完全通过率不足4%,揭示AI全自动办公仍面临巨大挑战。
入选理由:Claude Opus 4.7在106个真实办公任务中仅完全通过3.8%(4个)
精选文章#AI Agent#大模型评测#自动化办公#SaaS-Bench#Claude中文
模型
别名:月之暗面Kimi
Moonshot研发的大型语言模型
已跟踪 30 条高相关材料
最近变化
2026-10-24 · Kimi 3.1 Pro参数达2.8T,活跃参数104BA,支持100万token上下文。
为什么值得关注
Kimi 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Claude 通过率不到4%,SaaS-Bench撕碎了Computer-Use的「全自动办公」幻想
量子位 · 9.2 分
SaaS-Bench评测显示主流大模型在真实办公任务中完全通过率不足4%,揭示AI全自动办公仍面临巨大挑战。
[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed
Latent Space · 8.5 分
Kimi 3.1 Pro发布2.8T参数模型,Highspeed API提速2-3倍,独立测试排名第四。
Kimi 发布开源旗舰模型 K3.1 Pro:2.8T 参数、100万 Token 上下文,实测 3D 与视频动效
AI HOT 精选 · 8.5 分
Kimi发布开源旗舰模型K3.1 Pro,参数达2.8T,支持100万Token上下文,实测3D与视频动效表现优异。
已收录 30 条与 Kimi 相关的内容,按评分排序。
SaaS-Bench评测显示主流大模型在真实办公任务中完全通过率不足4%,揭示AI全自动办公仍面临巨大挑战。
入选理由:Claude Opus 4.7在106个真实办公任务中仅完全通过3.8%(4个)
Kimi发布开源旗舰模型K3.1 Pro,参数达2.8T,支持100万Token上下文,实测3D与视频动效表现优异。
入选理由:K3.1 Pro模型参数达2.8T,支持100万Token上下文。
Kimi 3.1 Pro发布2.8T参数模型,Highspeed API提速2-3倍,独立测试排名第四。
入选理由:Kimi 3.1 Pro参数达2.8T,活跃参数104BA,支持100万token上下文。
Anthropic通过新防御策略将蒸馏攻击数据减少90%-99%,并实施收费拦截措施。
入选理由:新防御策略使外部团队获取的蒸馏数据减少90%-99%
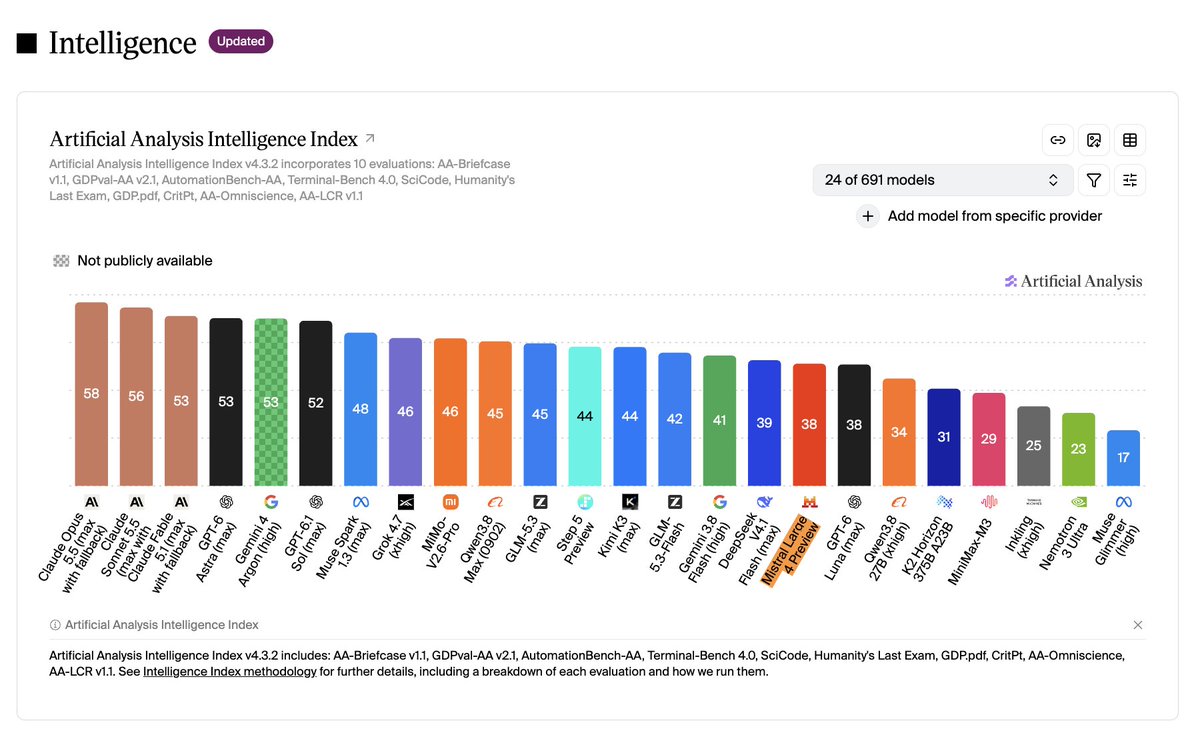
Mistral AI的Mistral Large 4模型在综合基准测试中排名38,接近中国顶尖开源模型,且在关键领域表现优于美国模型。
入选理由:Mistral Large 4拥有1T参数和多模态能力,是欧美最佳开源模型
放慢前沿步伐可同时解决能力、产品、定价等多重悬垂问题,但可能延长安全风险窗口期,竞争诉求与安全论证存在重叠。
入选理由:模型与harness整合是Agent差异化核心,利润将向整合端转移
AI生成PPT需结合HTML与Design System,避免依赖模板。当前AI操作PowerPoint效果不佳,最佳实践是用HTML生成网页PPT再转PPTX。
入选理由:Claude Design采用HTML生成PPT,保证美观且可二次编辑
中国开源模型在技术进展和企业应用上对美国形成显著优势,但存在国内限制。中美差距源于中国模型的快速迭代与美国开放权重模型的落后。
入选理由:GLM 5.2 是开放权重模型的重大突破,中国模型海外能力远超国内版本
引入AI员工需付出调试磨合、数据结构化和模型可靠性三重代价,实际落地仍需人类主导。
入选理由:调试和磨合阶段占AI员工部署成本的60%以上
真正的AI护城河在于数据、工程和基础设施,而非架构创新。卡内基梅隆大学教授Russ Salakhutdinov预测AGI短期内难以实现,模型竞争将转向产品化,预测系统可能取代传统咨询。
入选理由:AGI短期内无法实现,核心突破在数据和工程而非架构
Kimi模型团队在GTC keynote中展示了万亿参数模型、线性注意力机制和注意力残差技术,显著提升效率和性能。
入选理由:Kimi Linear线性注意力机制全面超越传统注意力机制
大模型参数规模突破T级得益于新型架构如Gated Delta Networks和Mamba的创新,英伟达、Kimi、Qwen等均采用混合架构优化性能。
入选理由:Gated Delta Networks基于Mamba思想,提升模型效率。
Dify平台推出Qubrid AI插件,通过单一API密钥集成DeepSeek、Kimi等多模型,解决AI应用开发中频繁切换模型的痛点。
入选理由:Qubrid AI插件支持DeepSeek、Kimi、Qwen等6大模型的一站式接入
小鹏汽车借助亚马逊云科技构建AI研发平台,实现代码覆盖率超70%,缺陷修复时间压缩至10分钟。
入选理由:小鹏汽车使用亚马逊云科技的Kiro、Bedrock等服务,实现AI代码覆盖率超过70%。
今年最值得升级的生产力工具,可能是一整张 AI 工位。文章推荐了五款 AI 工具,包括 Gemini 深度研究、Kimi、飞书 + Obsidian、Plaud、GPT-Image-2 + TapNow、Claude Code、Codex、清闲 OC1 Pro。这些工具在搜索、知识管理、会议记录、视觉表达、需求表达等方面提供了高效解决方案,帮助用户节省时间,提高工作效率。
入选理由:Gemini 深度研究和 Kimi 在搜索和中文资料处理方面表现出色,帮助用户快速整理信息和资料。
Databricks 提供了一个可靠的 LLM 推理平台,支持大规模多租户系统,通过先进的硬件和软件优化实现高可用性和低延迟。
入选理由:Databricks 平台支持多种前沿模型,包括开源和专有模型。
马斯克与 Anthropic 结盟后,Cursor 公司通过开发自己的 coding agent 产品来提升编程模型的质量。
入选理由:模型厂商应开发自己的 coding agent 产品以获得高质量的强化学习数据。
Tasklet 通过重构技术栈,打造多模型中立平台,未来软件将分为横向平台、Headless API 和解决方案公司三类。
入选理由:Tasklet 六个月推翻所有代码,转向通用 AI Agent 平台。
Kimi WebBridge让AI Agent像真人一样操作浏览器,挑战Codex封闭生态。
入选理由:Kimi WebBridge实现AI Agent与浏览器的深度交互
Hermes 支持配置多个国内外 AI 模型,包括 GPT-5.5、Grok-4.3、Gemini 等。
入选理由:订阅 ChatGPT Plus 可配置 gpt-5.5 模型
Kimi K2.6通过TiDB Cloud实现“人手一个数据库”,解决AI Agent建站的成本、规模与性能难题。
入选理由:TiDB Cloud的Serverless Cluster支持百万级独立数据库实例,单位经济可行。
开发者自制Obsidian电子书阅读器,支持多格式与多AI模型集成,代码开源且无需额外付费。
入选理由:支持EPUB/PDF/MOBI等8种电子书格式解析
Google DeepMind因人才流失和Gemini模型延迟面临挑战,中国开源模型崛起成为竞争焦点。
入选理由:Jeff Dean等核心成员创办Discovery Loop专注科学发现
无问芯穹作为中立AI基础设施服务商,支撑国产大模型Token爆发,日均调用量两年增20倍,获近22亿融资,成AGI时代核心枢纽。
入选理由:Agent时代推动单次任务Token消耗飙升至十万甚至百万级,倒逼AI底层架构升级。
通过集成AI模型和中文优化,Obsidian可升级为强大的Epub阅读器,支持本地模型调用和多模型配置。
入选理由:支持Codex、Claude、Grok CLI及DeepSeek等7个主流AI模型
作者预测2026年将是AI发展的关键一年,开放模型将面临更多挑战和机遇。
入选理由:2026年将是AI发展的关键一年,开放模型将面临更多挑战和机遇。
Cursor发布Composer 2.5模型,以Kimi为基础并投入85%总算力进行自研训练,性能接近Claude Opus 4.7但成本仅为十分之一,通过定向反馈RL和25倍合成数据实现技术突破。
入选理由:Composer 2.5在SWE-Bench等基准测试中表现接近Claude Opus 4.7,但价格仅为后者的1/10。
GPT-5.5 在推理能力与简洁性上实现显著突破,开发者 Greg Brockman 和 DHH 均表示其性能优于 GPT-4、Kimi 等模型,且在低推理模式下仍保持高效。
入选理由:GPT-5.5 在低推理模式下表现优异,无需切换至 Opus 模型即可满足需求
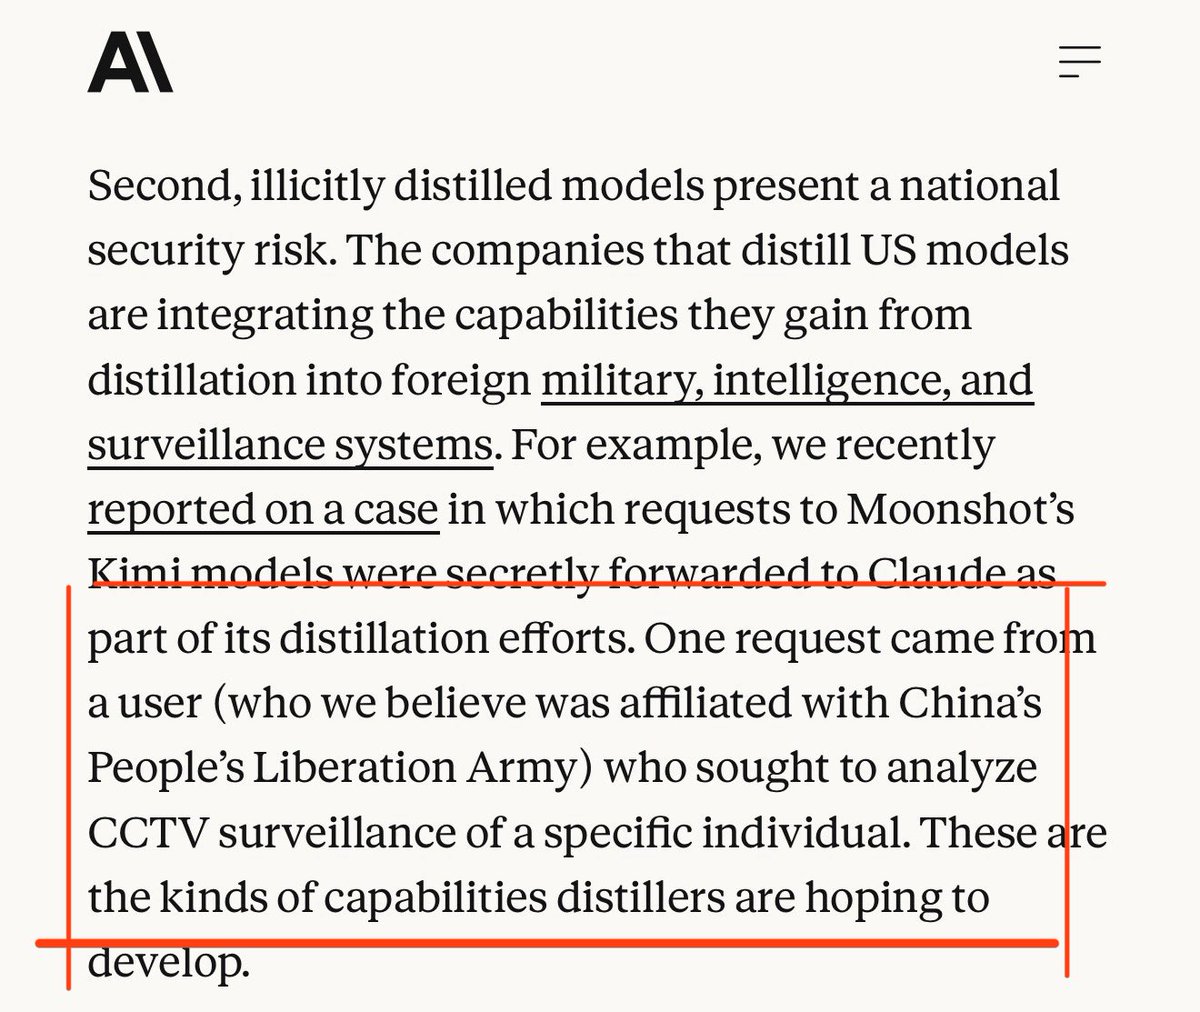
Moonshot被曝将用户请求秘密转发至Claude用于模型蒸馏,Anthropic披露中国军方关联用户曾用Kimi分析成都监控数据。
入选理由:Moonshot涉嫌将Kimi用户请求转发至Claude用于模型蒸馏
文章强调开放权重模型对防止AGI被少数公司垄断的重要性,但信息密度较低,缺乏技术细节。
入选理由:开放权重模型是避免AGI被少数实体控制的关键手段