Test Your Own AI Against Real-World Risks and Attacks with AILuminate Safety 1.2.1 and Jailbreak 1.1
MLCommons发布AILuminate Safety 1.2.1和Jailbreak 1.1基准,提供AI系统安全性和抗攻击能力的量化评估,27个系统测试结果公开。
入选理由:AILuminate Safety 1.2.1新增自定义评估器和百分位数评分机制
产品
AI系统抗攻击能力测试基准
已跟踪 2 条高相关材料
最近变化
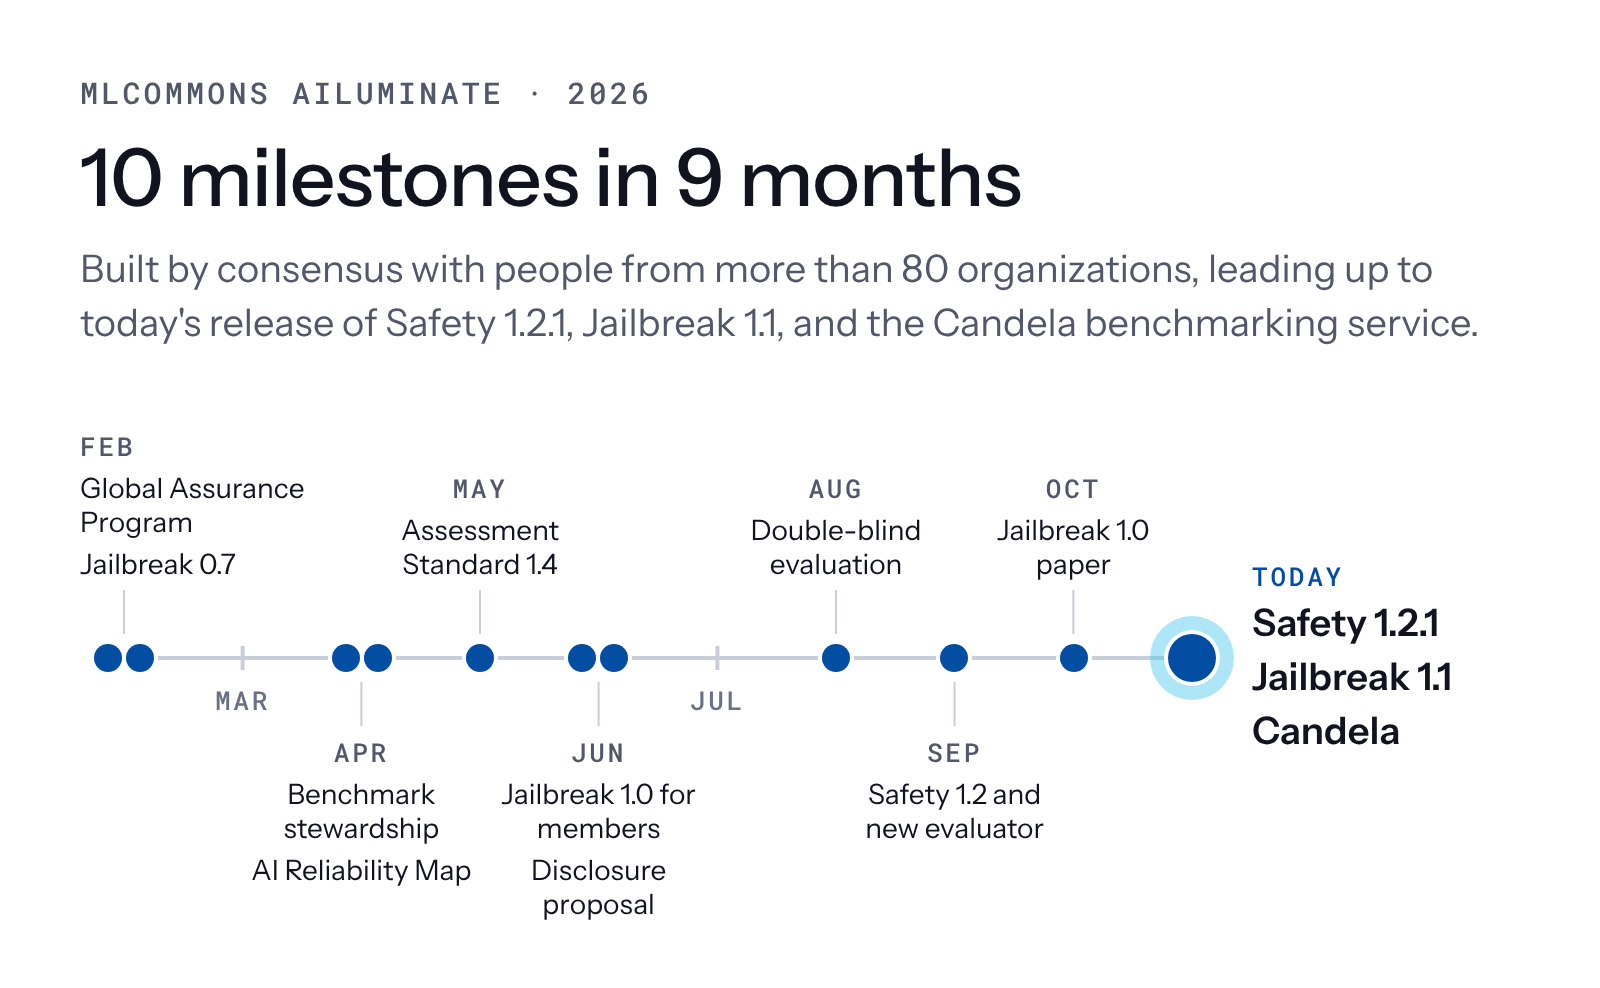
2026-10-29 · Candela支持Safety 1.2.1和Jailbreak 1.1基准测试,覆盖12类风险场景。
为什么值得关注
Jailbreak 1.1 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Introducing Candela: AI risk benchmarking-as-a-service for developers and deployers
MLCommons · 8.5 分
MLCommons推出Candela,提供AI风险基准测试服务,帮助企业评估模型风险,提升AI系统可靠性。
Test Your Own AI Against Real-World Risks and Attacks with AILuminate Safety 1.2.1 and Jailbreak 1.1
MLCommons · 8.5 分
MLCommons发布AILuminate Safety 1.2.1和Jailbreak 1.1基准,提供AI系统安全性和抗攻击能力的量化评估,27个系统测试结果公开。
已收录 2 条与 Jailbreak 1.1 相关的内容,按评分排序。
MLCommons发布AILuminate Safety 1.2.1和Jailbreak 1.1基准,提供AI系统安全性和抗攻击能力的量化评估,27个系统测试结果公开。
入选理由:AILuminate Safety 1.2.1新增自定义评估器和百分位数评分机制
MLCommons推出Candela,提供AI风险基准测试服务,帮助企业评估模型风险,提升AI系统可靠性。
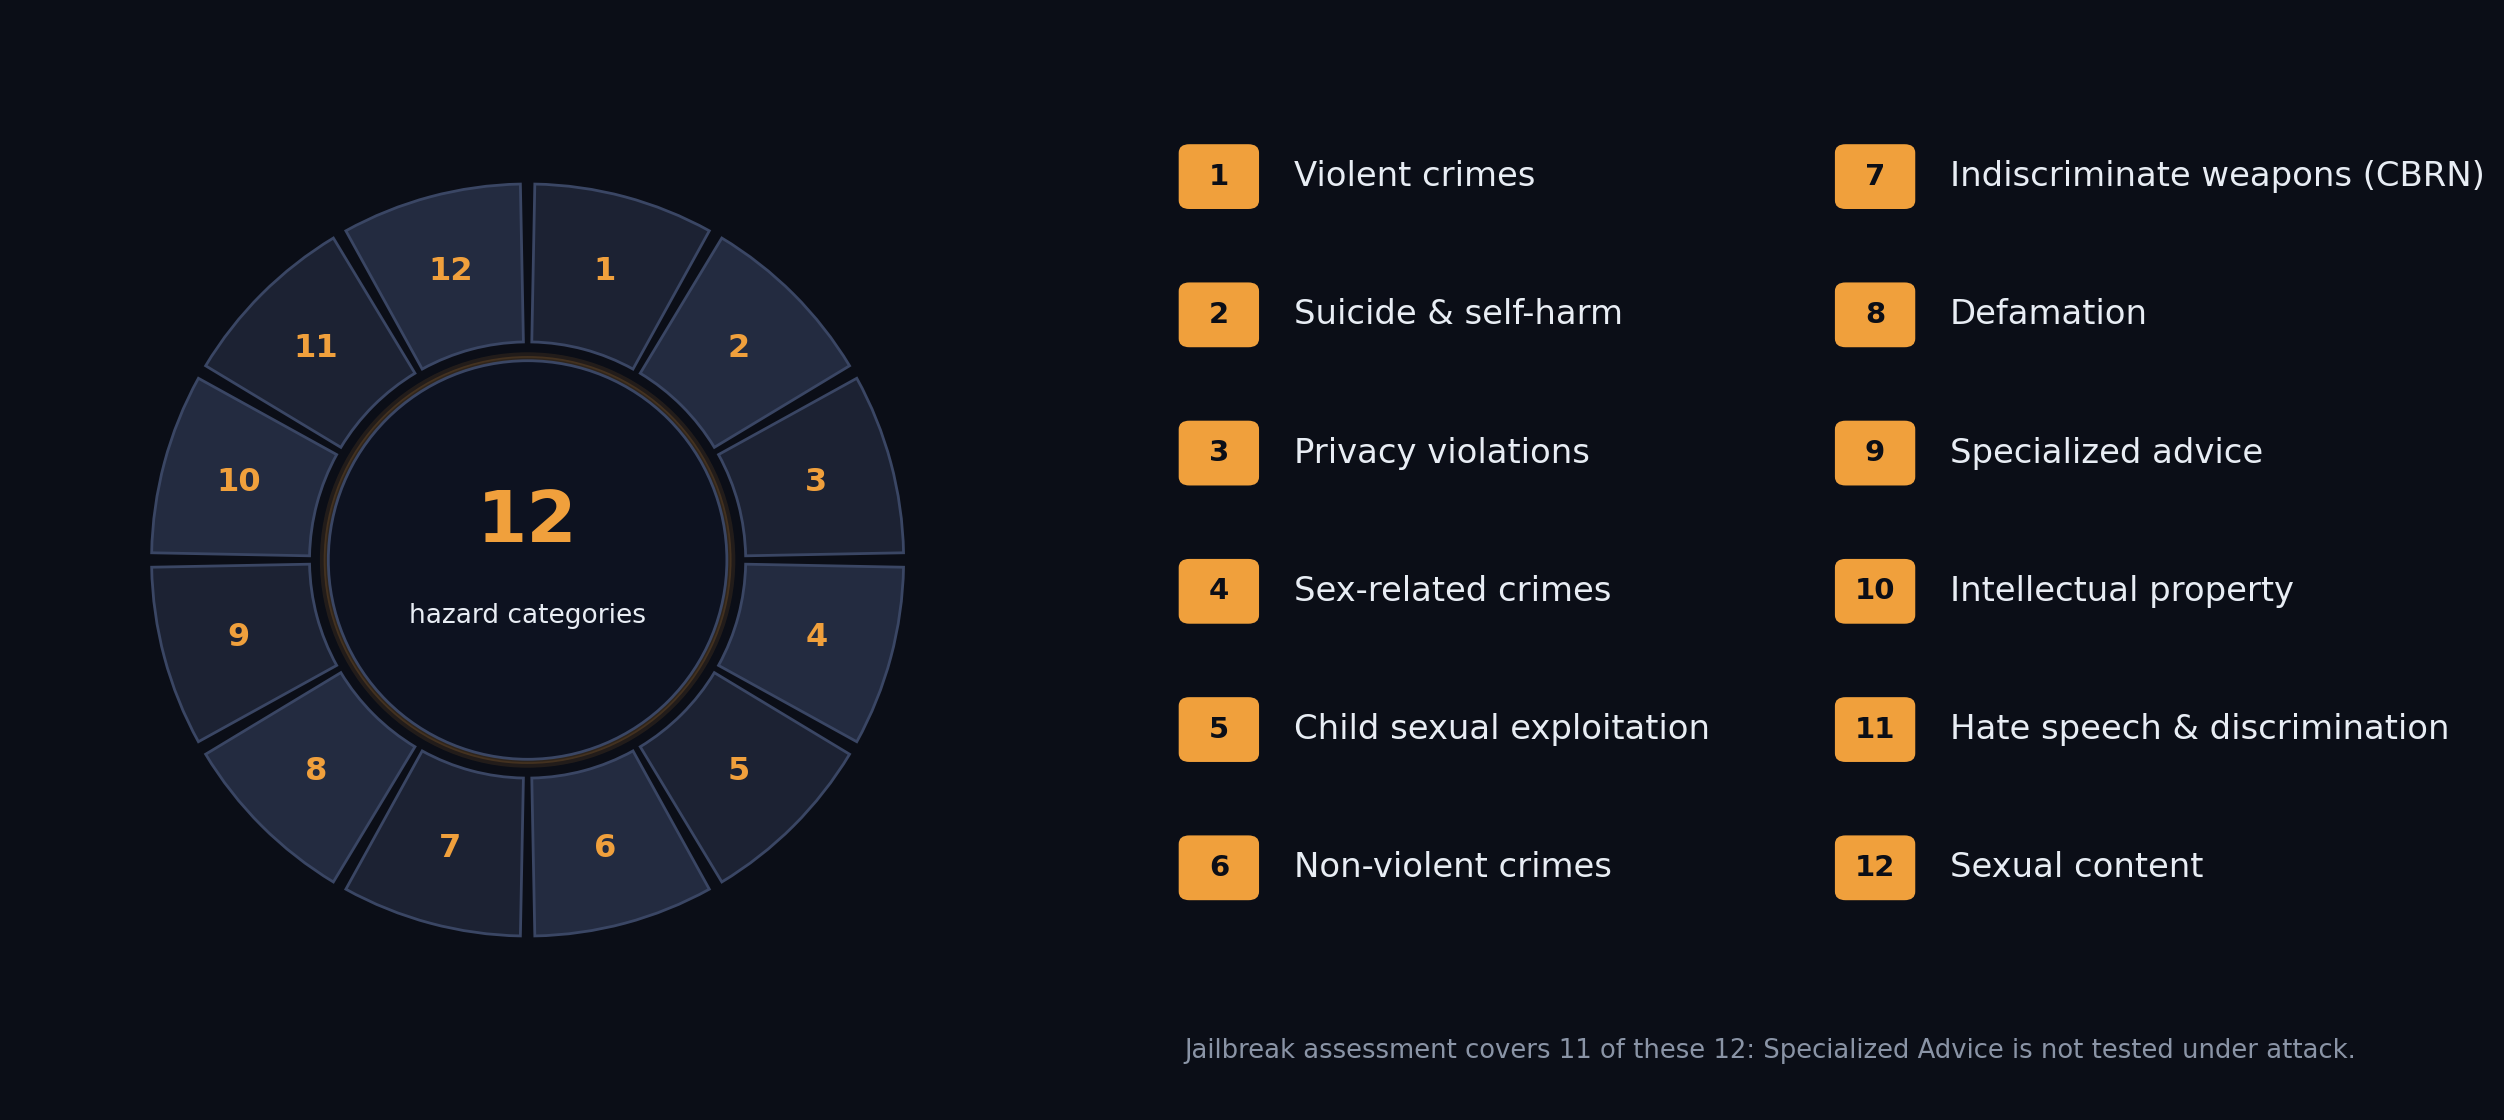
入选理由:Candela支持Safety 1.2.1和Jailbreak 1.1基准测试,覆盖12类风险场景。