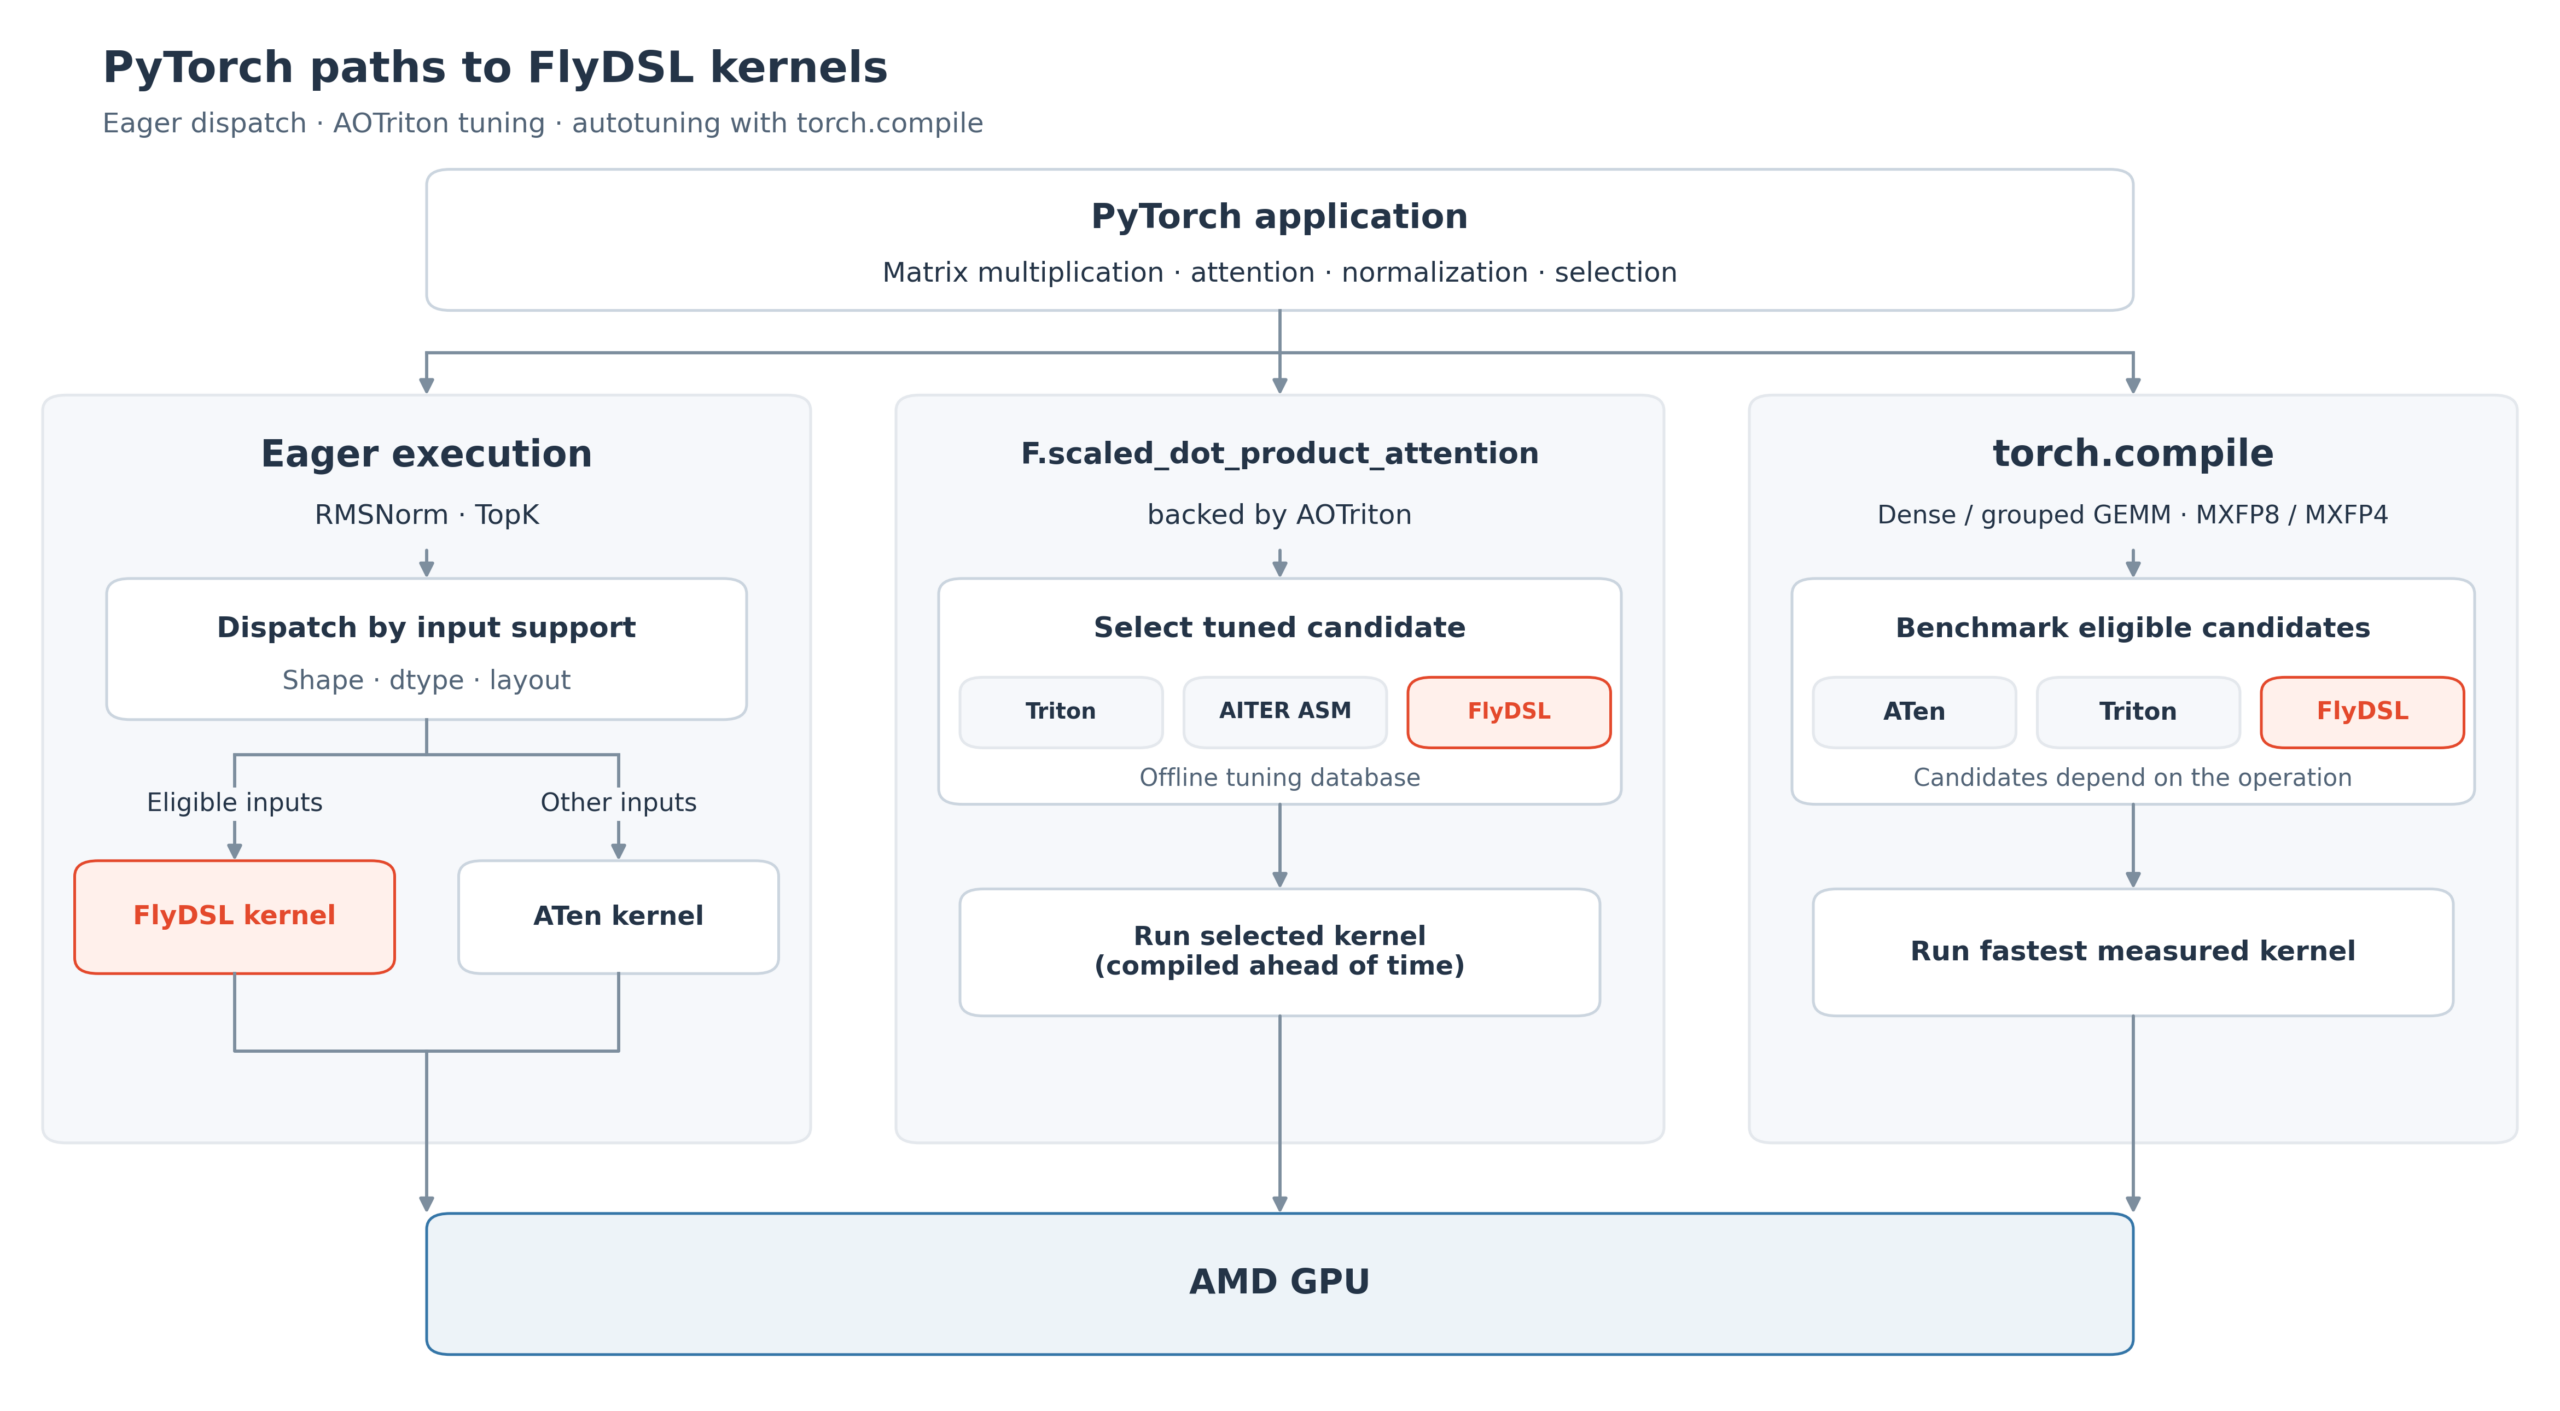
Accelerating PyTorch on AMD GPUs with FlyDSL
PyTorch Blog4733 字 (约 19 分钟)
85
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
精选文章#PyTorch#AMD GPU#FlyDSL#性能优化#深度学习框架英文
概念
别名:General Matrix Multiply
通用矩阵乘法运算
已跟踪 3 条高相关材料
最近变化
2026-10-21 · FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
为什么值得关注
GEMM 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Accelerating PyTorch on AMD GPUs with FlyDSL
PyTorch Blog · 8.5 分
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
How to use Google microbenchmarks for evaluating TPU performance
Google Developers Blog · 8.5 分
Google发布的微基准测试套件可量化评估TPU性能,涵盖网络、计算、内存等关键模块。
SpenseGPT Practical One-shot Pruning Enabling Sparse and Dense GEMMs for LLM Inference
AK(@_akhaliq) · 8.5 分
SpenseGPT 提出了一种实用的单次剪枝方法,优化了大语言模型推理中的稀疏和密集 GEMM 计算。
已收录 3 条与 GEMM 相关的内容,按评分排序。
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
Google发布的微基准测试套件可量化评估TPU性能,涵盖网络、计算、内存等关键模块。
入选理由:微基准测试套件包含网络、计算、HBM、主机传输和RPAv3五大核心指标
SpenseGPT 提出了一种实用的单次剪枝方法,优化了大语言模型推理中的稀疏和密集 GEMM 计算。
入选理由:SpenseGPT 通过单次剪枝实现稀疏和密集 GEMM 的优化。
