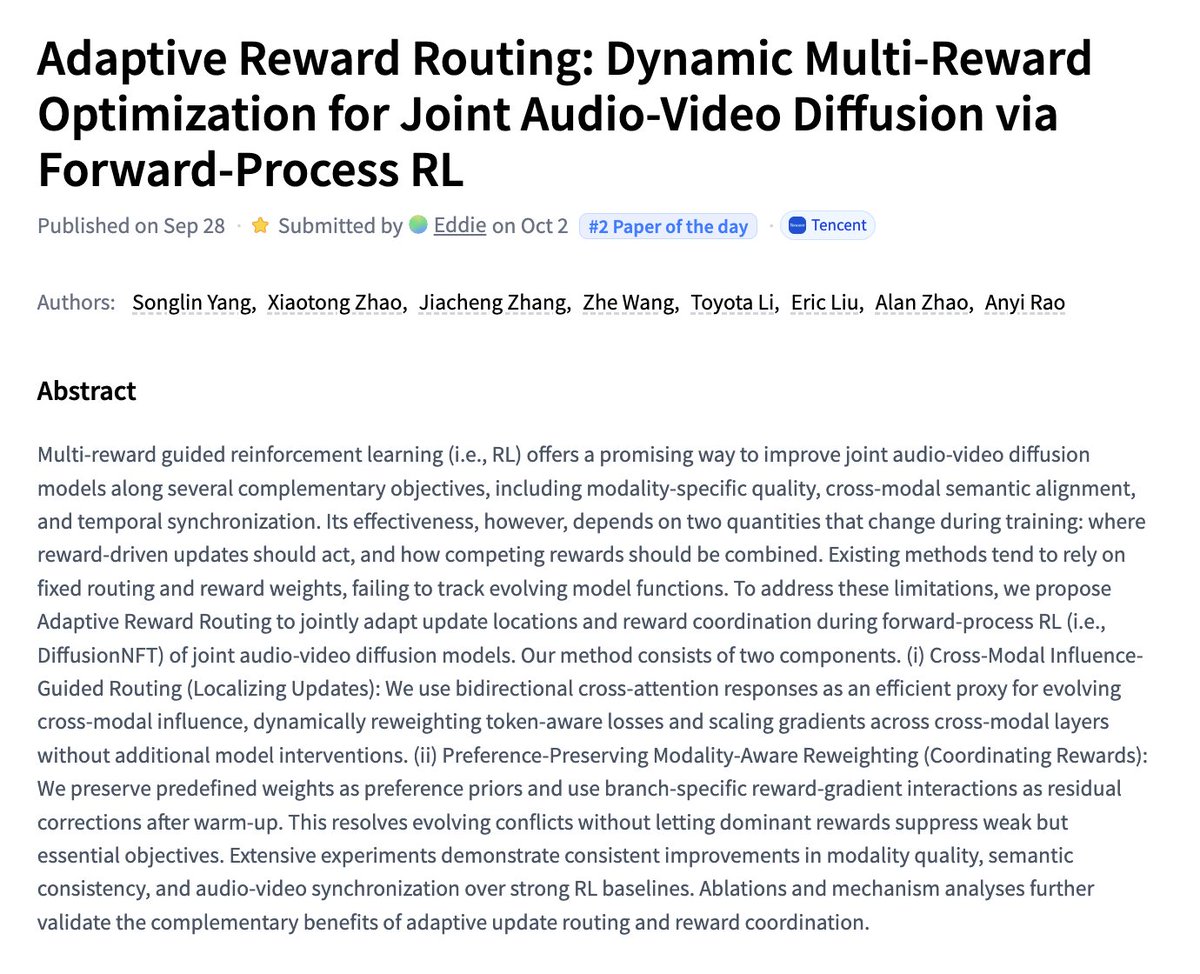
Adaptive Reward Routing Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forwa...
AK(@_akhaliq)57 字 (约 1 分钟)
85
该论文提出基于强化学习的音频视频扩散模型多奖励优化方法,通过动态奖励路由实现跨模态生成。
入选理由:Forward-Process RL框架可提升多模态扩散模型的奖励对齐效率30%以上
精选推文#强化学习#多模态生成#扩散模型#Hugging Face英文