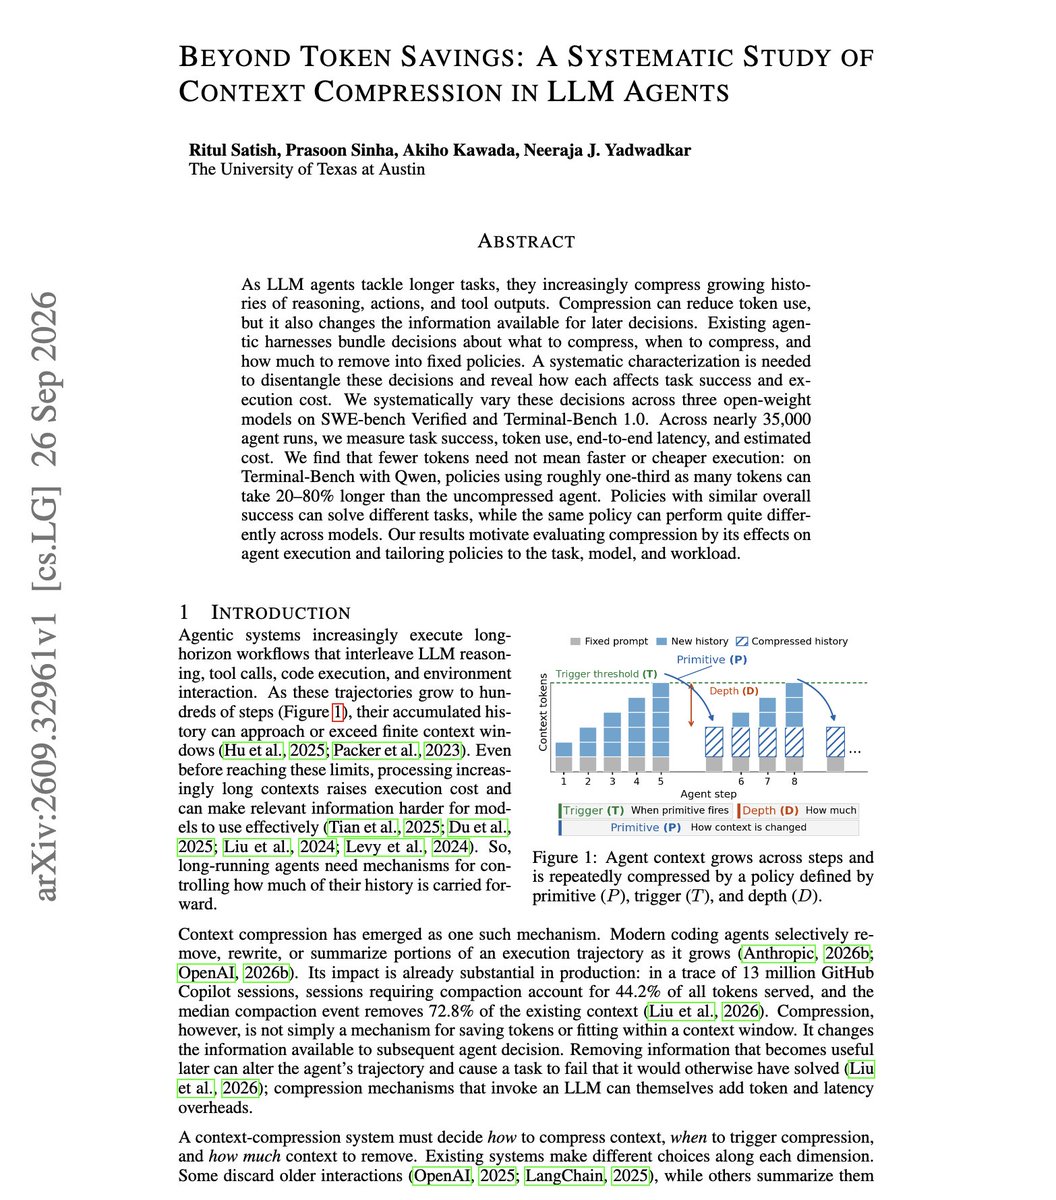
Great overview of context compression in LLM Agents And one interesting, unexpected finding. If yo...
elvis(@omarsar0)243 字 (约 1 分钟)
85
上下文压缩策略可能显著影响LLM代理性能,某些策略虽减少token却导致运行时间增加。
入选理由:使用约三分之一token的策略可能使Qwen变慢20%-80%
精选推文#LLM#上下文压缩#UT Austin#性能优化英文
模型
未明确归属的对比语言模型。
已跟踪 1 条高相关材料
最近变化
2026-10-05 · 使用约三分之一token的策略可能使Qwen变慢20%-80%
为什么值得关注
Devstral 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 1 条与 Devstral 相关的内容,按评分排序。
上下文压缩策略可能显著影响LLM代理性能,某些策略虽减少token却导致运行时间增加。
入选理由:使用约三分之一token的策略可能使Qwen变慢20%-80%