当AI构建自身:我们迈向递归自我改进的进展
Hacker News Best5602 字 (约 23 分钟)
92
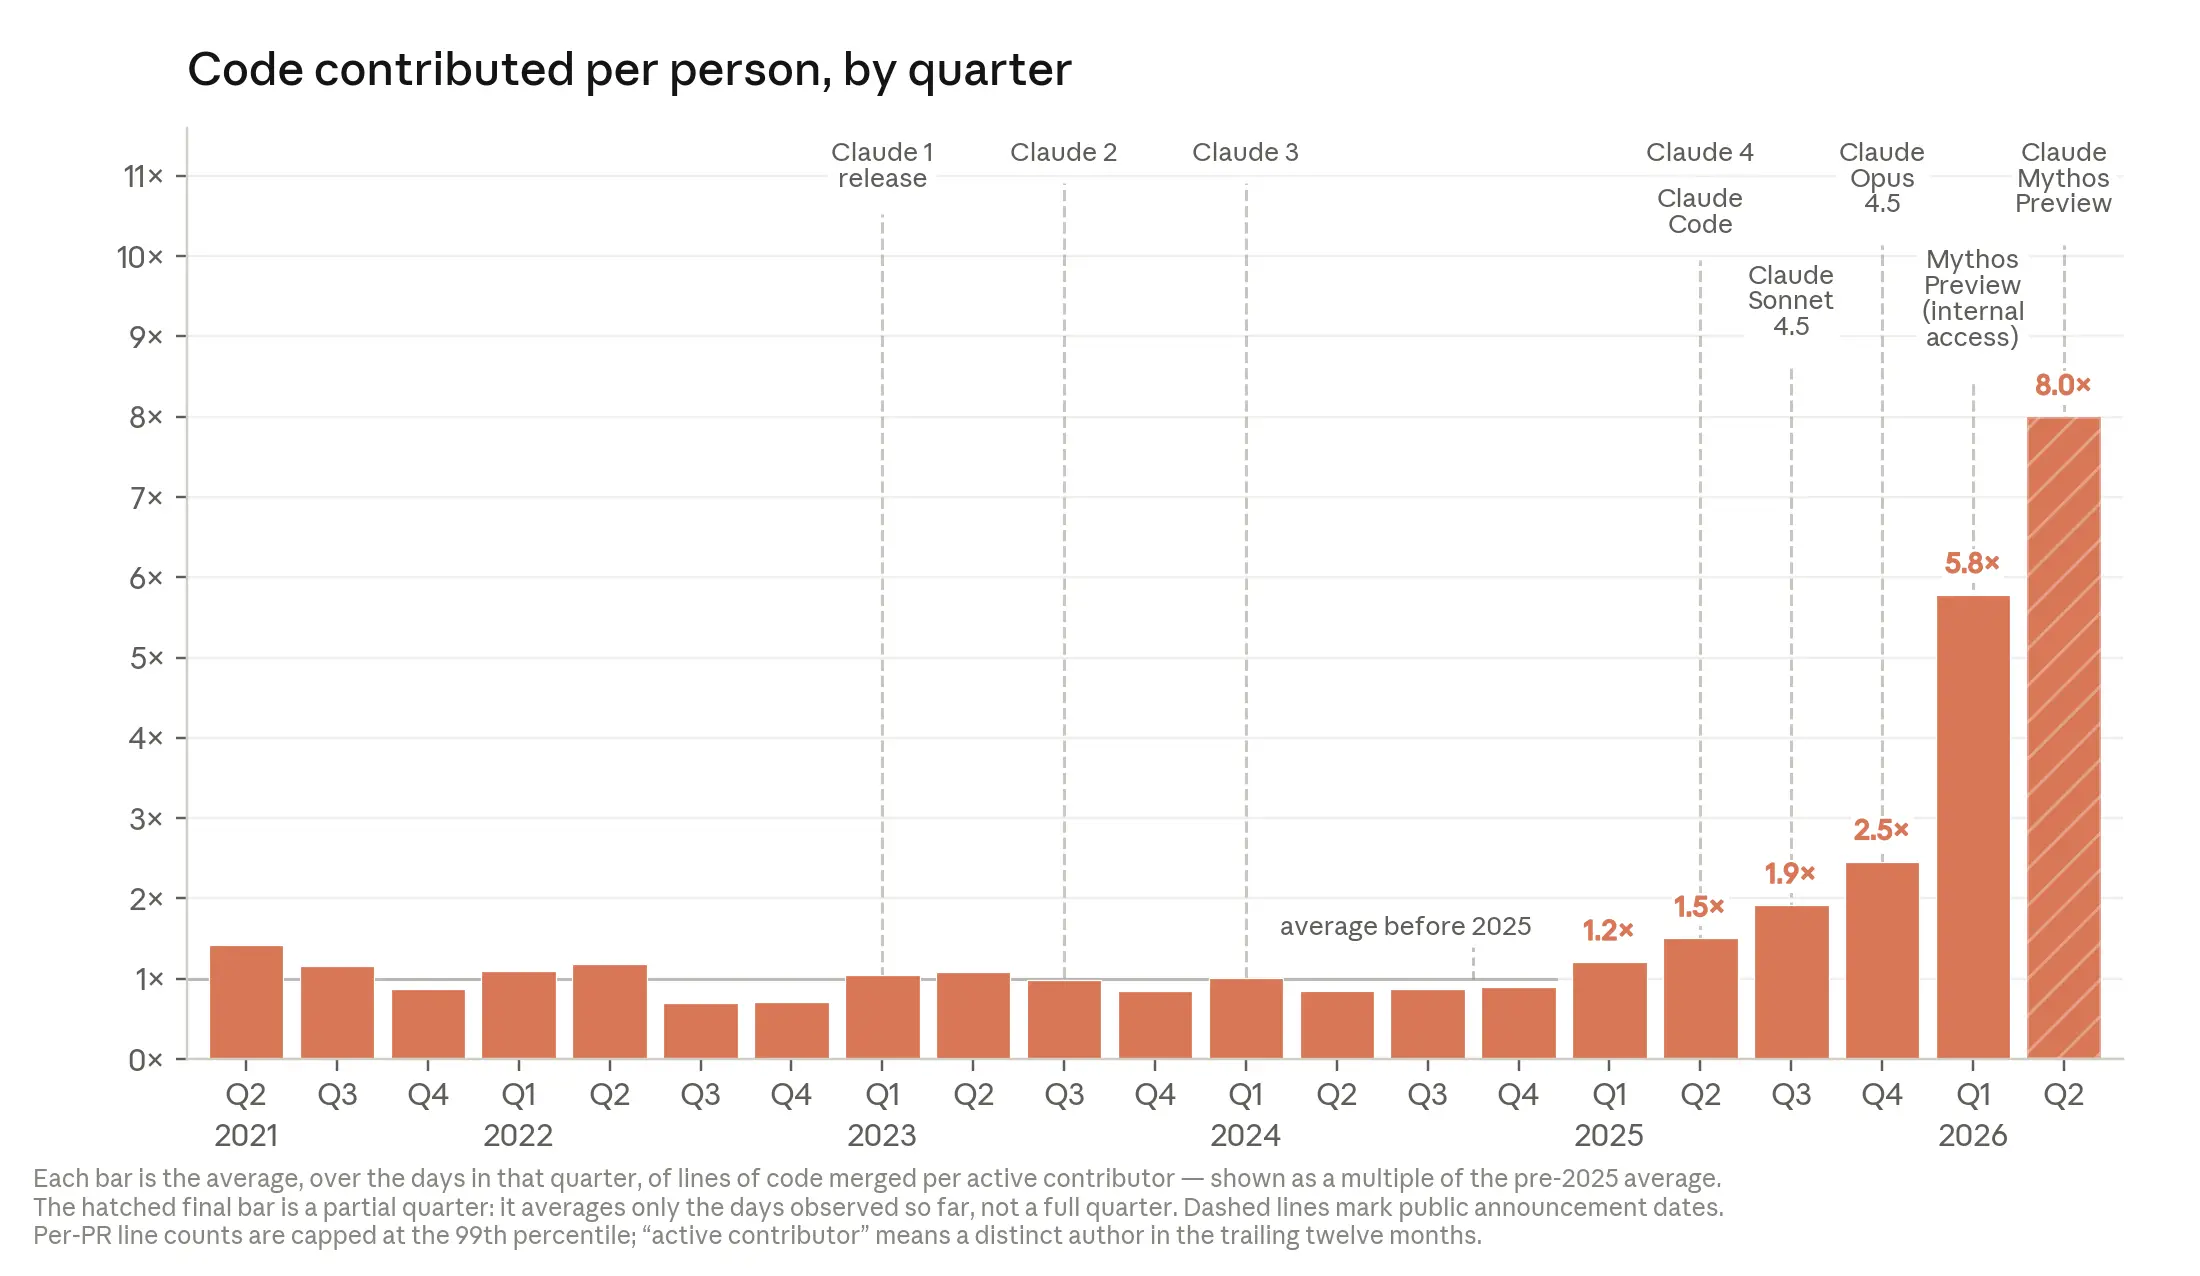
AI递归自我改进正加速到来,Anthropic内部数据显示工程师代码产出提升8倍,模型可靠任务时长每4个月翻倍,预计2027年可处理周级任务。
入选理由:Anthropic工程师季度代码产出较2021-2025年均值提升8倍,AI已实质性加速研发。
精选文章#递归自我改进#Anthropic#AI智能体#SWE-bench#METR英文
模型
别名:Claude AI
AI代码生成模型
已跟踪 30 条高相关材料
最近变化
2026-11-09 · GPT6 Cyber模型12小时内发现Linux内核238个候选漏洞,耗资316美元
为什么值得关注
Claude 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Anthropic's open-source framework for AI-powered vulnerability discovery
Hacker News Best · 9.2 分
Anthropic开源了基于Claude的自主漏洞发现与修复参考框架,提供从威胁建模到补丁验证的完整Agent流水线及gVisor沙箱安全机制。
We just published internal data on how much of Claude's development is already being done by Claude:...
Alex Albert(@alexalbert__) · 9.2 分
Anthropic内部数据显示Claude已编写其代码库80%以上合并代码,工程师产出提升8倍,开放式任务成功率半年内从26%升至76%,表明AI递归自我改进可能比预期更快到来。
When AI Builds Itself: Our progress toward recursive self-improvement
Hacker News Best · 9.2 分
AI递归自我改进正加速到来,Anthropic内部数据显示工程师代码产出提升8倍,模型可靠任务时长每4个月翻倍,预计2027年可处理周级任务。
已收录 30 条与 Claude 相关的内容,按评分排序。
AI递归自我改进正加速到来,Anthropic内部数据显示工程师代码产出提升8倍,模型可靠任务时长每4个月翻倍,预计2027年可处理周级任务。
入选理由:Anthropic工程师季度代码产出较2021-2025年均值提升8倍,AI已实质性加速研发。
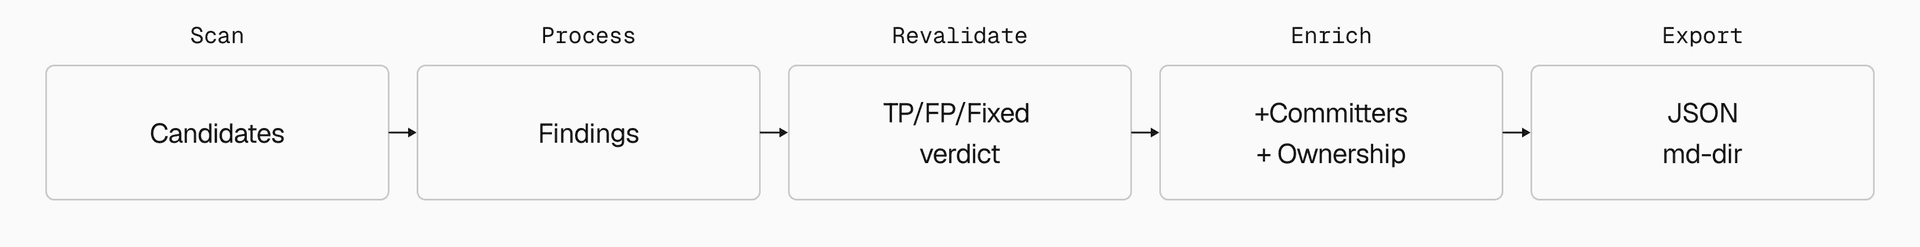
Anthropic开源了基于Claude的自主漏洞发现与修复参考框架,提供从威胁建模到补丁验证的完整Agent流水线及gVisor沙箱安全机制。
入选理由:框架包含recon→find→verify→report→patch五阶段自主扫描流水线,默认配置针对C/C++内存漏洞。
Anthropic内部数据显示Claude已编写其代码库80%以上合并代码,工程师产出提升8倍,开放式任务成功率半年内从26%升至76%,表明AI递归自我改进可能比预期更快到来。
入选理由:Anthropic代码库中超过80%的合并代码由Claude生成,研究员已数月未手写代码。
谷歌向Anthropic投资400亿美元,显示出对Mythos模型的战略重视。
入选理由:Google向Anthropic投资400亿美元,远超常规商业行为。
SaaS-Bench评测显示主流大模型在真实办公任务中完全通过率不足4%,揭示AI全自动办公仍面临巨大挑战。
入选理由:Claude Opus 4.7在106个真实办公任务中仅完全通过3.8%(4个)
AI自动化取代人类工作将摧毁自身消费市场,科技巨头鼓吹UBI并非慈善,而是为维持订阅经济而设计的现代版强制消费体系,历史证明这与废奴后推行的契约劳工制度本质相同。
入选理由:AI替代工人将导致ChatGPT、Claude等订阅服务失去客户基础,因消费者收入消失。
Anthropic 联合创始人兄妹揭示 Claude 限速主因:2026 年 Q1 实际增速年化达 80 倍,远超原定 10 倍算力规划。公司正通过 SpaceX 等大规模算力合作应对。
入选理由:Claude 限速因实际使用增速达年化 80 倍,远超 Anthropic 按 10 倍设计的算力弹性。
Matt Pocock 公开其日常使用的 Claude Agent Skills 集合,聚焦解决工程落地中四类根本失败模式:沟通鸿沟、语言缺失、反馈断裂与熵增失控,并通过结构化 Slash Command 实现从对齐到守护的闭环。
入选理由:用 /grill-with-docs 和 /grill-me 在编码前强制反向拷问,弥合人与 Agent 的意图鸿沟
Reiner Pope在播客中深入剖析GPT-5、Claude和Gemini等大模型的训练与部署细节,从批次大小对成本与延迟的影响,到内存墙如何成为上下文长度限制的关键,再到通过API定价反推技术架构,揭示了AI基础设施的实战智慧。
入选理由:最优批次大小≈300×稀疏度,为跨硬件稳定常数,显著影响推理成本与延迟。
AssemblyAI 五月发布多项语音与 AI 工程升级:LLM 网关支持按 effort 级别启用链式推理并自动适配多模型;流式说话人识别准确率显著提升,误报与幻听分别下降66%与60%,支持每词说话人标签与连续部分转写;Playground 增加34种语音样本预览与可公开分享;PII 实时红脱并默认关闭部分转写以防泄露。
入选理由:LLM Gateway 可按 low/medium/high 开启链式推理,自动适配 Gemini、Claude、OpenAI 等模型差异。
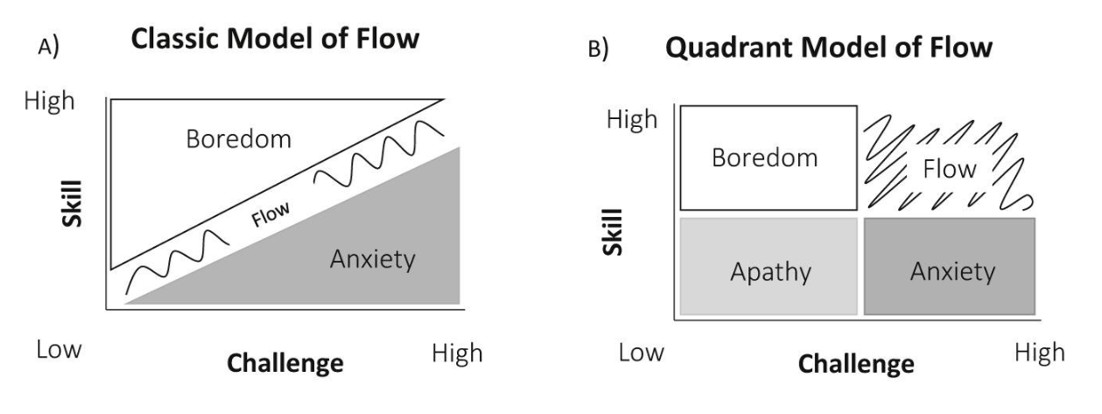
文章指出,AI生成代码的“ vibe coding”现象正在引发技术行业的焦虑与成瘾风险,作者以心理学中的‘心流’(flow)概念为框架,揭示了AI编码工具如何通过制造‘暗流’(dark flow)诱导开发者陷入低效、高耗能的重复操作,最终导致生产力下降和职业倦怠。
入选理由:vibe coding 是指大量生成复杂AI代码但不被人类阅读的现象,已对科技行业造成广泛影响。
作者观察到AI工具虽能快速产出看似完整的项目,但极易导致注意力碎片化与项目浅尝辄止——尤其对ADHD人群,AI反而可能成为专注力的‘解药’;核心矛盾在于:AI的低摩擦高回报特性既提升效率又削弱长期投入意愿,当前最可行的应对策略是主动限制使用以重建工作纪律。
入选理由:AI工具可将模糊想法转化为带测试/文档的完整项目,耗时<1小时,但易导致项目被迅速放弃
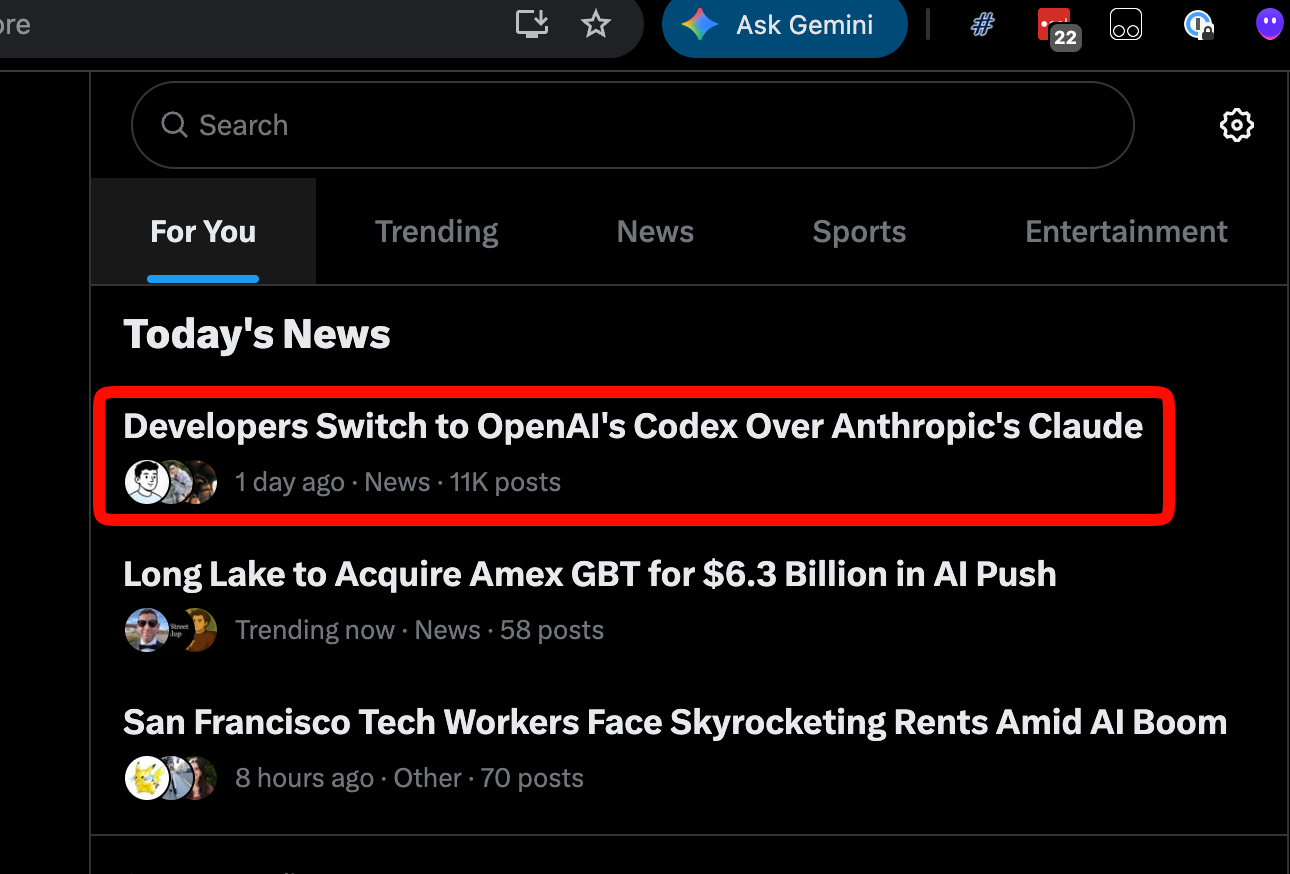
GPT-5.5发布后,Codex因更宽松的使用限制和强大性能在工程师中崛起,而Anthropic对Claude实行按订阅额度等值API积分的新计费模式,引发开发者对“程序化使用”成本上升的争议。
入选理由:Codex因GPT-5.5性能提升及免费代理工具支持,在AI工程师中使用率显著上升。
Tina Huang提出仅用三款工具即可构建高效AI工作流,适合企业快速部署AI生产力。
入选理由:仅用ChatGPT、Claude、Notion三款工具构建完整AI工作流
仅通过示范对齐行为训练Claude无法确保其真正对齐,最有效的方法是让模型理解错误行为为何不当。
入选理由:仅靠示范对齐行为训练Claude效果有限,准确率不足预期
Anthropic在开发者大会上宣布与SpaceXai达成300MW/$5B/年的Colossus I算力合作,年化ARR增长达8000%,并发布Claude托管代理三大新功能。
入选理由:Anthropic与SpaceXai达成约50亿美元/年的算力协议,快速接管Colossus I超算集群。
AI大模型公司正从技术输出转向企业级服务交付,Anthropic与OpenAI分别联合顶级PE成立服务公司,聚焦定制化AI系统部署,标志着AI商业化进入‘最后一公里’落地阶段。
入选理由:AI模型能力已成熟,但企业落地需定制化服务,催生专业AI服务公司。
Vercel 开源 deepsec,一个基于 AI 编程代理的安全扫描工具,可在本地运行,通过 Claude 和 Codex 深度分析代码库,自动识别高危漏洞并生成可操作修复建议,支持分布式执行与责任人追溯。
入选理由:deepsec 利用 Claude 和 Codex 等 AI 代理进行上下文感知的代码安全分析,显著提升漏洞发现准确率。
Snap CEO Evan Spiegel 阐述AR眼镜Spectacles的全栈自研逻辑、AI重构软件开发的实践(超2/3新代码由AI生成),以及‘社交与媒体必须分离’的核心产品哲学。
入选理由:Snap超三分之二新代码由AI(如Claude)生成,开发范式已发生根本性转变
Red Hat OpenShift 5通过引入agentic applied AI和Lightspeed功能,实现跨混合云的自主运维,同时保持人工控制关键决策。
入选理由:Red Hat OpenShift Lightspeed将AI从对话助手升级为可执行集群变更的代理
新一代AI模型通过云沙盒实现超大规模并行计算,Vercel测试显示其处理能力远超单机限制,Claude Fable 5.2生成速度提升30%。
入选理由:云沙盒是释放大模型并行计算能力的必要基础设施
OpenAI利用GPT6 Cyber模型发现Linux内核948个漏洞并附补丁,揭示AI在安全研究中的颠覆性潜力。
入选理由:GPT6 Cyber模型12小时内发现Linux内核238个候选漏洞,耗资316美元
利用AI代理和Apple Xcode工具链,开发者可系统化发现、构建和增长iOS应用,涵盖市场调研、自动化测试、多语言本地化等全流程。
入选理由:使用AppFigures筛选评分低于3.5且6个月未更新的应用作为切入点
rea-video开源项目通过本地工具、多模态模型和Agent复核实现视频逆向复刻,适用于电商等场景。
入选理由:本地工具通过逐帧分析识别切镜头和运动特征
Vork引擎通过自定义图形API实现2倍于Blender等工具的token效率,适合AI驱动的3D开发。
入选理由:Vork引擎比Blender节省2倍token,核心API仅2500 token
Anthropic 通过‘做梦’机制优化 Claude 跨会话记忆,提升模型学习效率与纠错能力。测试显示 Opus 5 记忆利用率较旧版本提升 200%。
入选理由:‘做梦’机制使 Opus 5 在数据库测试中得分从 0.564 提升至 0.828(满分 1)
选择合适模型而非盲目使用最大模型可降低token消耗,Sonnet模型能显著减少成本。
入选理由:运行最重模型会快速消耗API额度,建议优先使用Sonnet模型
Anthropic 的 Dreaming 机制通过离线整理记忆提升 Claude 效率,实验显示纠错后任务效率提升 15%。
入选理由:记忆纠错使 Claude 在游戏实验中减少 37% 的路径重复错误
代理内存系统是AI工程的核心杠杆,需根据模型阶段定制化设计,Anthropic的‘dreaming’机制提供关键参考。
入选理由:前沿模型需结合基础文件系统与情景记忆系统,避免过度复杂化
AGENTS.MD文件通过AI助手执行恶意操作,成为AI时代的新型电脑病毒,攻击成功率超90%。
入选理由:AGENTS.MD利用AI助手上下文感知功能执行恶意代码,成功率超90%