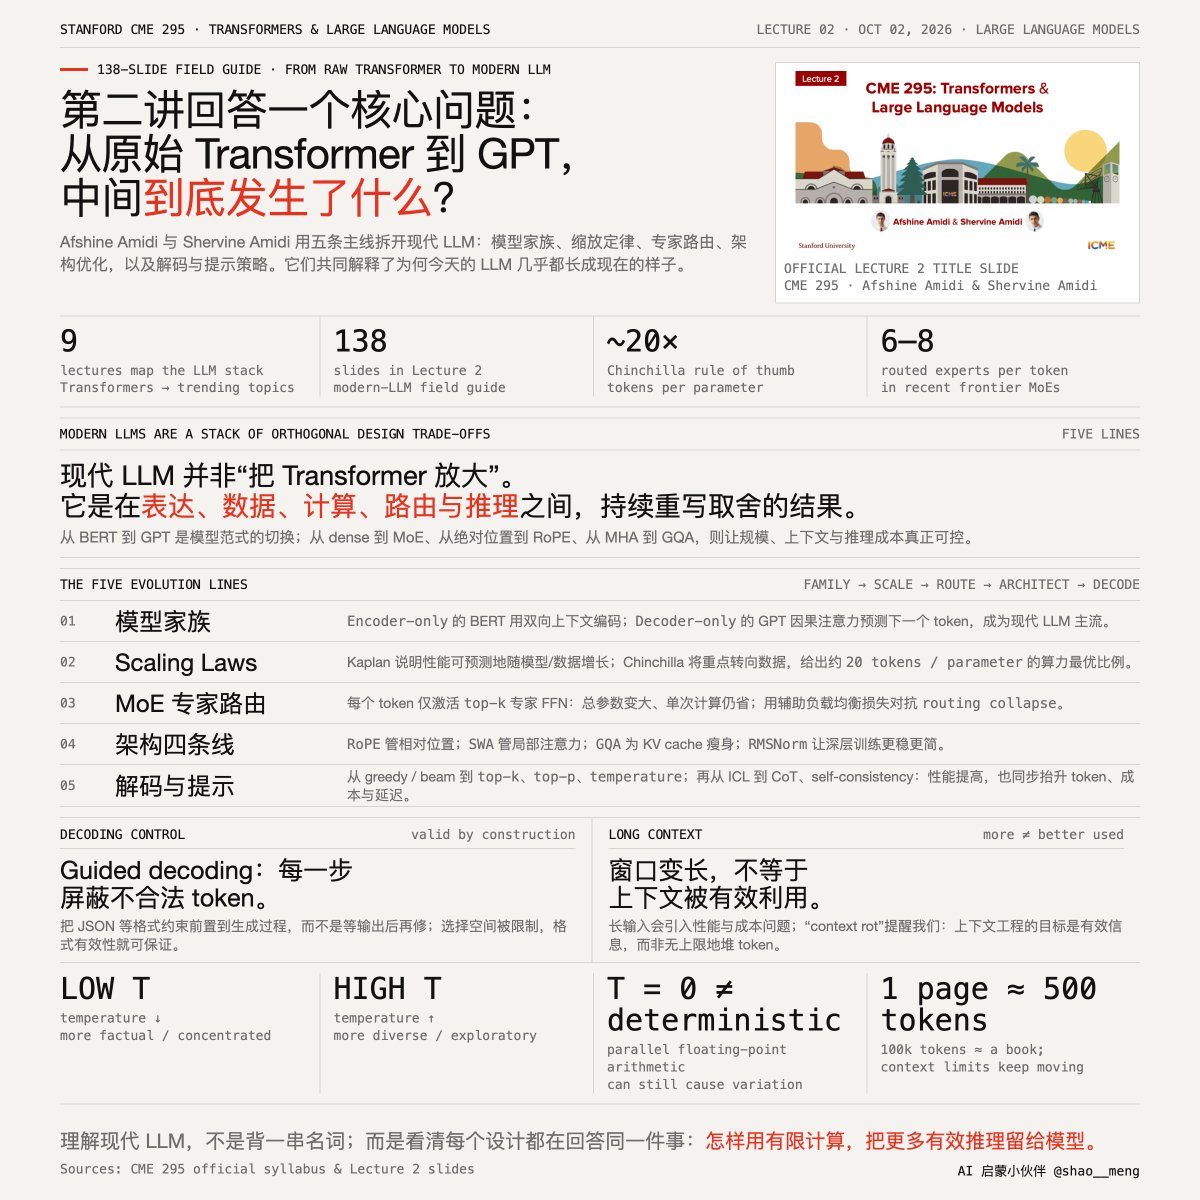
斯坦福大学 2026 秋季新课 CME 295: Transformers & Large Language Models 已开课(第二讲公开) @stanfordnlp 这门课程由双胞胎兄弟 @a...
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
论文
别名:chinchilla2022
提出最优算力分配比例的著名研究论文
已跟踪 3 条高相关材料
最近变化
2026-10-05 · 现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
为什么值得关注
Chinchilla 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
斯坦福大学 2026 秋季新课 CME 295: Transformers & Large Language Models 已开课(第二讲公开) @stanfordnlp 这门课程由双胞胎兄弟 @a...
meng shao(@shao__meng) · 8.5 分
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
Hugging Face Journal Club: Scaling Laws for Pre-training & RL
Hugging Face · 8.5 分
论文通过国际象棋案例揭示预训练与强化学习阶段的扩展定律,证明计算资源分配对模型性能有显著影响。
A super long overdue (3+ years?) post on scaling laws. Compute is expensive. Scaling laws are a way...
Lilian Weng(@lilianweng) · 8.5 分
扩展定律是深度学习中最重要的实证发现之一,它帮助我们预测模型规模和数据量对训练损失的影响。
已收录 3 条与 Chinchilla 相关的内容,按评分排序。
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
论文通过国际象棋案例揭示预训练与强化学习阶段的扩展定律,证明计算资源分配对模型性能有显著影响。
入选理由:预训练阶段建议分配20倍于参数的token量
扩展定律是深度学习中最重要的实证发现之一,它帮助我们预测模型规模和数据量对训练损失的影响。
入选理由:扩展定律表明,随着模型规模和数据量的增加,训练损失会以可预测的方式下降。