Announcing llm-d 1.0: Open distributed inference for agents on Google Cloud TPUs and GPUs
Google Cloud 发布 llm-d 1.0,通过缓存感知路由和分层 KV 缓存优化多步骤代理推理,支持 TPU/GPU 混合部署。
入选理由:llm-d 1.0 支持 1000 个代理实例并发处理,通过分层 KV 缓存降低 40% 内存占用
公司
也叫:红帽
提供企业级开源解决方案的跨国公司
最近变化
2026-10-20 · llm-d 1.0 支持 1000 个代理实例并发处理,通过分层 KV 缓存降低 40% 内存占用
Red Hat 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「Red Hat」相关的 AI 资讯和分析。
Google Cloud 发布 llm-d 1.0,通过缓存感知路由和分层 KV 缓存优化多步骤代理推理,支持 TPU/GPU 混合部署。
入选理由:llm-d 1.0 支持 1000 个代理实例并发处理,通过分层 KV 缓存降低 40% 内存占用
开源是构建可信AI的基础,Red Hat与Linux基金会研究显示61%开发者审查AI生成代码,80%关注模型来源,透明度与治理成关键。
入选理由:61%开源贡献者会逐行审查AI生成代码
开源AI服务已从实验阶段进入成熟基础设施,Red Hat的vLLM和llm-d项目解决了大规模集群中的模型服务挑战。
入选理由:vLLM项目已纳入PyTorch基金会并支持多硬件架构
边缘AI模型管理需采用声明式GitOps方法,以应对分布式设备的版本控制与更新挑战。
入选理由:声明式管理比命令式管理更适合边缘设备的不可预测状态
Red Hat宣布Model Context Protocol (MCP) gateway正式发布,支持多团队隔离、资源联邦和渐进式工具发现,提升企业AI代理治理能力。
入选理由:MCP gateway提供两种隔离方案:独立实例和共享网关下的层级隔离
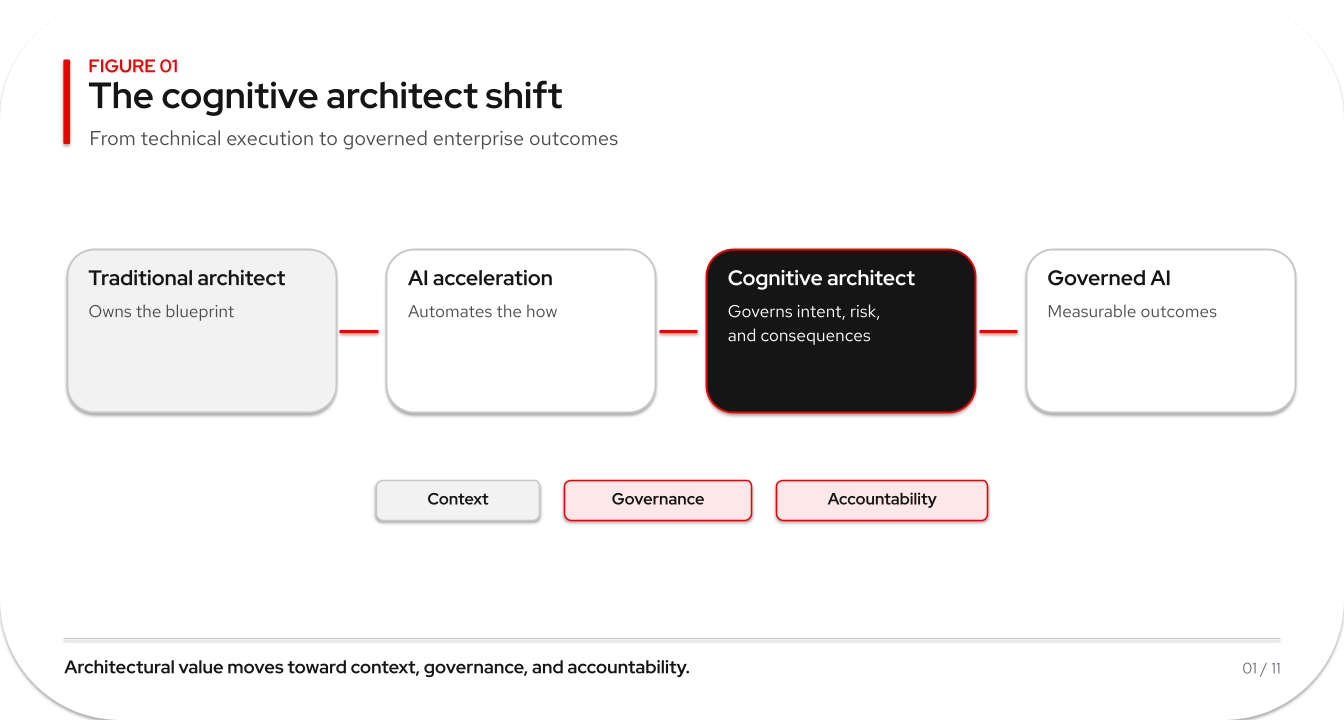
AI推动架构师角色转向认知治理,需平衡技术创新与风险管控。
入选理由:Cognitive Architect需整合AI加速与企业治理,避免技术债务
边缘AI部署需应对硬件异构性、资源竞争和延迟挑战,需采用ONNX等通用格式及特定硬件优化工具。
入选理由:边缘设备硬件异构性要求模型需适配多种格式(如TensorRT、OpenVINO)
Red Hat Lightspeed通过本地部署提供漏洞监控和修复建议,提升RHEL系统安全性与升级效率。
入选理由:Red Hat Lightspeed通过‘总风险’可视化帮助优先处理高风险漏洞
边缘AI部署需平衡云与边缘的MLOps组件,确保模型高效运行与持续优化。
入选理由:模型训练保留在云端,推理在边缘设备执行以降低延迟
Red Hat与Rafay联合发布的主权AI云参考架构,为电信运营商提供标准化、自助服务的GPU云解决方案,解决平台和商业化双重挑战。
入选理由:Red Hat平台解决多站点GPU环境标准化部署难题,降低70%运维复杂度
Red Hat通过赞助OpenClaw基金会推动生产级AI代理的开源基础设施,解决企业级安全与部署需求。
入选理由:Red Hat通过BYOA策略支持混合云环境中自主代理运行
印度正通过PyTorch与Hugging Face合作培养下一代AI系统构建者,聚焦分布式训练、推理优化等基础设施技术。
入选理由:PyTorch profiling工具链包含record_function和profile API,可分离等待/预热/采集阶段
AI推理依赖模型权重、推理服务器和GPU协同工作,KV缓存优化可降低延迟和成本。
入选理由:推理服务器(如vLLM)是实现生产级GPU利用率的关键组件
电信行业通过开源协作推动领域专用AI落地,OTel 2.0模型已获超500万次下载,Red Hat与AT&T等企业共建电信AI训练框架。
入选理由:OTel 2.0模型下载量达500万,较前代增长16.7倍
Red Hat通过模块化代理工作流实现Jira任务自动化,每周处理数十个票证并减少处理时间至分钟级,揭示AI代理规模化挑战与解决方案。
入选理由:模块化代理工作流使Jira票证处理时间从小时级缩短至分钟级
企业级AI系统需构建包含计算、存储、服务和集成的四层架构,自托管与托管模式各有权衡。
入选理由:企业AI系统依赖四层基础设施:计算、模型存储、服务层和系统集成
企业级AI部署需权衡托管API与自托管模型,Red Hat提供集成解决方案。
入选理由:托管API降低运维成本但可能增加长期费用
PyTorch 2026年北美会议展示编译器优化、跨仓库CI Relay和AI代理在发布工程中的应用,加速器后端兼容性验证时间缩短至分钟级。
入选理由:Cross-Repo CI Relay使Ascend NPU/RISC-V后端兼容性检测从天级缩短至分钟级
Red Hat提出的‘metal to agents’框架通过分层架构解决企业AI的基础设施成本和可扩展性问题,支持自研芯片与主流云厂商硬件。
入选理由:企业AI架构需分层设计,从硬件到自主代理共四层,避免供应商锁定
Red Hat与NVIDIA成立Open Secure AI联盟,推动开源AI安全工具开发,提升防御能力。
入选理由:Lightwell与IBM合作实现自动化漏洞修复流程
企业需通过前沿操作(frontier operations)整合AI能力,以应对技术变革并实现风险控制与增长。
入选理由:前沿操作要求五项持续技能:边界感知、接缝设计、失败模型维护、能力预测和杠杆校准。
Red Hat OpenShift AI通过实时训练进度跟踪和自动化中断机制,帮助用户节省高达70%的GPU资源浪费。
入选理由:实时指标收集可减少70%的GPU资源浪费
Red Hat Lightspeed内容模板通过统一的版本控制框架,有效解决RHEL扩展环境中的操作漂移问题,提升系统一致性和安全性。
入选理由:Lightspeed支持RHEL EUS/E4S/EEUS,实现版本锁定和可预测部署
CIO需通过混合云和开源策略确保系统可用性,Red Hat的Lightwell项目推动供应链安全。
入选理由:混合云策略使工作负载可跨云环境迁移,保障服务连续性
当前AI代理框架在生产环境中缺失7项关键平台能力,导致实际部署中出现严重问题。
入选理由:加密身份可防止错误计费,如4300美元错误账单案例
Red Hat MaaS通过订阅配额和访问策略实现AI治理,双门系统保障模型安全调用。
入选理由:MaaSSubscription控制用户令牌配额,绑定API密钥实现自动限流
Physical AI通过机器人、AI与边缘计算融合实现物理世界实时交互,Red Hat提供企业级基础设施支持。文章解析其技术架构与行业应用价值。
入选理由:Physical AI的三大支柱:感知、推理、行动,要求本地化硬件与实时处理能力
微软开源包遭恶意代码感染,触发凭证窃取攻击,影响73个包,攻击者利用AI工具传播。
入选理由:73个微软开源包被植入恶意代码,触发凭证窃取攻击。
The course introduces how to use vLLM to efficiently deploy open-source large models, covering techniques like quantization and paged attention.
入选理由:70亿参数大模型需约140GB内存,可能需要多GPU支持单次请求。
Efficient LLM serving relies on quantization and vLLM's smart memory management to overcome 140GB VRAM and KV Cache bottlenecks for low-latency concurrency.
入选理由:70B参数模型仅加载权重需约140GB显存,每个活跃请求还需独立KV Cache存储上下文。
与「Red Hat」经常一起出现的 AI 术语。
💡 想追踪「Red Hat」的长期趋势?去 实体雷达 · Red Hat 查看详细分析和跨材料问答。