Banger paper from Tencent on recursive self-improvement for terminal agents. (bookmark it) This is...
腾讯论文通过递归自我改进方法使终端代理性能提升超200%,Terminal-Bench测试集表现从20.68%跃升至50.58%。
入选理由:递归自我改进方法使Terminal-Bench 2.1测试集准确率提升至86.52%
模型
也叫:Qwen3.8
通义千问系列大语言模型,支持英文数字表达
最近变化
2026-10-17 · 递归自我改进方法使Terminal-Bench 2.1测试集准确率提升至86.52%
Qwen3.8-27B 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 10 篇与「Qwen3.8-27B」相关的 AI 资讯和分析。
腾讯论文通过递归自我改进方法使终端代理性能提升超200%,Terminal-Bench测试集表现从20.68%跃升至50.58%。
入选理由:递归自我改进方法使Terminal-Bench 2.1测试集准确率提升至86.52%
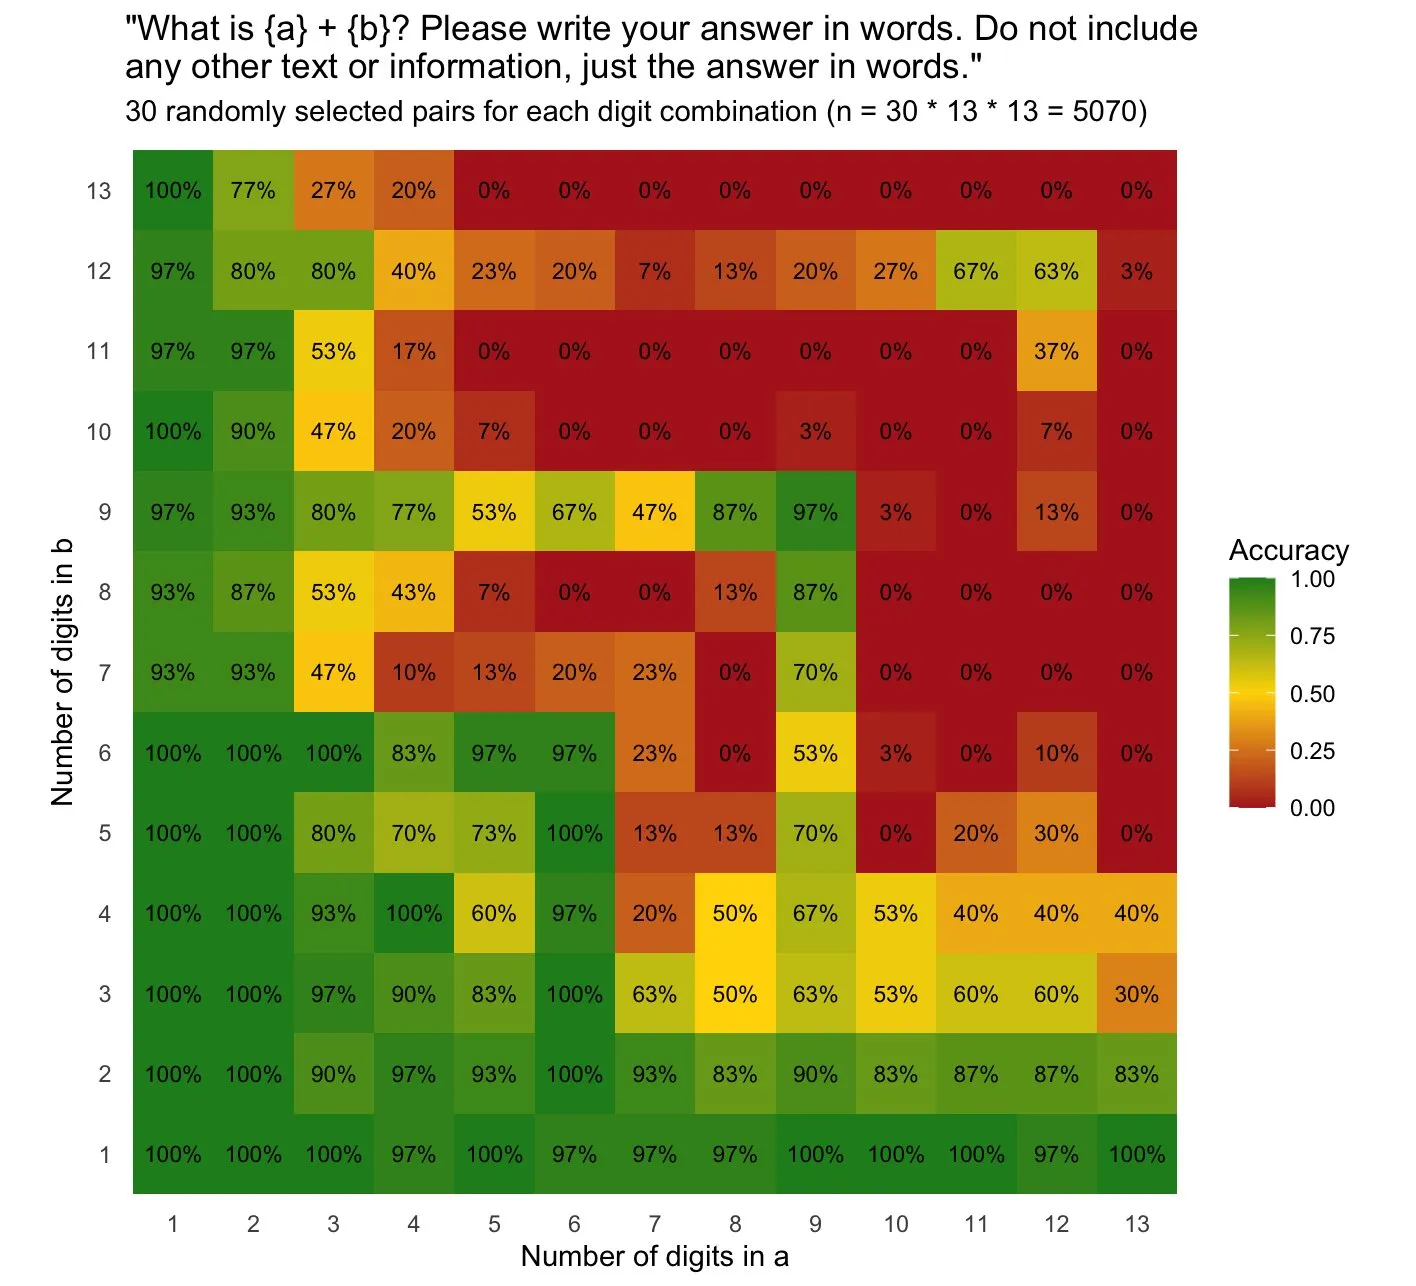
Qwen3.8-27B模型在无推理时大数相加准确率仅23.57%,启用推理后提升至97.04%。
入选理由:Qwen3.8-27B无推理时十至十三位数相加准确率仅6.44%
Qwen3.8-27B模型通过减少思考令牌将推理时间从90秒缩短至18秒,不同优化方法在效率与准确性间取得平衡。
入选理由:Thinking Cap模型通过减少令牌使用将推理时间从90秒缩短至18秒
Hugging Face发布多Harness RL训练指南,使用代理提升模型性能达12%。开源代码与训练数据可复现结果。
入选理由:使用代理记录token IDs和logprobs可使LFM2.5-2.6B模型性能提升12%
Qwen3.8-27B模型在性能上显著优于Meta的Glimmer 30B,但需通过量化与部署优化实现本地高效运行。
入选理由:Qwen3.8-27B参数量达2.4万亿,远超3.6版本且性能提升明显
通义千问3.8-27B模型已通过Nebius平台开放访问,适用于多步骤工作流和深度研究。
入选理由:27B参数量的密集模型适合复杂任务规划
文章介绍通过专用Harness实现端侧模型零成本推理方案,但因环境异常无法获取完整内容。
入选理由:Qwen3.8-27B模型通过Harness实现端侧推理优化
Qwen3.6-27B在agentic coding表现优异,Qwen3.8-27B即将发布并进一步优化。
入选理由:Qwen3.6-27B在agentic coding领域表现优于Muse Glimmer 30b
Qwen3.8-27B模型已发布,邀请开发者参与共建,但技术细节披露有限。
入选理由:Qwen3.8-27B模型已通过ollama平台开放使用
推文提及Qwen3.8-27B模型在Hugging Face发布,但未提供技术细节或使用价值说明。
入选理由:Qwen3.8-27B模型已上线Hugging Face
与「Qwen3.8-27B」经常一起出现的 AI 术语。
💡 想追踪「Qwen3.8-27B」的长期趋势?去 实体雷达 · Qwen3.8-27B 查看详细分析和跨材料问答。