AI Agent Security Risks: What Can Go Wrong When Agents Act on Their Own
Docker1774 字 (约 8 分钟)
85
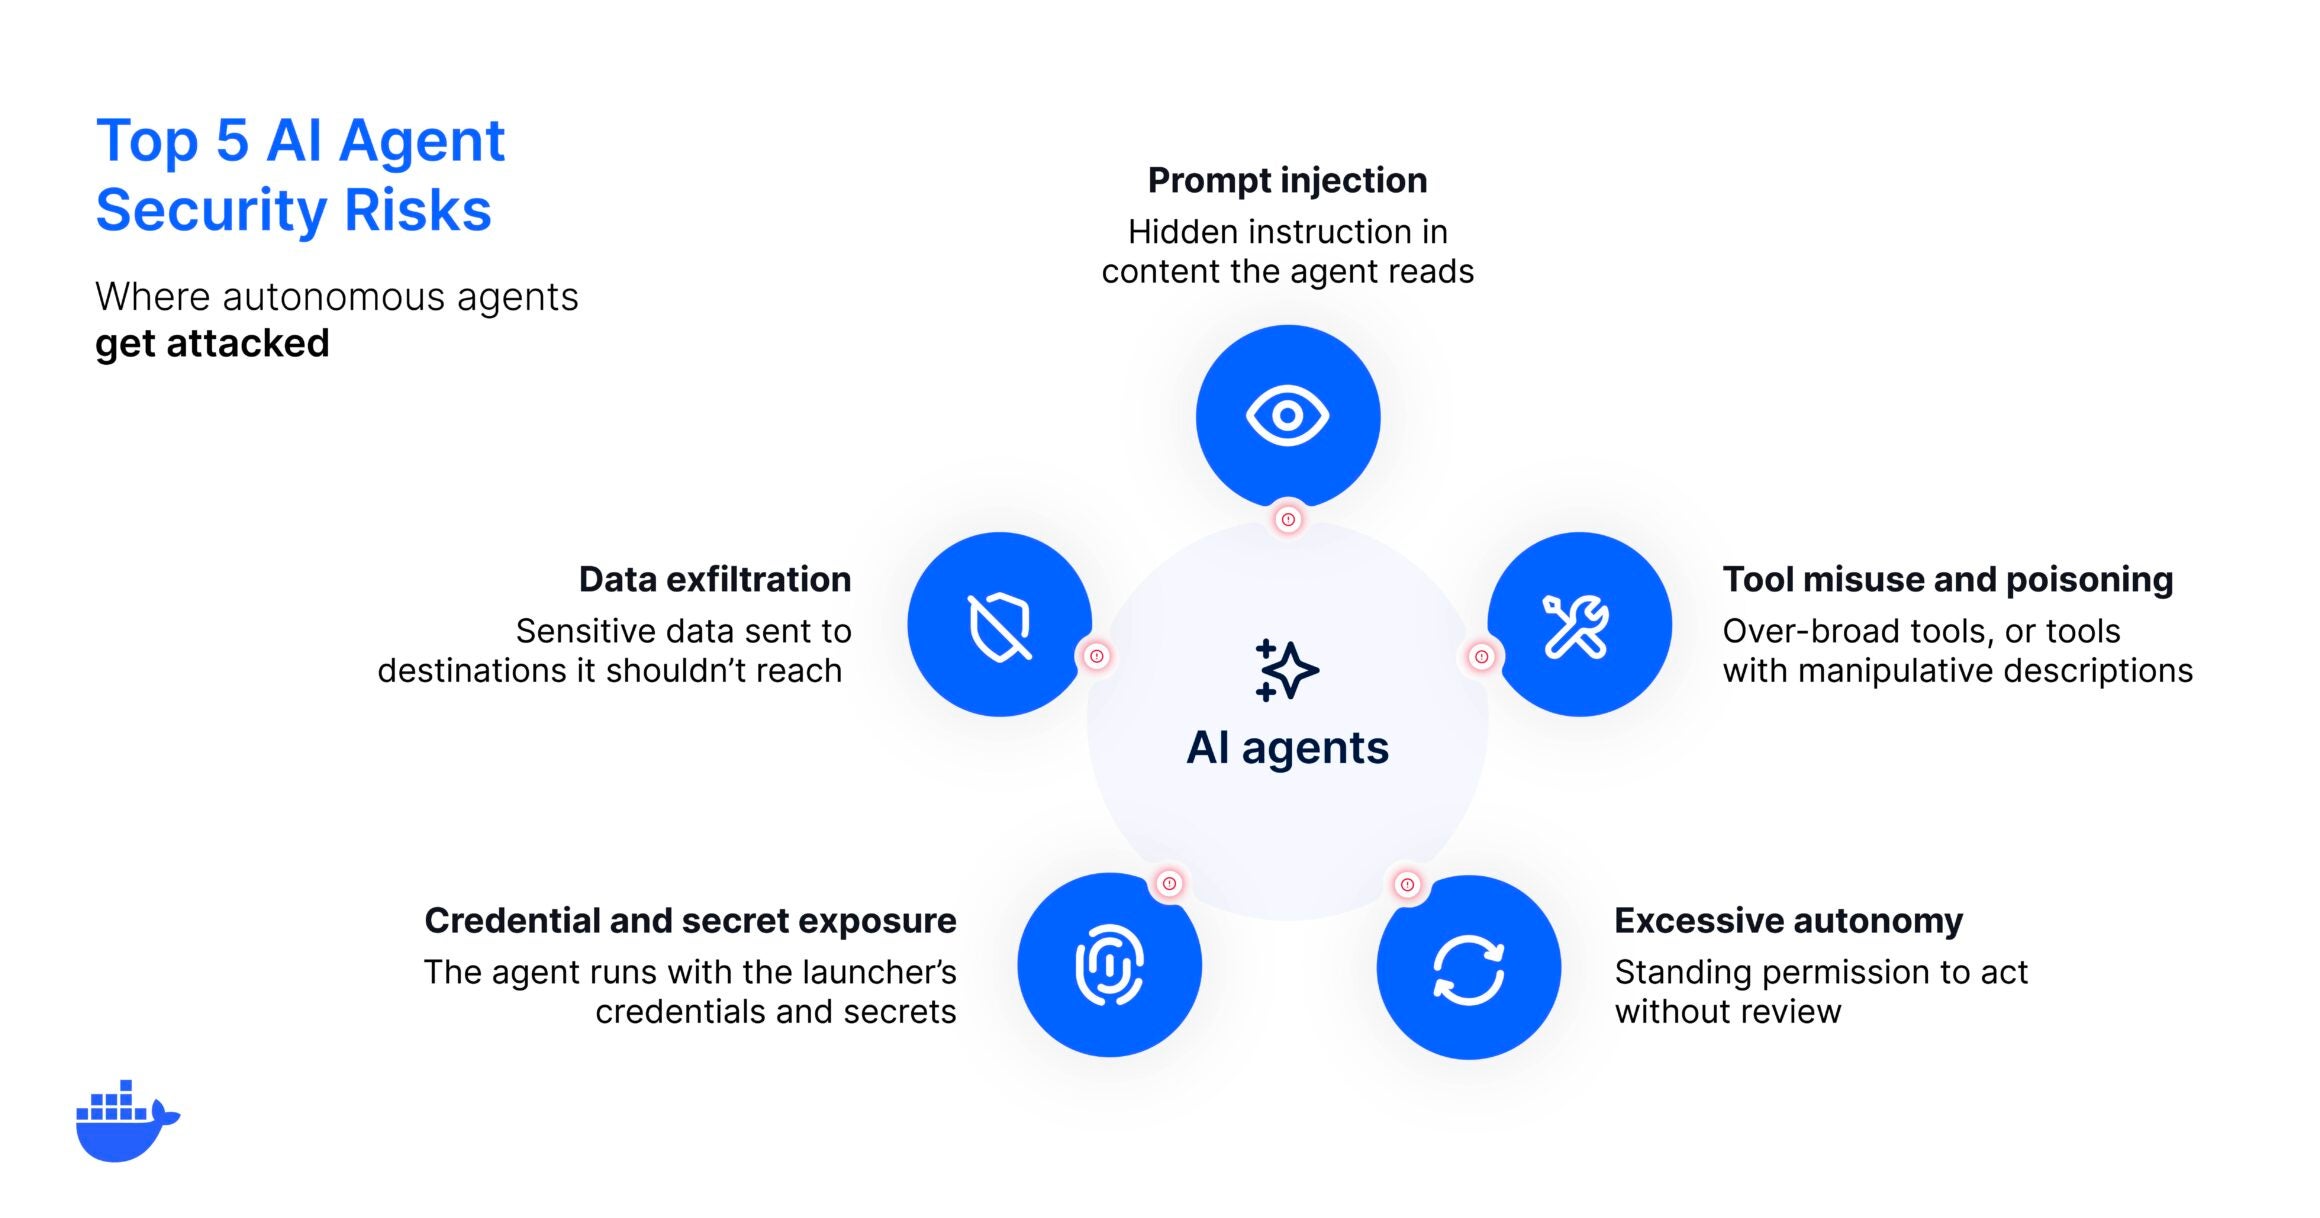
AI代理的自主性带来五类安全风险,需通过隔离和治理降低风险。
入选理由:AI代理的五大风险:提示注入、工具滥用、过度自主、凭证泄露、数据外泄
FeaturedArticle#AI#安全#Docker#风险#代理英文
概念
也叫:提示注入
通过注入恶意指令操控AI代理的行为
最近变化
2026-10-18 · AI代理可能因提示注入漏洞导致银行账户被非法控制
Prompt injection 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 9 篇与「Prompt injection」相关的 AI 资讯和分析。
AI代理的自主性带来五类安全风险,需通过隔离和治理降低风险。
入选理由:AI代理的五大风险:提示注入、工具滥用、过度自主、凭证泄露、数据外泄
Claude Code Auto Mode存在重大安全漏洞,80%成功率的攻击可绕过其防护机制,建议使用沙箱运行代理。
入选理由:Johann Rehberger发现攻击Auto Mode的成功率为80%,通过诱导下载zip文件执行恶意代码。
OpenAI开发了GPT-Red,通过AI驱动的红队测试提升模型安全性,有效防御新型攻击。
入选理由:GPT-Red通过自我对抗训练发现新型攻击,提升模型防御能力
AI模型在面对大量提示注入攻击时表现出色,但生产环境仍需谨慎。
入选理由:Opus 4.6模型成功抵御了6000次攻击尝试。
AI安全与传统网络安全有本质不同,Gray Swan团队开发的自动化红队系统Shade能超越人类攻击前沿模型,AI安全危机可能以‘灰天鹅’事件形式爆发。
入选理由:AI安全与传统网络安全存在本质差异,需新的应对策略。
模型无法有效区分特权文本与用户输入,导致提示注入攻击风险显著增加。
入选理由:模型更关注文本风格而非内容,导致角色混淆。
The key to building a safe AI support agent is escalation-first design: before generating any reply, a pure-function decider determines whether to escalate to human support, only allowing grounded answers when approved, and verifying them via dual AI judges. This pattern significantly reduces risk of wrong responses, especially in high-sensitivity domains like finance.
入选理由:采用纯函数决策器(无LLM调用)在生成回复前判断是否需升级至人工支持,避免模型被提示注入攻击误导。
OpenAI's new 'Lockdown Mode' aims to prevent the final stage of data exfiltration attacks by limiting outbound network requests, serving as a crucial security measure against the 'Lethal Trifecta' of LLM risks.
入选理由:锁定模式通过限制出站网络请求来阻止数据泄露,这是应对提示注入攻击的关键安全层。
当前AI代理在安全性和提示注入方面存在重大风险,需谨慎对待其控制敏感系统的能力。
入选理由:AI代理可能因提示注入漏洞导致银行账户被非法控制
与「Prompt injection」经常一起出现的 AI 术语。
💡 想追踪「Prompt injection」的长期趋势?去 实体雷达 · Prompt injection 查看详细分析和跨材料问答。
