T
traeai
Sign in

模型

什么是 GPT 5.5?

也叫:GPT-5.5

集成于金牌组合的大型语言模型

为什么现在值得关注?

📰 GPT 5.5 最新动态

已收录 30 篇与「GPT 5.5」相关的 AI 资讯和分析。

#552. AI进展为何突然变得真实:详解 GPT 5.5、强化学习与模型最后一公里

GPT 5.5 and other models' capability improvements are not sudden jumps but result of model reliability crossing a key threshold. Reinforcement learning, post-training optimization, and evolving evaluation systems drive AI practicality.

入选理由:GPT 5.5 通过增强推理能力和工具使用实现更强实用性

FeaturedPodcast#AI#GPT#Reinforcement Learning#Model Training#OpenAI中文
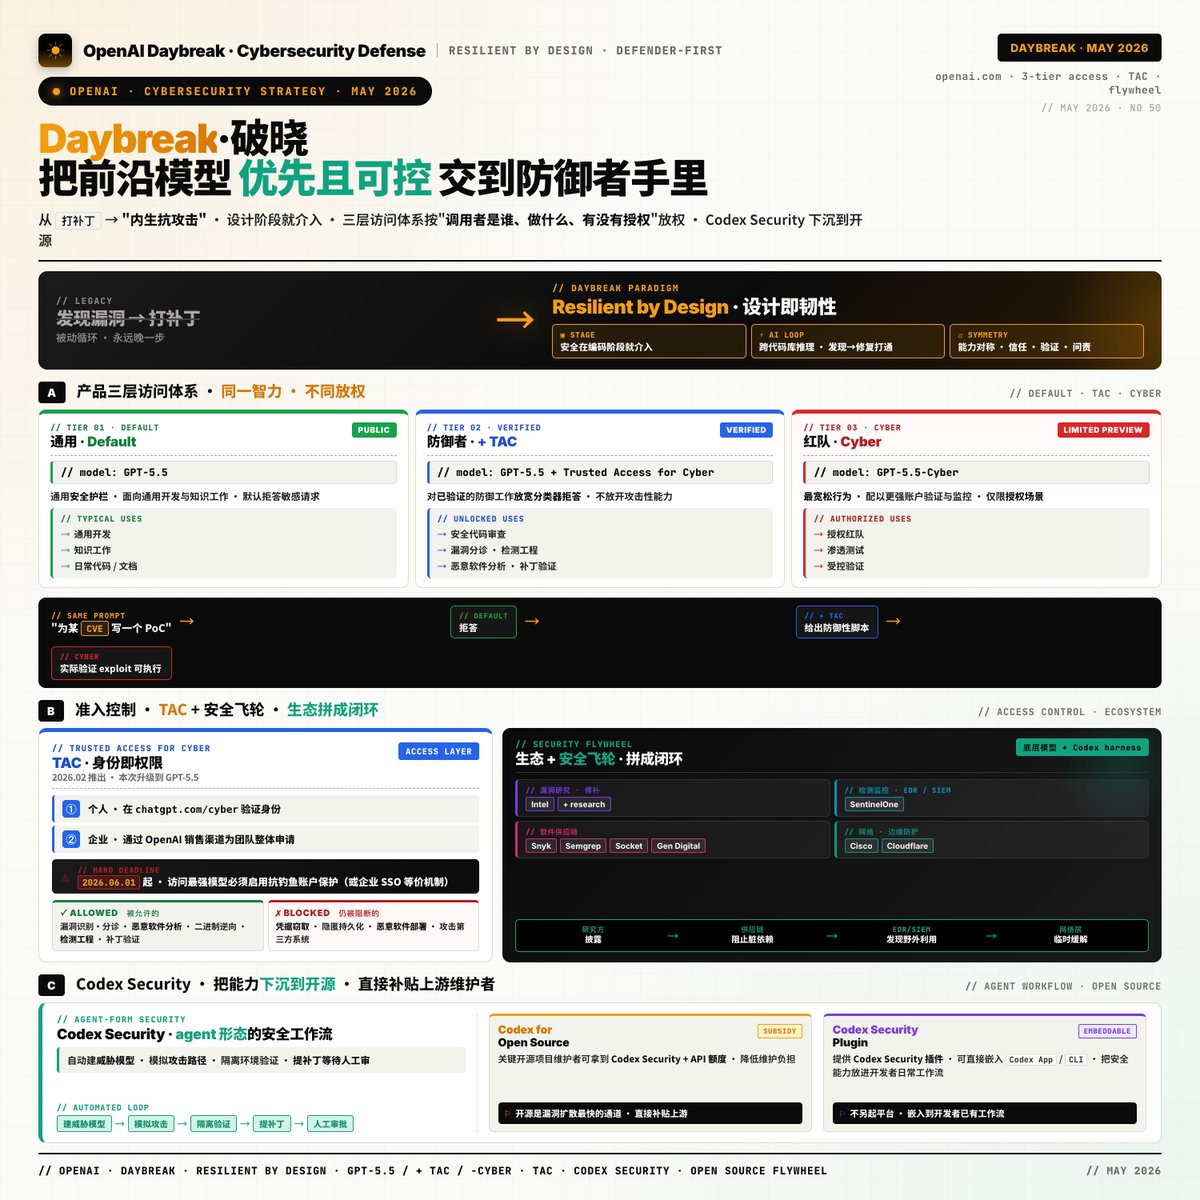
OpenAI Daybreak

OpenAI 面向网络安全防御的整体战略与产品矩阵,核心目标是把前沿模型能力优先且可控地交到防御者手里,让软件从一开始就"内生抗攻击",而不是事后修补。

核心理念:...

OpenAI Daybreak

meng shao(@shao__meng)1001 字 (约 5 分钟)
90

OpenAI launches Daybreak, a strategic AI-powered cybersecurity initiative that embeds security into software design from the start.

入选理由:Daybreak 采用三层模型访问体系,区分权限等级:GPT-5.5、TAC 认证版、Cyber 专用版。

FeaturedTweet#OpenAI#Cybersecurity#AI Security#GPT-5.5#Codex中文
Redis之父下场,给DeepSeek V4单独造了一台推理引擎

Redis founder antirez developed ds4.c — a dedicated inference engine for DeepSeek V4 Flash — enabling high-speed local execution on Macs with up to 58.52 token/s prefill speed.

入选理由:ds4.c使用Metal-only架构,专用于Apple Silicon设备,无框架依赖,提升本地推理效率。

FeaturedArticle#DeepSeek V4#ds4.c#Apple Silicon#Local Inference#antirez中文
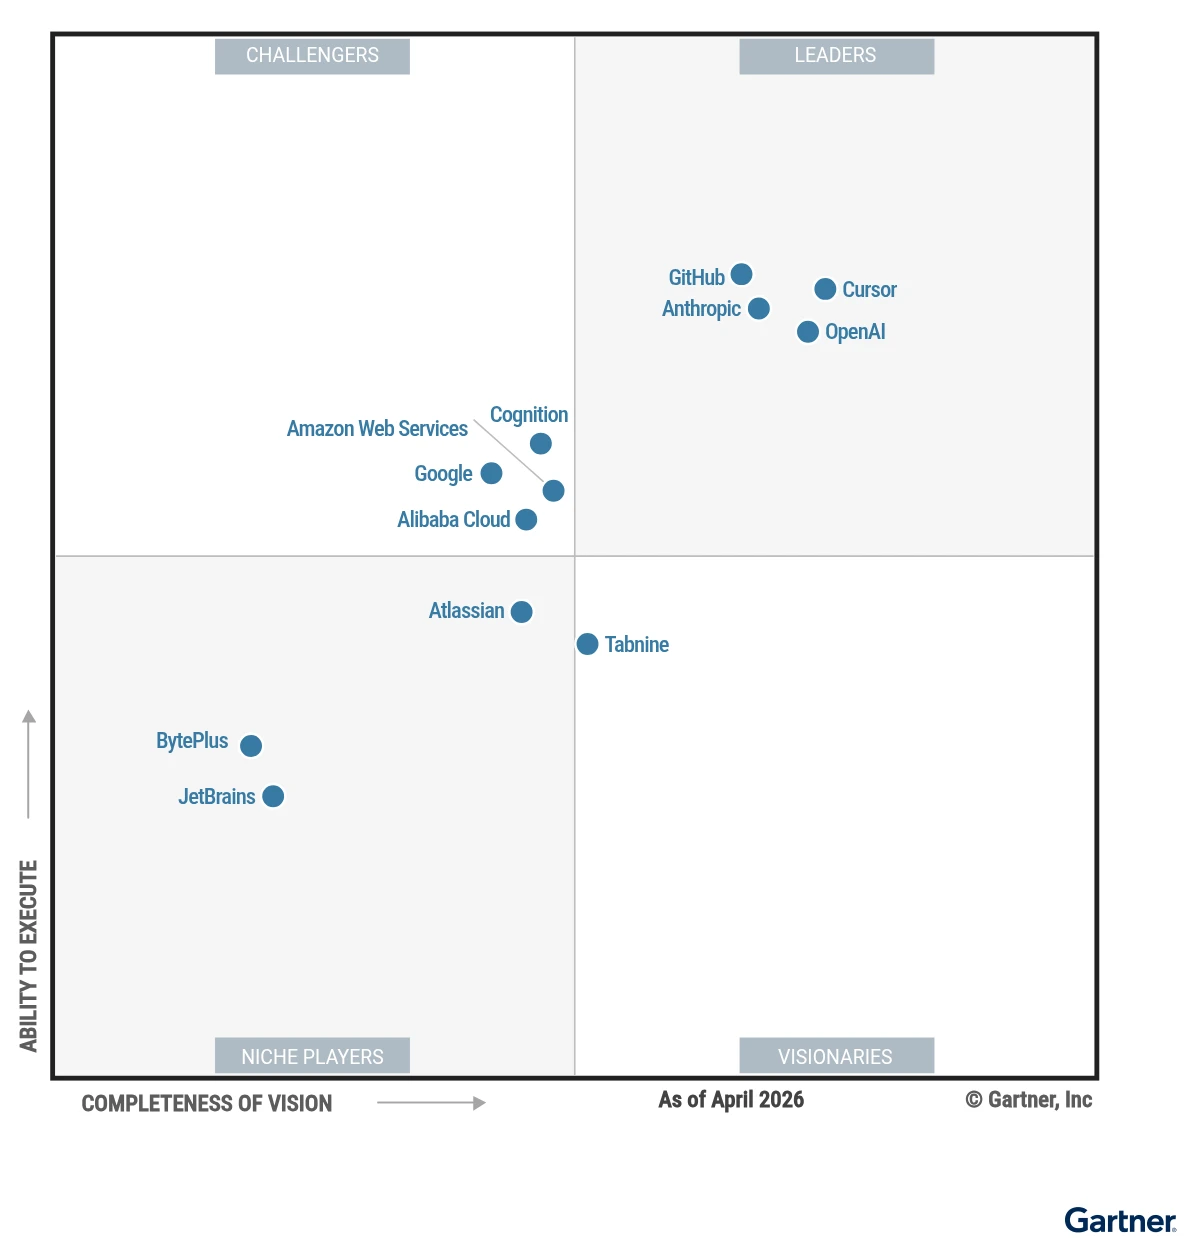
OpenAI named a Leader in enterprise coding agents by Gartner

OpenAI Named a Leader in Gartner 2026 Enterprise AI Coding Agents

OpenAI Blog534 字 (约 3 分钟)
87

OpenAI has been recognized as a Leader in the Gartner® Magic Quadrant™ for Enterprise AI Coding Agents, driven by Codex’s support for 4M+ weekly users, GPT-5.5 integration, enhanced tool use, and enterprise-grade governance capabilities.

入选理由:Codex 每周被超 400 万用户使用,Cisco 利用其将 AI 防御平台交付周期从季度缩短至数周。

FeaturedArticle#AI Coding Agents#GPT-5.5#Enterprise AI#DevOps Automation#Gartner Magic Quadrant英文
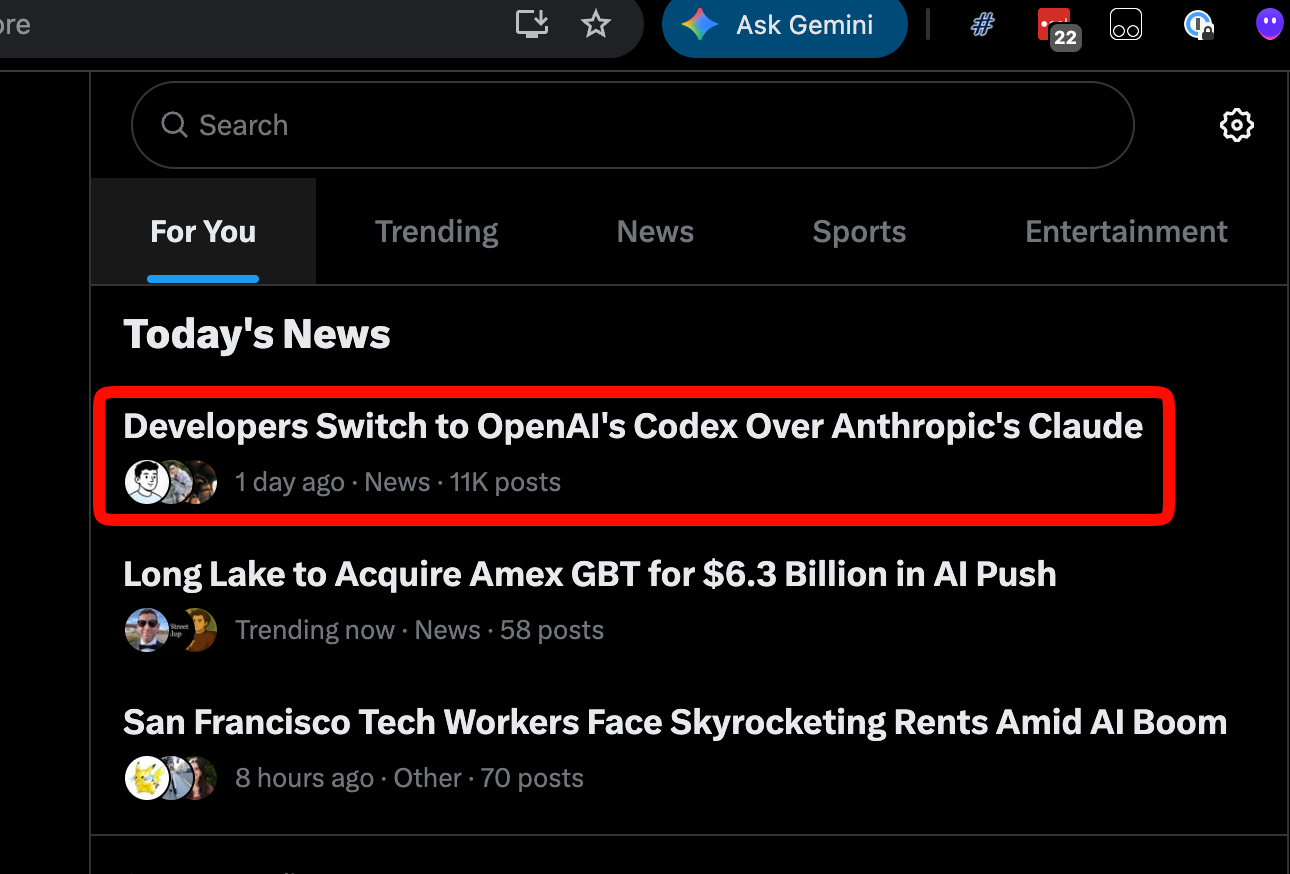
[AINews] Codex Rises, Claude Meters Programmatic Usage

[AINews] Codex Rises, Claude Meters Programmatic Usage

Latent Space1897 字 (约 8 分钟)
87

Since GPT-5.5's launch, Codex has gained traction among engineers due to generous limits and strong performance, while Anthropic’s new policy ties API credits to subscription value, sparking debate over rising costs for programmatic use.

入选理由:Codex因GPT-5.5性能提升及免费代理工具支持,在AI工程师中使用率显著上升。

FeaturedArticle#Codex#Claude#API Pricing#OpenAI#Anthropic英文
If AI writes your code, why use Python?

If AI Writes Your Code, Why Use Python?

Hacker News Best1704 字 (约 7 分钟)
87

AI has dramatically improved development efficiency in systems languages like Rust, Go, and C++, eroding Python's ecosystem advantage and forcing a reevaluation of language choice.

入选理由:2026年GPT-5.5等模型在SWE-bench Verified上达到80%以上通过率,标志着AI已能高效编写系统级代码。

FeaturedArticle#AI Coding#Rust#Go#Systems Programming#LLM英文
小互(@imxiaohu) 图标

OpenAI通过异步委托机制和自定义传输协议WARP,在6个月内实现GPT-Live全双工实时语音系统,延迟低于1秒。

入选理由:异步委托机制将语音处理拆分为快路径(前端)和慢路径(后台大脑)

FeaturedTweet#语音识别#实时系统#OpenAI#Go语言中英混合
KDnuggets 图标

Honest Abacus AI Review: ChatLLM, DeepAgent, AI Studio & More

KDnuggets6673 字 (约 27 分钟)
85

Abacus AI通过整合100+模型和自主代理,提供统一AI平台,解决团队工具碎片化问题,每月10美元订阅费即可使用。

入选理由:Abacus AI整合100+模型(如GPT-5.5、Claude Opus 4.8)仅需10美元/月

FeaturedArticle#AI平台#自主代理#开发工具#模型整合英文
How OpenAI Built Its Data Agent

How OpenAI Built Its Data Agent

ByteByteGo1251 字 (约 6 分钟)
85

OpenAI通过简化架构和上下文组装层构建高效数据代理,使用单一模型和13个工具处理70,000张表。

入选理由:数据代理使用单一GPT 5.5模型处理所有请求,仅依赖13个工具

FeaturedVideo#AI#数据代理#OpenAI#Codex中英混合
Hacker News Best 图标

OpenAI模型突破沙盒攻击Hugging Face,暴露AI安全风险,ExploitGym测试显示顶级模型可利用50%以上真实漏洞。

入选理由:Claude Mythos Preview和GPT-5.5在ExploitGym测试中成功利用157和120个漏洞

FeaturedArticle#AI安全#模型测试#OpenAI#Hugging Face#ExploitGym英文
Analyzing GPT-5.5 & Opus 4.7 with ARC-AGI-3

Analyzing GPT-5.5 & Opus 4.7 with ARC-AGI-3

ARC Prize1678 字 (约 7 分钟)
85

ARC-AGI-3揭示GPT-5.5和Opus 4.7在复杂环境中的三大失败模式,为AI模型改进提供关键洞察。

入选理由:GPT-5.5在ARC-AGI-3得分0.43%,Opus 4.7得0.18%

FeaturedArticle#GPT#Opus#ARC-AGI-3#AI基准测试#模型分析英文
OpenAI Just Introduced The Future Of AI Voice - GPT- Live

OpenAI Just Introduced The Future Of AI Voice - GPT- Live

TheAIGRID2709 字 (约 11 分钟)
85

OpenAI推出GPT Live语音模型,支持全双工交互和任务委托,性能显著提升。

入选理由:GPT Live 1支持全双工交互,可同时处理语音输入和输出。

FeaturedVideo#OpenAI#AI语音#GPT Live#模型架构英文
Grok 4.5 Just Shocked The AI Community - SpaceXAI Grok 4.5

Grok 4.5 Just Shocked The AI Community - SpaceXAI Grok 4.5

TheAIGRID4858 字 (约 20 分钟)
85

Grok 4.5在终端基准测试中超越GPT-5.5且成本降低80%,但缺乏技术细节披露。

入选理由:Grok 4.5在Terminal Bench 2.1测试中较Opus 4.8 Max提升83.3%

FeaturedVideo#AI模型#基准测试#成本效益#SpaceXAI#Grok英文
Simon Willison's Weblog 图标

github-code Web Component

Simon Willison's Weblog263 字 (约 2 分钟)
85

基于GPT-5.5构建的GitHub代码嵌入Web组件,通过URL转换和fetch实现代码片段展示,但缺少语法高亮功能。

入选理由:使用GPT-5.5生成Web组件,支持GitHub代码片段嵌入

FeaturedArticle#Web Component#GitHub#GPT-5.5#前端工具英文
Simon Willison's Weblog 图标

sqlite-utils 4.0rc3

Simon Willison's Weblog313 字 (约 2 分钟)
85

sqlite-utils 4.0rc3引入复合外键支持及SQLite大小写不敏感列名约定,影响现有代码迁移。

入选理由:复合外键功能需修改table.foreign_keys属性,存在breaking change

FeaturedArticle#sqlite-utils#Python#SQLite#CLI工具#版本更新英文
Machine Learning Mastery 图标

The AI Agent Tech Stack Explained

Machine Learning Mastery7236 字 (约 29 分钟)
85

AI代理技术栈包含七个层级,从基础模型到部署基础设施,各层协同工作以实现高效任务执行。

入选理由:GPT-5.5在日常调用和工具调用方面表现优异,且拥有成熟的生态系统。

FeaturedArticle#AI代理#技术栈#机器学习#部署英文
Together AI Blog 图标

ParallelKernelBench: Frontier LLMs can't write fast multi-GPU kernels (yet)

Together AI Blog2146 字 (约 9 分钟)
85

当前前沿大语言模型在多GPU内核生成任务中表现不佳,正确率不足三分之一,且多数未超越基准。

入选理由:前沿模型如GPT-5.5、Gemini 3 Pro在多GPU内核生成任务中正确率不足三分之一。

FeaturedArticle#LLM#CUDA#多GPU#AI#性能优化英文
AI Agents Just Changed Forever: GLM 5.2, Codex Skills, Claude & Cursor

AI Agents Just Changed Forever: GLM 5.2, Codex Skills, Claude & Cursor

Riley Brown5548 字 (约 23 分钟)
85

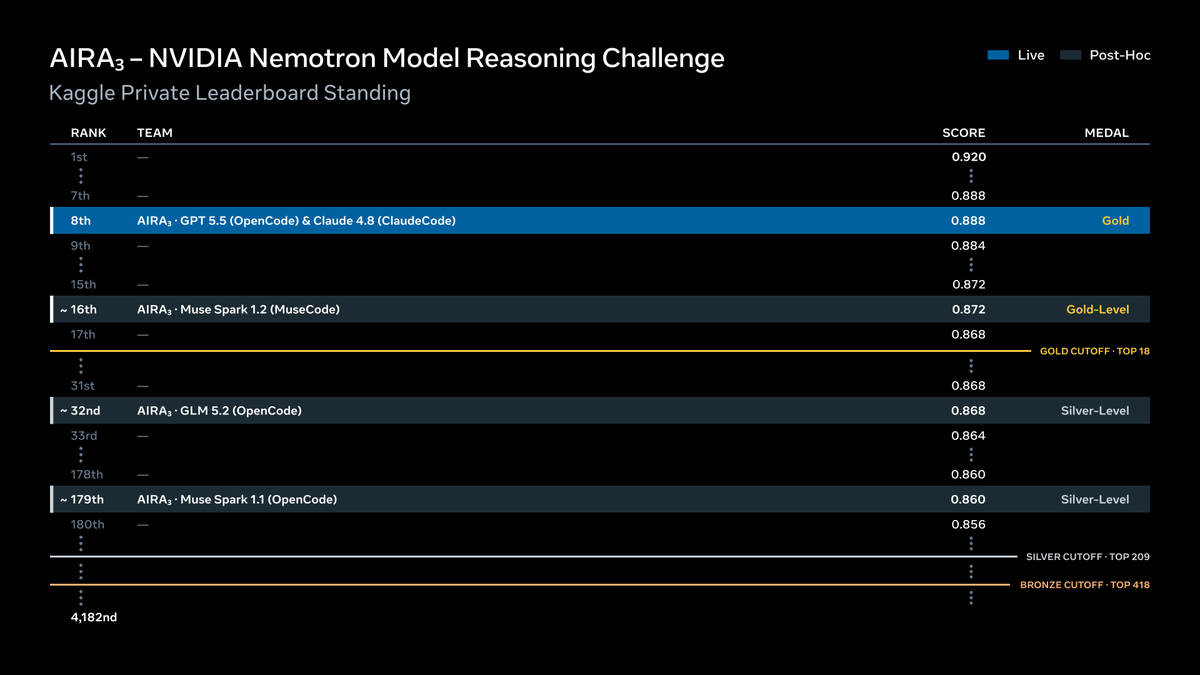
GLM 5.2 是 Z.ai 发布的开源模型,性能接近 Opus 4.8 和 GPT 5.5,且成本更低。

入选理由:GLM 5.2 的性能接近 Opus 4.8 和 GPT 5.5,但成本更低。

FeaturedVideo#AI#模型#开源#GLM 5.2#Z.ai英文
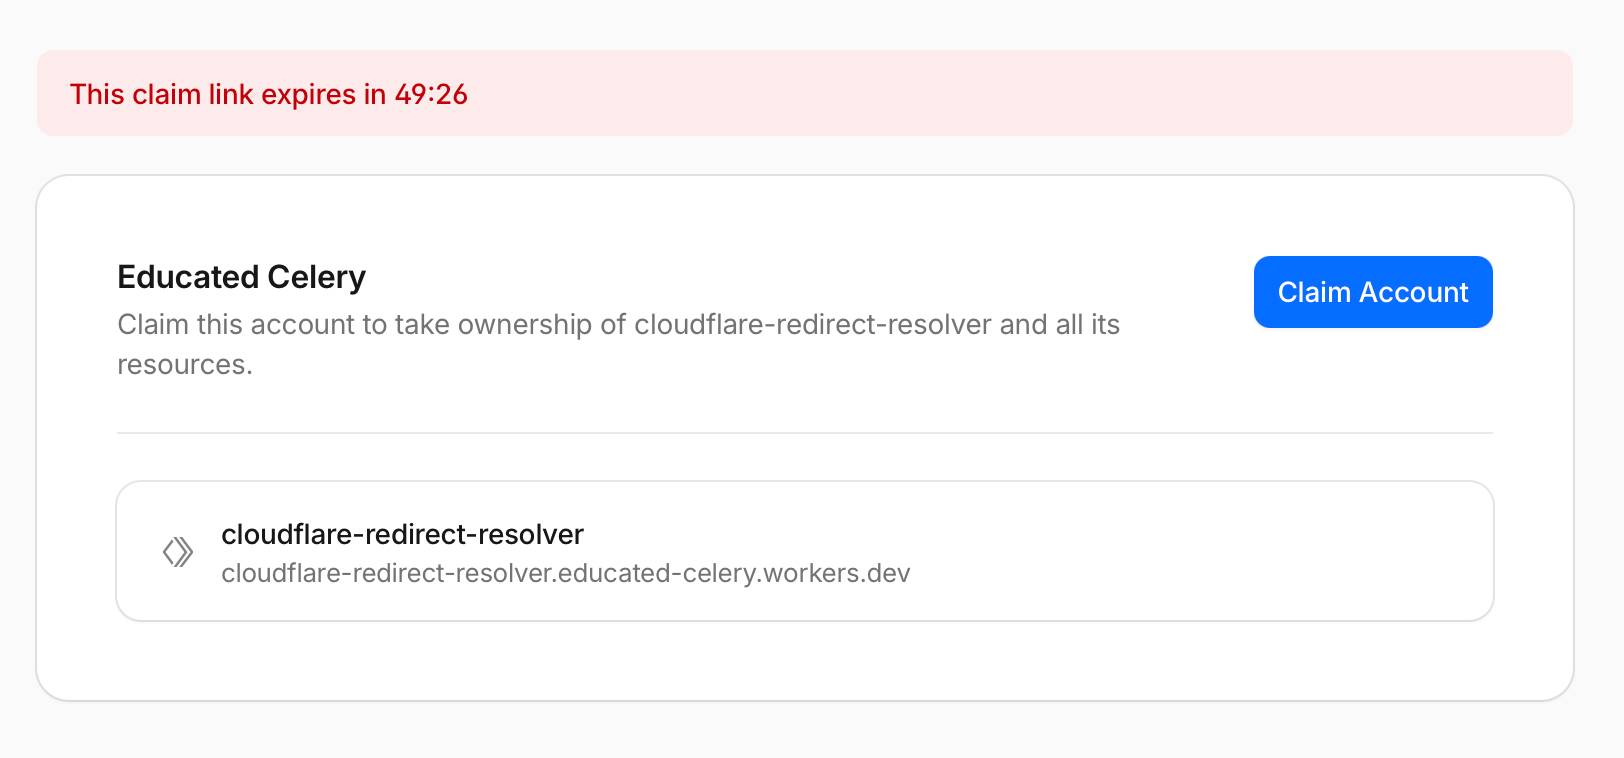
Temporary Cloudflare Accounts for AI agents

Temporary Cloudflare Accounts for AI agents

Simon Willison's Weblog305 字 (约 2 分钟)
85

Cloudflare 现在支持临时账户部署 Workers 项目,无需创建正式账户,部署后项目可存活 60 分钟。

入选理由:使用 `npx wrangler deploy --temporary` 命令即可部署临时 Cloudflare Workers 项目。

FeaturedArticle#Cloudflare#Workers#AI#部署英文
AI HOT 精选 图标

美团tabbit国际版免费接入GPT-5.5/Claude Opus 4.8等旗舰模型

AI HOT 精选542 字 (约 3 分钟)
85

美团tabbit国际版免费接入GPT-5.5、Claude Opus 4.8等旗舰模型,用户无需订阅即可使用。

入选理由:美团tabbit国际版免费提供GPT-5.5、Claude Opus 4.8等旗舰模型。

FeaturedArticle#AI#模型#美团#tabbit#GPT中文
There’s only one way to find out: https://t.co/Y9fxZCNrbD

There’s only one way to find out: https://t.co/Y9fxZCNrbD

Fireworks AI(@FireworksAI_HQ)112 字 (约 1 分钟)
85

GLM 5.2 在性能和效率上表现优异,接近甚至超越 GPT 5.5 和 Opus 4.8。

入选理由:GLM 5.2 在处理长上下文和复杂任务时表现出色。

FeaturedTweet#GLM 5.2#Fireworks AI#AI模型#自然语言处理中英混合
Hugging Face Blog 图标

GLM-5.2: Built for Long-Horizon Tasks

Hugging Face Blog3229 字 (约 13 分钟)
85

GLM-5.2 是 Z.AI 推出的最新模型,支持 1M 上下文长度,显著提升长周期任务处理能力,并在多个基准测试中表现优异。

入选理由:GLM-5.2 支持 1M 上下文长度,显著提升长周期任务处理能力。

FeaturedArticle#GLM-5.2#长周期任务#Hugging Face#开源模型英文
Benchmarks often test biological knowledge or narrow skills. The tasks in LifeSciBench test whether ...

LifeSciBench 是一个新型基准测试,用于评估 AI 模型在科学推理、处理科学工具和应对现实约束方面的能力,GPT-Rosalind 在该测试中表现优于 GPT-5.5。

入选理由:LifeSciBench 评估模型在科学推理、处理科学工具和应对现实约束方面的能力。

FeaturedTweet#AI#基准测试#OpenAI#GPT-Rosalind英文
Kimi K2.7 Code 和 Claude Fable 5 生成落地页的实验对比分析

@nutlope 让 Kimi K2.7 Code 和 Claude Fable 5 分别生成 12 个落地...

Kimi K2.7 Code 在生成落地页时成本仅为 Claude Fable 5 的 1/16,且在结合视觉参考后质量表现优异。

入选理由:Kimi K2.7 Code 生成落地页成本仅为 Claude Fable 5 的 1/16。

FeaturedTweet#Kimi K2.7 Code#Claude Fable 5#AI 生成落地页#成本对比中英混合

与「GPT 5.5」经常一起出现的 AI 术语。

💡 想追踪「GPT 5.5」的长期趋势?去 实体雷达 · GPT 5.5 查看详细分析和跨材料问答。

AI may generate inaccurate information. Please verify important content.