CoreWeave Powers Agentic AI, HPC, and Data Analytics Workloads with NVIDIA HGX Rubin NVL8
NVIDIA HGX Rubin NVL8通过HBM4和第六代NVLink大幅提升性能,CoreWeave云平台将支持该架构,降低运营成本并提升AI、HPC和数据分析效率。
入选理由:NVIDIA HGX Rubin NVL8内存带宽达130 TB/s,支持实时处理大规模数据集
模型
也叫:DeepSeek R1
DeepSeek发布的大型语言模型,涉及蒸馏技术讨论。
最近变化
2026-10-21 · NVIDIA HGX Rubin NVL8内存带宽达130 TB/s,支持实时处理大规模数据集
DeepSeek-R1 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 8 篇与「DeepSeek-R1」相关的 AI 资讯和分析。
NVIDIA HGX Rubin NVL8通过HBM4和第六代NVLink大幅提升性能,CoreWeave云平台将支持该架构,降低运营成本并提升AI、HPC和数据分析效率。
入选理由:NVIDIA HGX Rubin NVL8内存带宽达130 TB/s,支持实时处理大规模数据集
蒸馏技术在AI领域引发激烈竞争,但字节跳动等公司因技术壁垒和商业逻辑选择不蒸馏,其代价与风险成为行业讨论焦点。
入选理由:蒸馏技术在2026年成为焦点,但存在法律和商业风险
论文通过国际象棋案例揭示预训练与强化学习阶段的扩展定律,证明计算资源分配对模型性能有显著影响。
入选理由:预训练阶段建议分配20倍于参数的token量
CoreWeave在MLPerf 0.7 Endpoints基准测试中,使用68块NVIDIA Blackwell GPU实现每秒44万输出token,验证了DeepSeek-R1模型的高效推理能力。
入选理由:CoreWeave在MLPerf 0.7测试中使用68块NVIDIA Blackwell GPU实现了441,740 token/s的吞吐量
AI工厂需在生产前验证基础设施可靠性,NVIDIA与CoreWeave合作提升AI计算效率。
入选理由:AI工厂需验证全栈系统连续运行能力,避免GPU资源浪费和项目延误
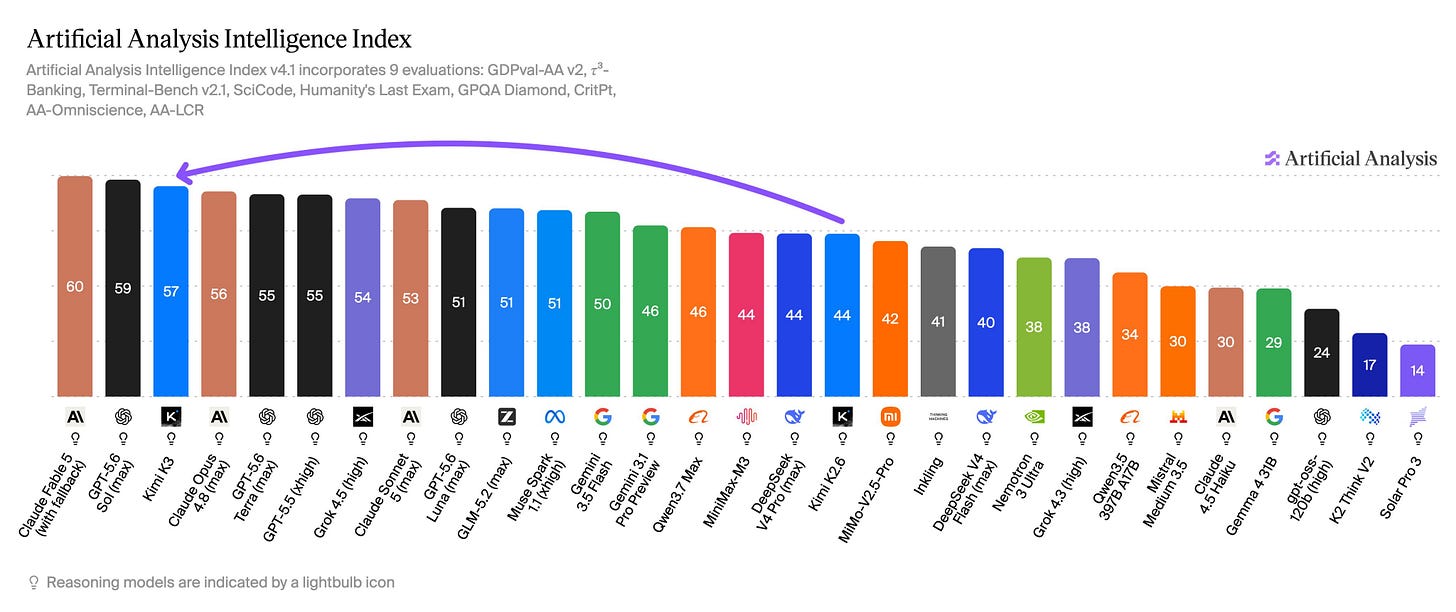
Kimi K3开放权重可能缩小中美AI模型性能差距至3-5个月,展现中国模型的前沿竞争力。
入选理由:Kimi K3是2.8T参数MoE模型,性能接近美国前沿模型Claude Fable和GPT-5.6
NVIDIA Vera Rubin NVL72在能耗效率上比Blackwell提升10倍,适合大规模AI推理。
入选理由:Vera Rubin NVL72在相同功耗下生成的token数量是Blackwell的10倍
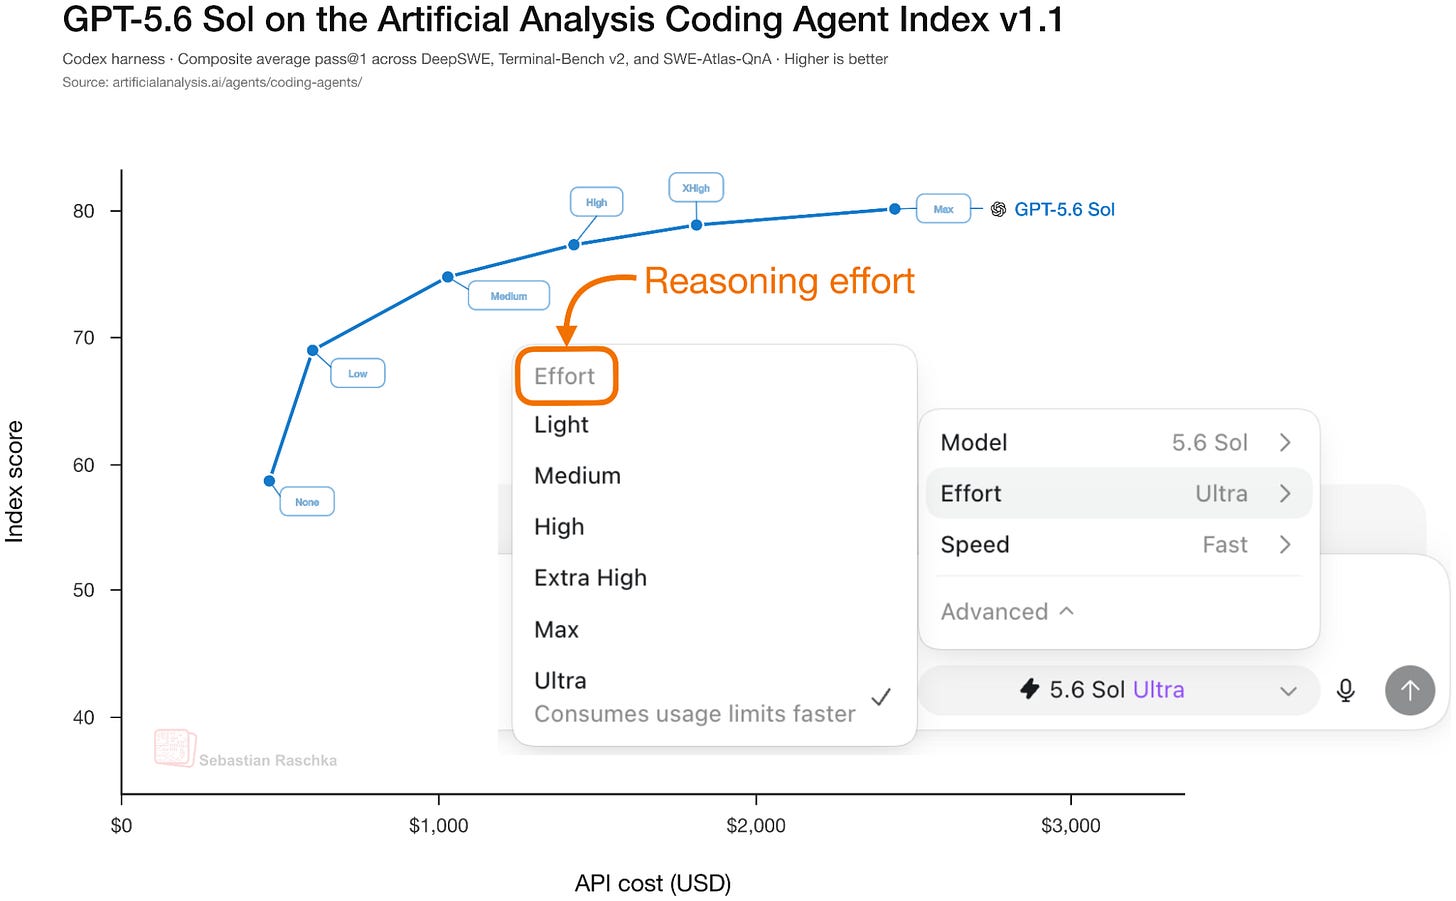
GPT-5.6模型通过多层级推理设置实现灵活推理控制,结合RLVR训练方法提升模型性能。
入选理由:GPT-5.6提供三种模型规模和五到六种推理设置
与「DeepSeek-R1」经常一起出现的 AI 术语。
💡 想追踪「DeepSeek-R1」的长期趋势?去 实体雷达 · DeepSeek-R1 查看详细分析和跨材料问答。