Introducing CoreWeave Physical AI Launchables: Run Workloads With One Command
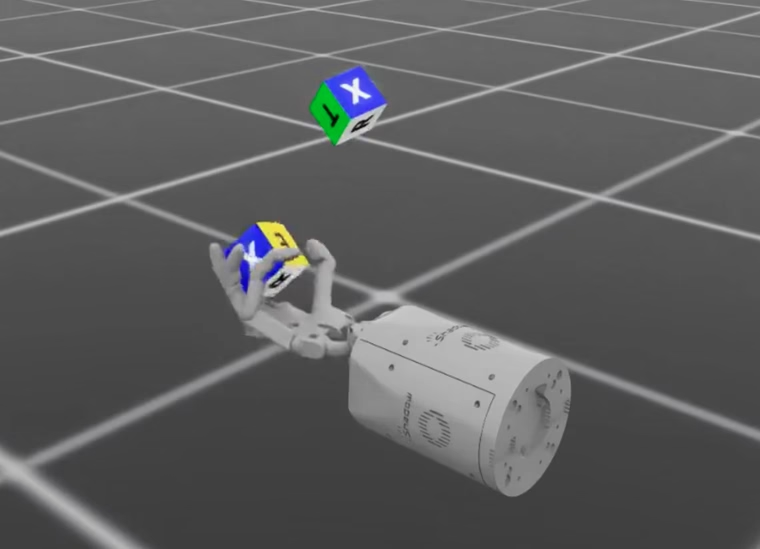
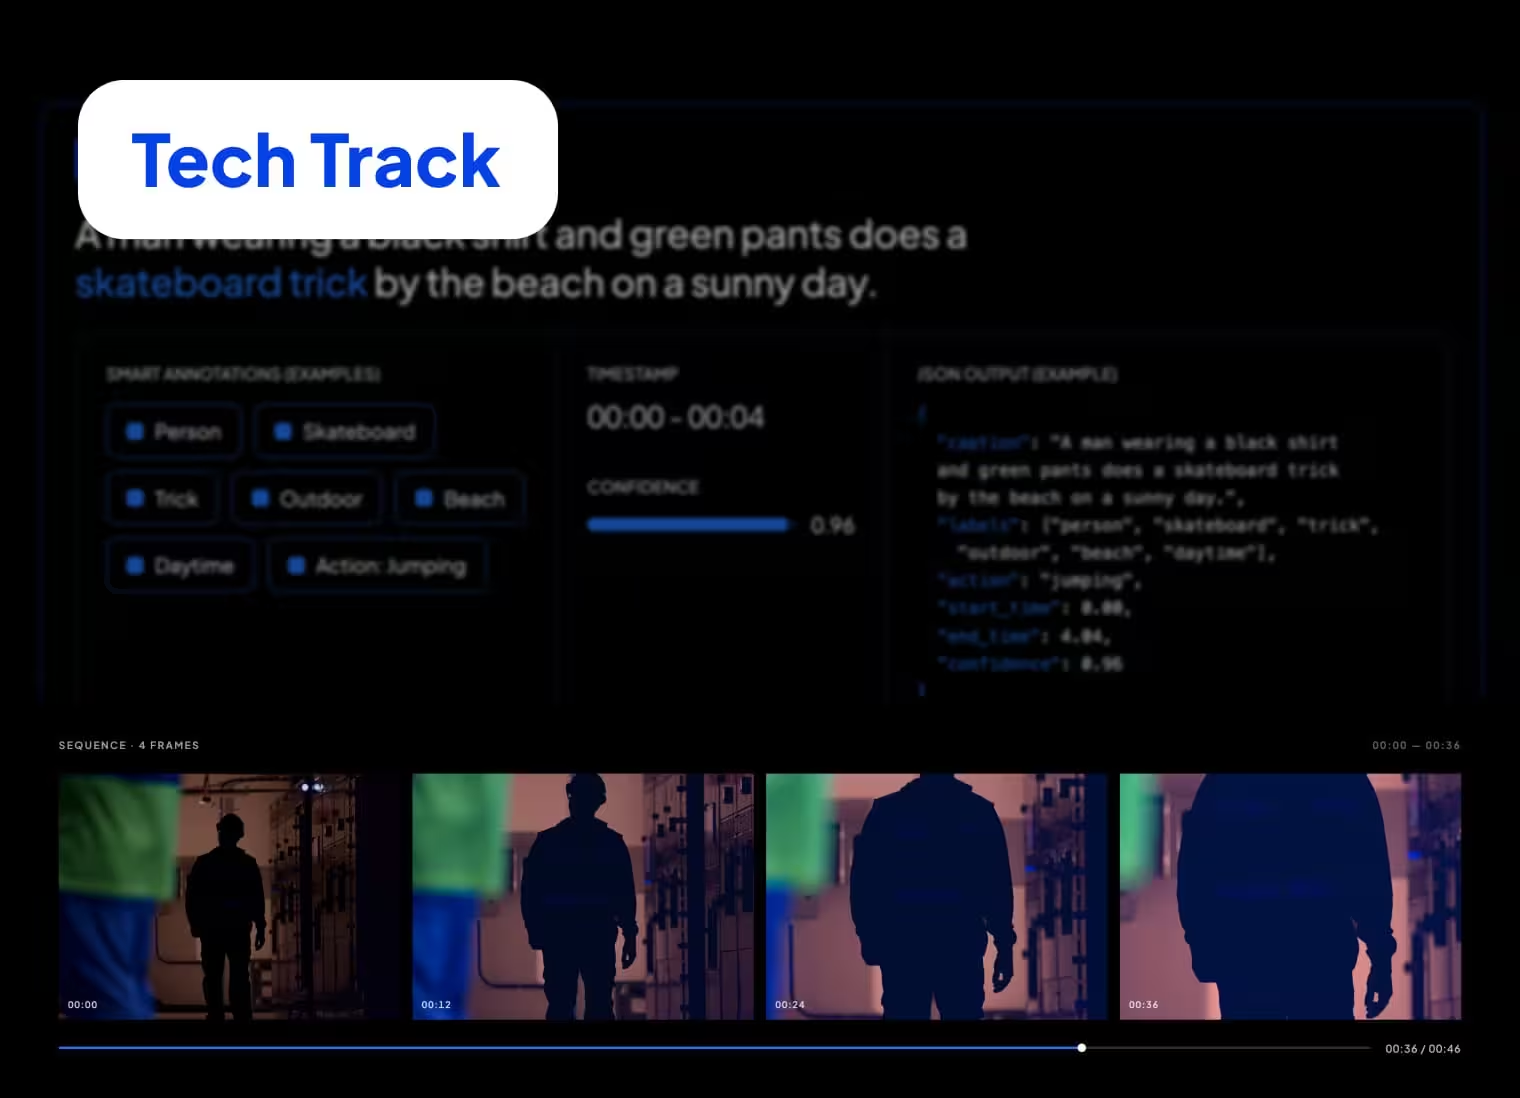
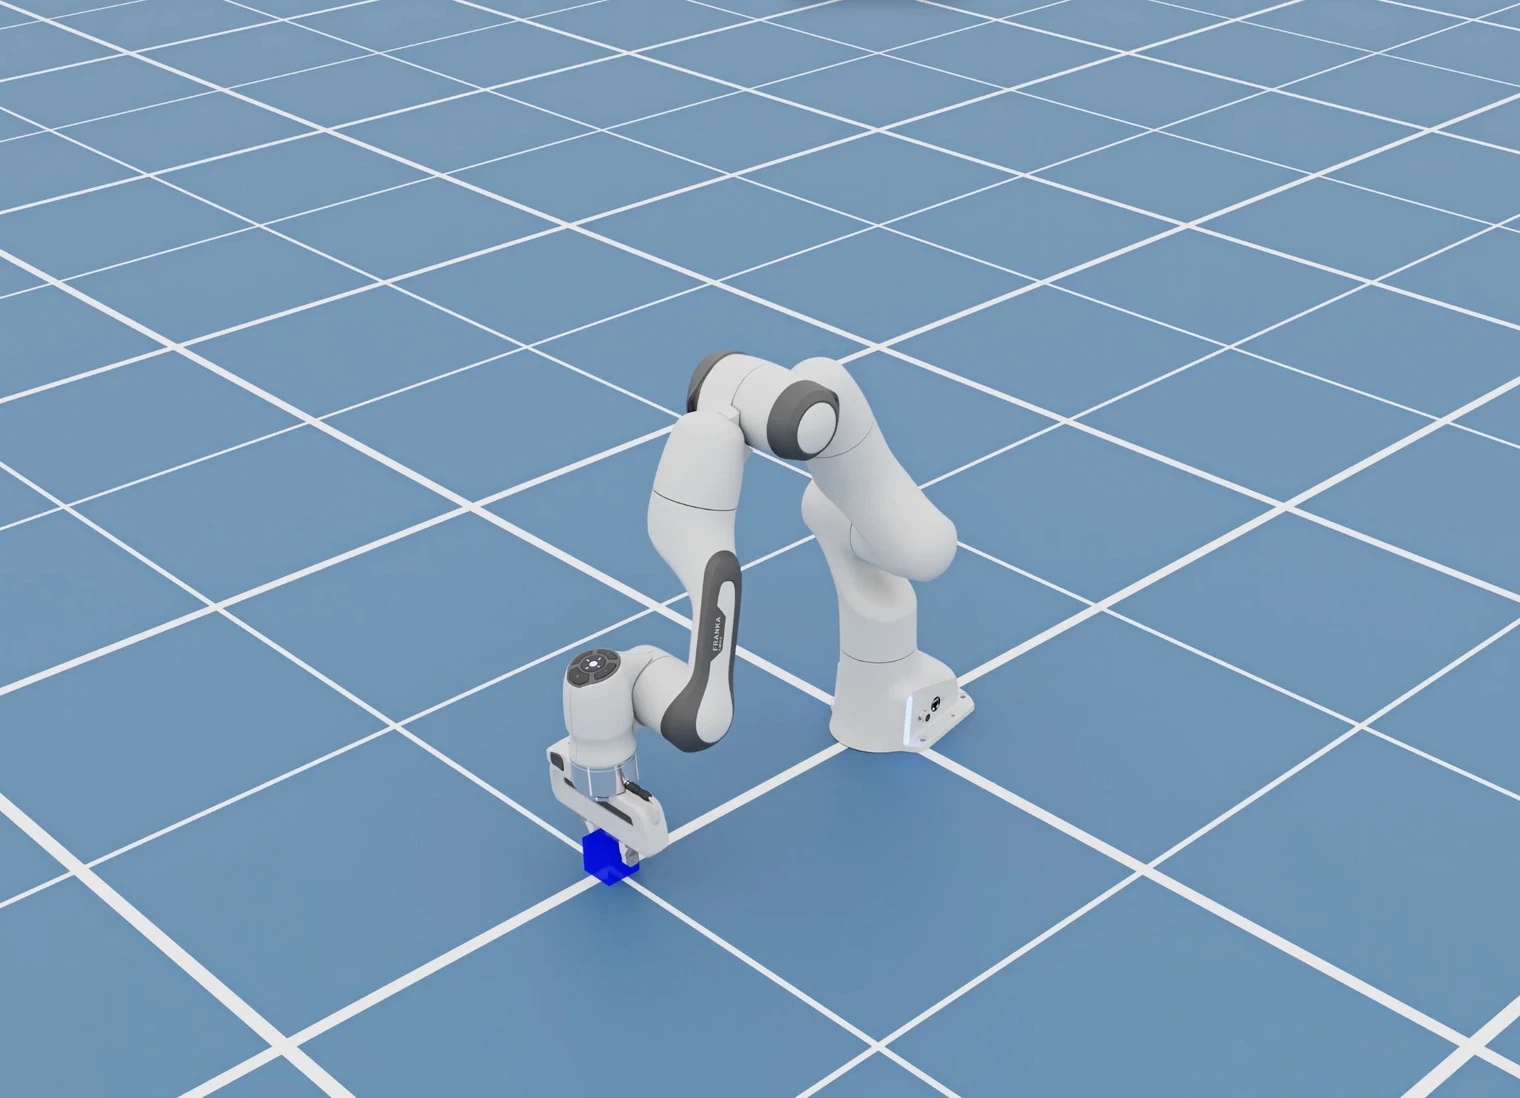
CoreWeave推出Physical AI Launchables工具,支持单命令运行机器人和自动驾驶工作负载,集成NVIDIA Isaac Sim等工具并提供数据增强功能。
入选理由:通过单命令运行NVIDIA Isaac Sim、CARLA等工具的工作负载,无需搭建环境
公司
提供AI开发工具链的云计算公司
最近变化
2026-10-21 · NVIDIA HGX Rubin NVL8内存带宽达130 TB/s,支持实时处理大规模数据集
CoreWeave 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「CoreWeave」相关的 AI 资讯和分析。
CoreWeave推出Physical AI Launchables工具,支持单命令运行机器人和自动驾驶工作负载,集成NVIDIA Isaac Sim等工具并提供数据增强功能。
入选理由:通过单命令运行NVIDIA Isaac Sim、CARLA等工具的工作负载,无需搭建环境
NVIDIA HGX Rubin NVL8通过HBM4和第六代NVLink大幅提升性能,CoreWeave云平台将支持该架构,降低运营成本并提升AI、HPC和数据分析效率。
入选理由:NVIDIA HGX Rubin NVL8内存带宽达130 TB/s,支持实时处理大规模数据集
液冷技术显著提升AI数据中心GPU性能并减少环境影响,CoreWeave通过直接到芯片的液冷方案成为行业领导者。
入选理由:直接到芯片液冷使周围空气温度上升减少50%
CoreWeave推出SUNK新功能,简化AI研究集群构建,提升训练效率。
入选理由:SUNK自我服务功能可将集群搭建时间缩短30%以上
CoreWeave Sandboxes提供安全、可扩展的执行层,用于大规模运行代理AI工作负载,通过Kubernetes和Kata容器实现强隔离。
入选理由:CoreWeave Sandboxes通过Kubernetes Pod和Kata容器实现硬件级隔离,防止代码破坏宿主机。
CoreWeave通过液冷系统、可观察性增强等创新,使NVIDIA Vera Rubin NVL72实现AI训练效率提升4倍,推理成本降低10倍。
入选理由:液冷系统软件定义使冷却效率提升30%
算力公司融资风险与回本周期直接相关,长期合同和利率飙升可能推高债务危机概率。
入选理由:CoreWeave需筹集350亿美元,GPU贷款利率已达15%
AI循环的动态特性要求安全审查必须适应实时控制、观察和验证,而不仅仅是静态边界。
入选理由:AI循环要求安全控制必须实时可验证,覆盖模型训练、推理和迭代全流程
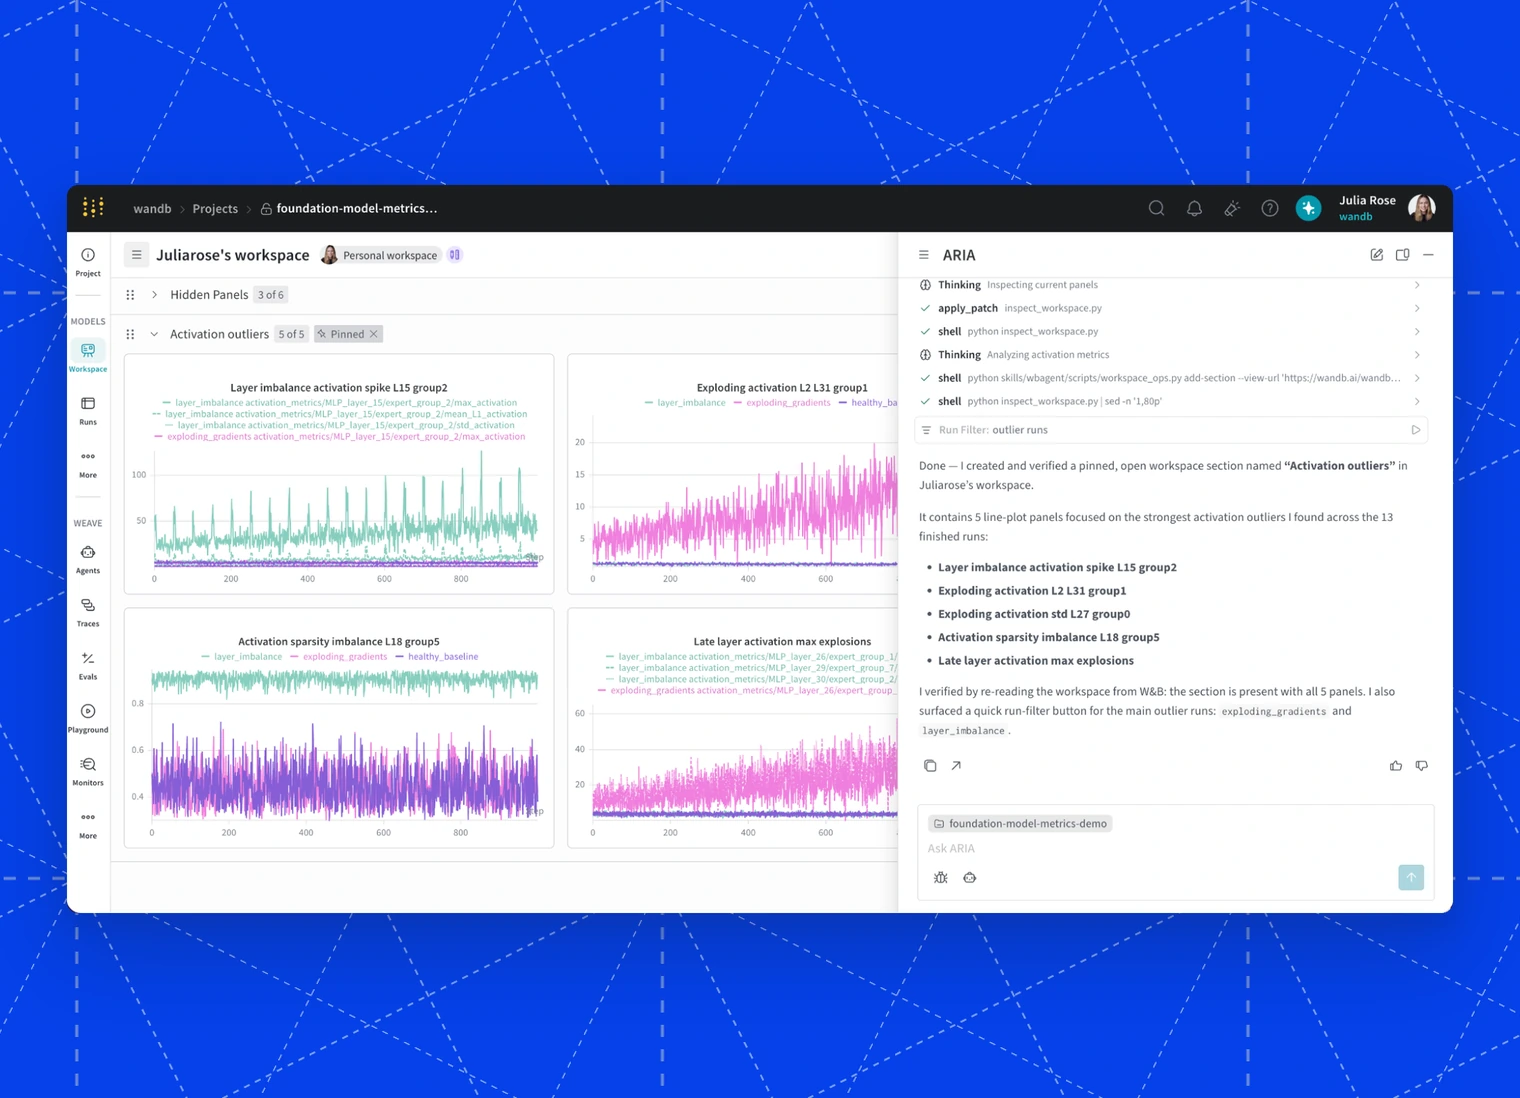
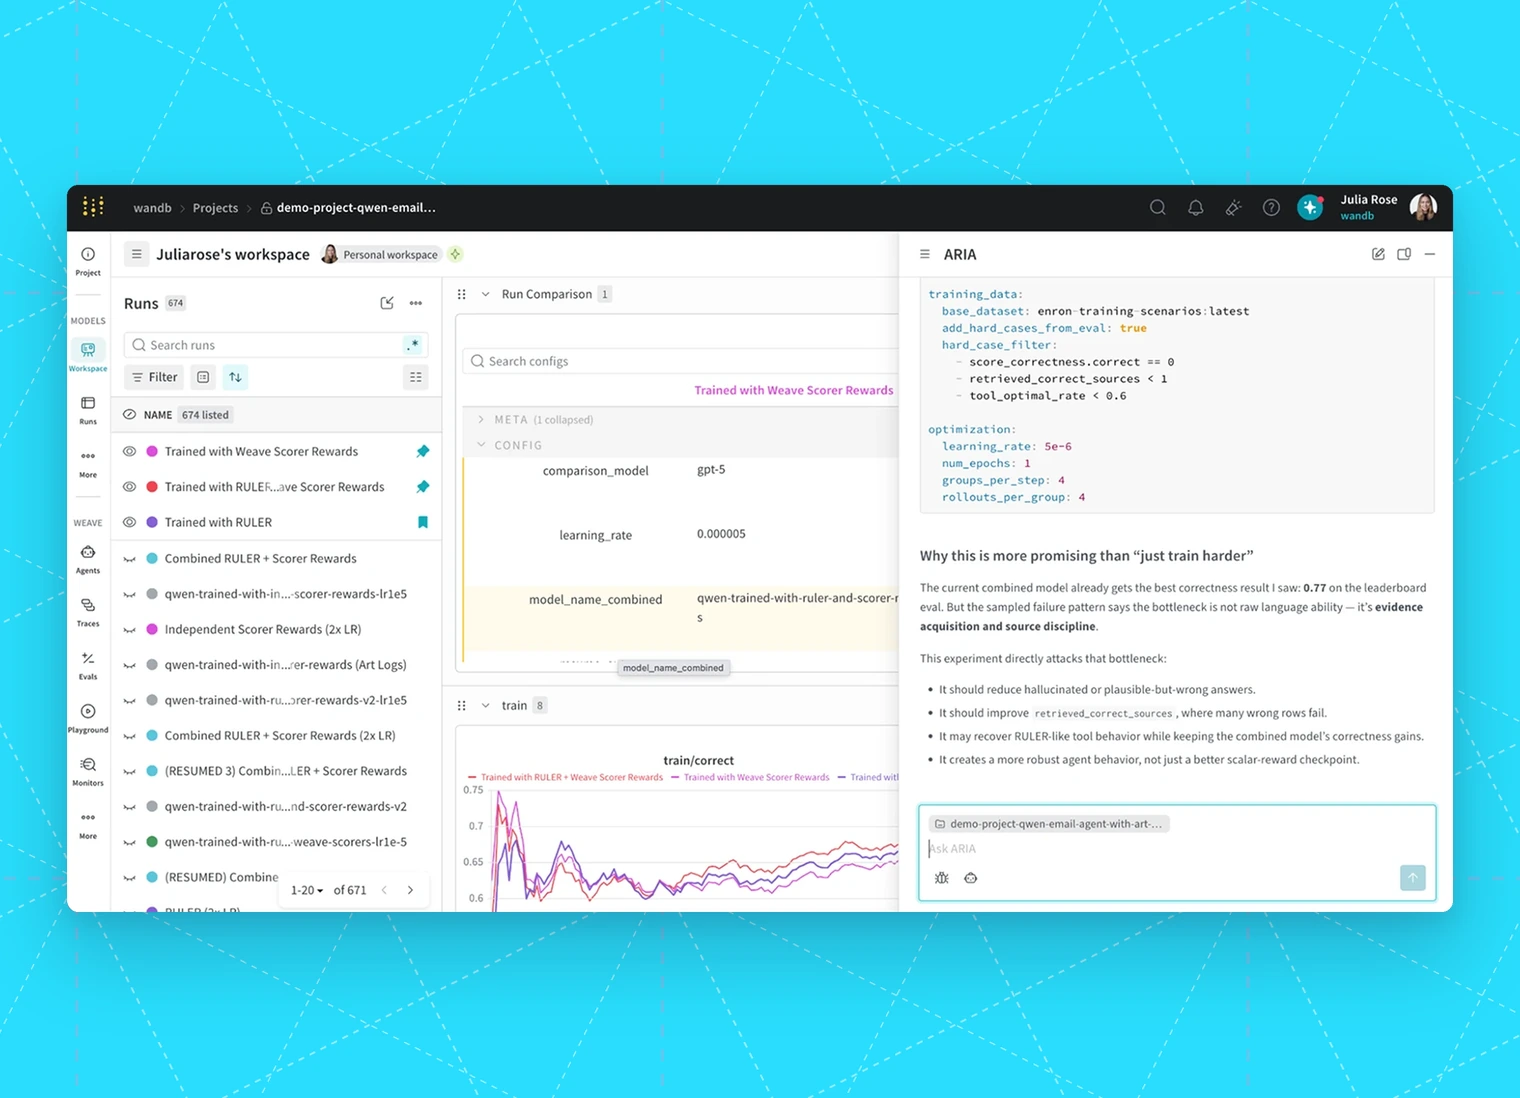
ARIA通过整合上下文和持久化输出,显著提升实验分析效率,成为W&B平台中的智能研究助手。
入选理由:ARIA利用W&B上下文自动分析实验数据,减少用户手动输入需求。
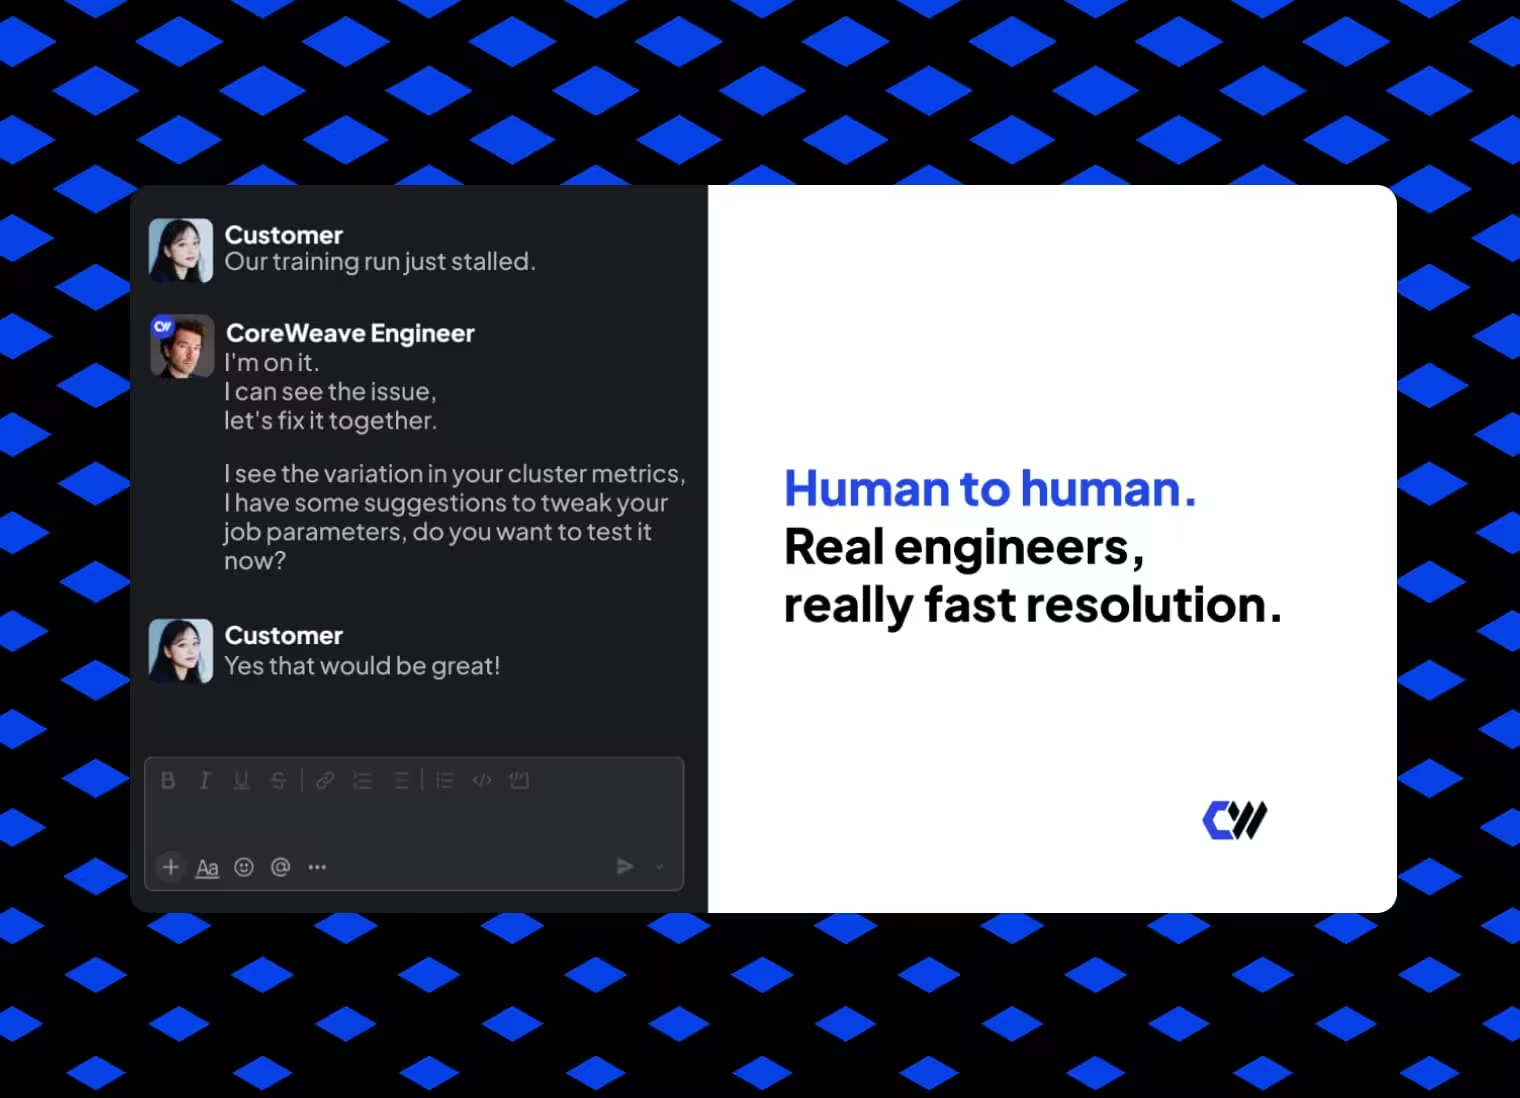
CoreWeave Direct-to-Expert服务通过直接连接云平台工程师,实现AI基础设施问题分钟级响应,节省调试时间并优化资源分配。
入选理由:直接连接工程师可缩短问题解决时间至分钟级,避免排队等待
CoreWeave通过NVIDIA工具实现RL训练后模型重载加速15倍,解决大模型训练中的GPU等待问题。
入选理由:使用NVIDIA ModelExpress和Router可实现15×模型重载加速
CoreWeave通过Weave平台实现ARIA的生产对齐评估,确保基准测试与实际运行环境一致。
入选理由:生产环境重试成功不等于问题解决,需对比配置变更效果
CoreWeave Agent Lens通过自动化分析OpenTelemetry数据,实现AI代理可观测性与改进,可聚类用户意图和失败模式并优先处理关键问题。
入选理由:Agent Lens自动处理OpenTelemetry数据,无需配置即可提取语义聚类
AI通过连接人类已有知识,加速跨学科创新和突破。文章强调AI将重塑科研范式,使非专业人士也能实现技术突破。
入选理由:AI可跨学科连接隐藏的知识关联,如生物发现解决工程问题
CoreWeave ARIA是集成在Weights & Biases中的AI代理,通过自动分析实验、生成假设并启动实验,实现模型迭代效率提升。
入选理由:ARIA将实验循环时间从小时级缩短至分钟级,提升研发效率。
代理推理需前缀感知路由基础设施以减少重复计算,提升性能。前缀缓存可降低TTFT但依赖基础设施支持。
入选理由:前缀缓存可减少70%的重复计算开销
CoreWeave为物理AI提供定制化基础设施,支持Wayve、Decart等公司实现高效训练和实时推理。
入选理由:物理AI需要生成模拟训练数据,真实场景数据不足时需依赖仿真
构建多平面网络架构需解决Agentic AI的高并发低延迟需求,通过非阻塞设计、1:1上行链路比例和多平面分离等方案实现。
入选理由:非阻塞网络设计可避免训练峰值导致的代理链阻塞
CoreWeave支持部署2.8万亿参数的Kimi K3模型,提供租户隔离网关和GPU优化服务,适合需要大规模推理的用户。
入选理由:Kimi K3是2.8万亿参数的开源模型,支持百万级上下文窗口和视觉理解。
Anyscale与CoreWeave通过优化GPU基础设施,实现600TB视频数据95分钟处理完成,展示大规模视频字幕生成的工程实践。
入选理由:使用Ray和CoreWeave Kubernetes服务可将GPU集群部署时间从数月缩短至1小时
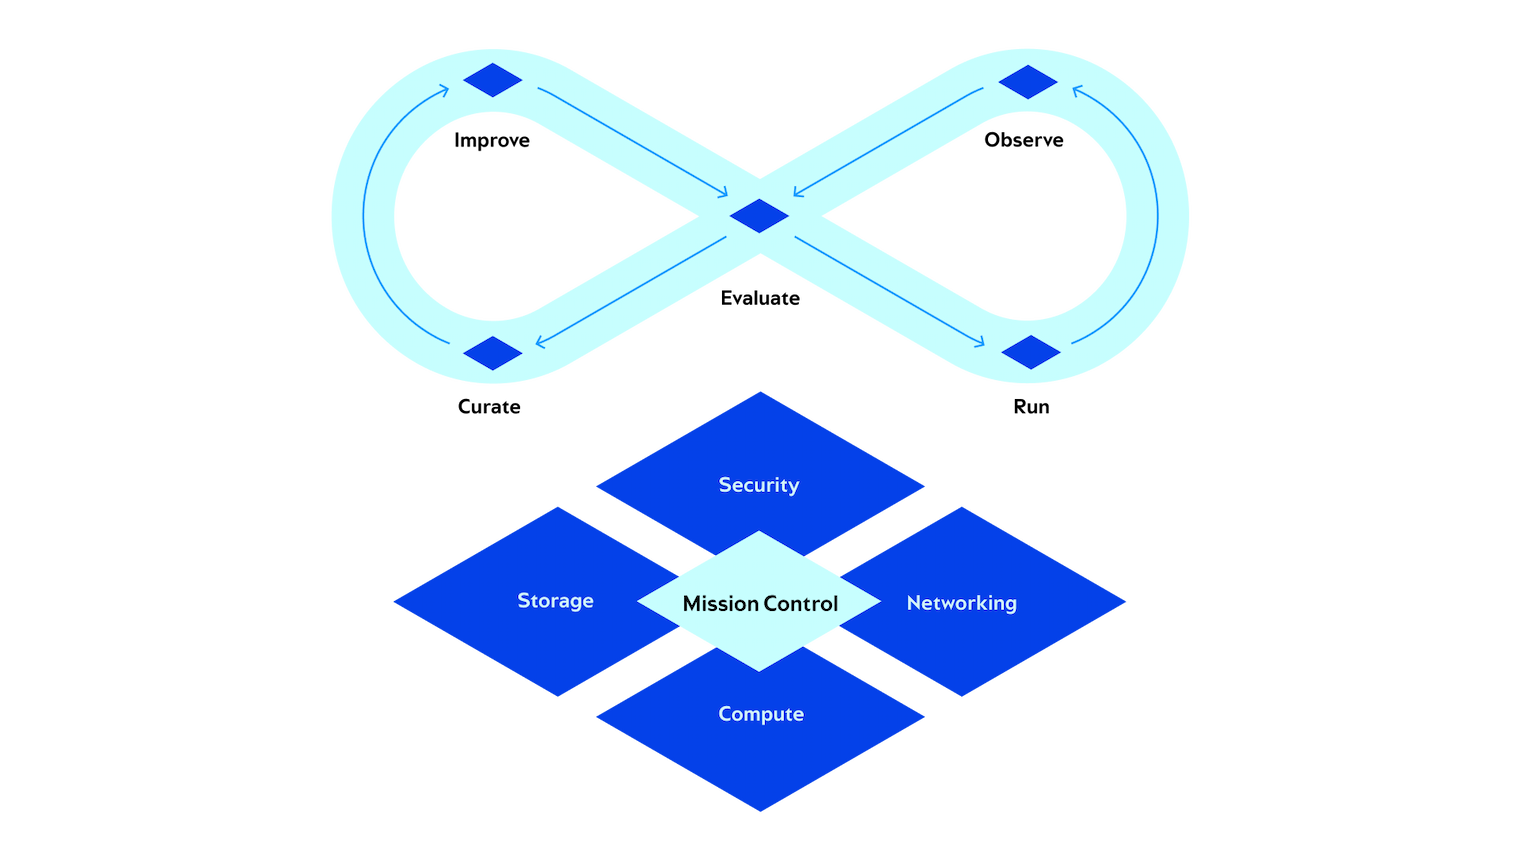
AI Loop框架通过持续循环优化模型,提升效率和准确性,适合工程师关注。
入选理由:AI Loop包含运行、观察、整理、评估、改进五个步骤,形成闭环优化
AI工厂运营的核心是优化goodput指标,CoreWeave在NVIDIA Hopper GPU上实现96%的goodput,揭示吞吐量与弹性对AI系统效率的决定性影响。
入选理由:CoreWeave在NVIDIA Hopper GPU上实现最高96%的goodput,显著提升AI训练效率
Weights & Biases达成10亿次模型训练运行里程碑,推出CoreWeave ARIA工具加速AI研究自动化。
入选理由:10亿次运行里程碑显示AI实验规模呈指数级增长
CoreWeave在MLPerf 0.7 Endpoints基准测试中,使用68块NVIDIA Blackwell GPU实现每秒44万输出token,验证了DeepSeek-R1模型的高效推理能力。
入选理由:CoreWeave在MLPerf 0.7测试中使用68块NVIDIA Blackwell GPU实现了441,740 token/s的吞吐量
AI代理系统性能取决于基础设施质量,长流程工作流对延迟和可靠性影响显著。
入选理由:代理工作流的基础设施需求是传统聊天机器人的3-5倍
AI工厂需在生产前验证基础设施可靠性,NVIDIA与CoreWeave合作提升AI计算效率。
入选理由:AI工厂需验证全栈系统连续运行能力,避免GPU资源浪费和项目延误
MLPerf Endpoints v0.7发布,提供动态、全面的AI推理基准,支持企业采购决策。
入选理由:MLPerf Endpoints v0.7支持自动化提交和实时结果可视化
数据中心应与社区合作,通过负责任的开发带来经济和基础设施利益,同时避免将成本转嫁给用户。
入选理由:CoreWeave签署美国用户保护承诺,确保社区不承担能源成本
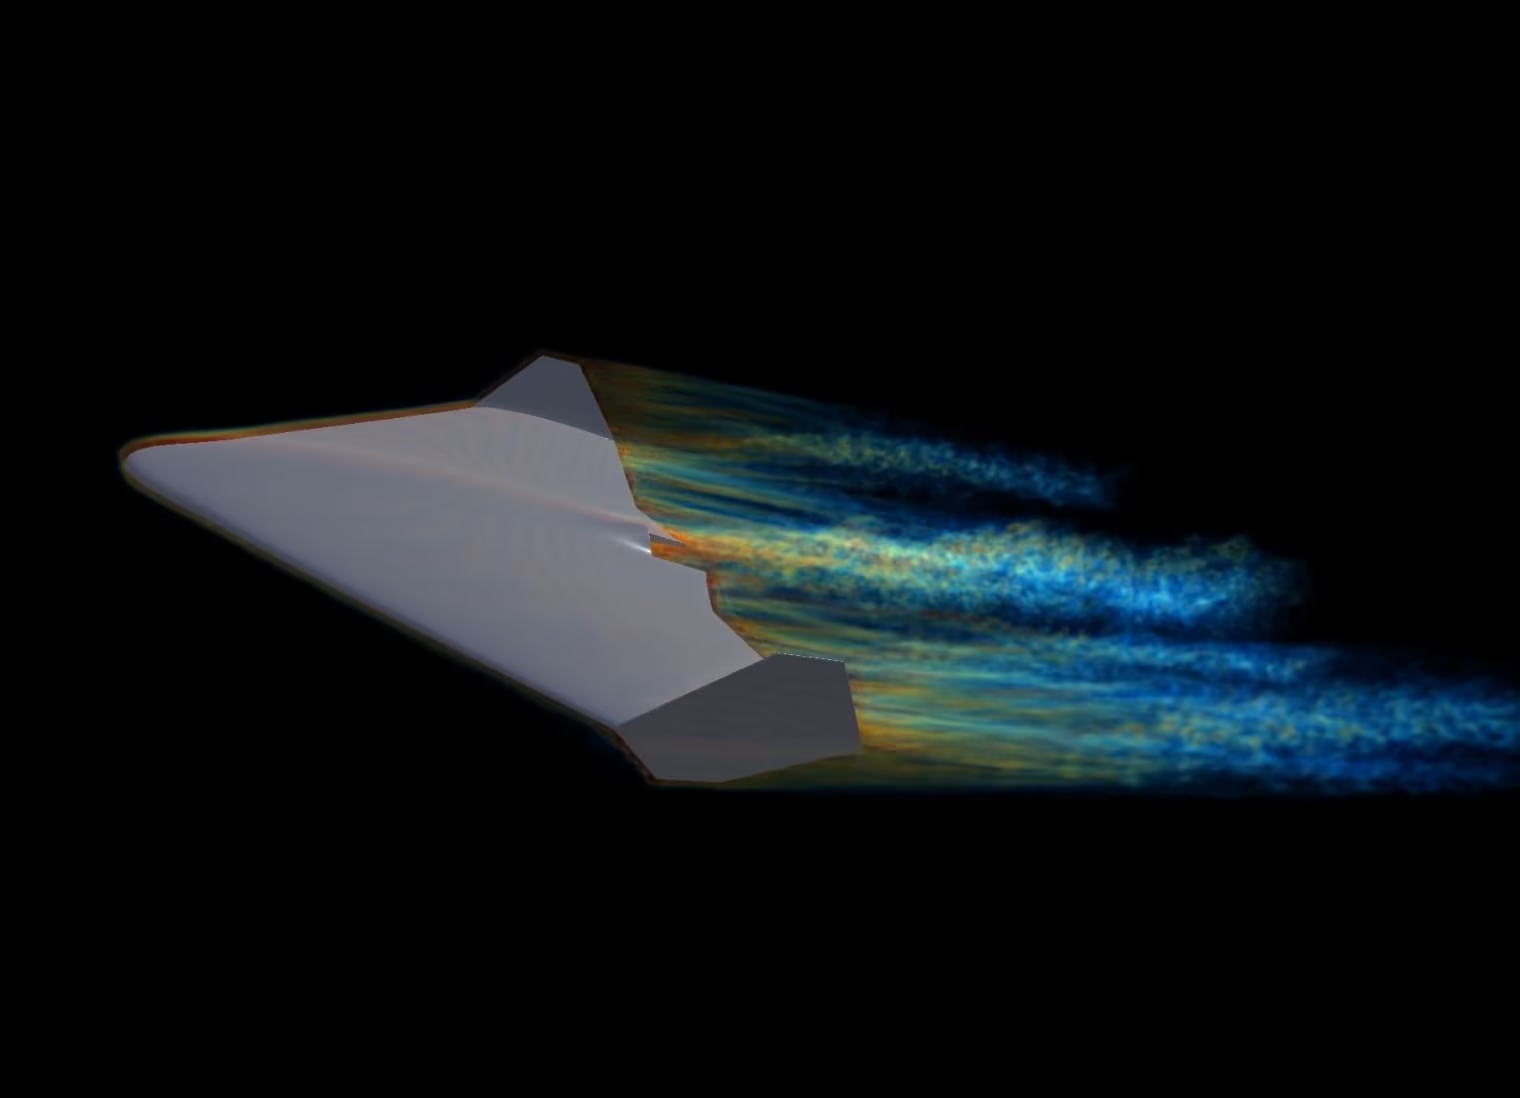
nTop与CoreWeave通过GPU加速技术,在32小时内完成10,000次LES模拟,提前达成NASA CFD 2030目标。
入选理由:GPU加速使CFD模拟效率提升至传统方法的100倍以上
CoreWeave与Aston Martin Aramco合作,利用AI代理实时处理F1无线电通信,提取关键信息辅助比赛策略,解决海量音频数据处理难题。
入选理由:F1无线电处理需应对38万单词/50小时音频的实时分析挑战
与「CoreWeave」经常一起出现的 AI 术语。
💡 想追踪「CoreWeave」的长期趋势?去 实体雷达 · CoreWeave 查看详细分析和跨材料问答。