Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice Cloning
Hugging Face 推出 Open TTS Leaderboard,通过客观指标解决 TTS 模型评估碎片化问题,评估时间从数周缩短至数小时。
入选理由:Open TTS Leaderboard 使用 WER/CER、RTFx、TTFA、SIM 等指标,评估时间从数周缩短至数小时
概念
别名:词错误率
词错误率,衡量语音识别准确性
已跟踪 8 条高相关材料
最近变化
2026-09-30 · Open TTS Leaderboard 使用 WER/CER、RTFx、TTFA、SIM 等指标,评估时间从数周缩短至数小时
为什么值得关注
WER 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice Cloning
Hugging Face Blog · 8.5 分
Hugging Face 推出 Open TTS Leaderboard,通过客观指标解决 TTS 模型评估碎片化问题,评估时间从数周缩短至数小时。
The Open ASR Leaderboard Adds Its First Global South Language
Hugging Face Blog · 8.5 分
Hugging Face推出全球首个覆盖印度语的开放ASR评估基准,通过多维度数据设计解决语音识别模型的系统性偏差问题。
Introducing Gemini 3.5 Transcribe, our new speech to text model with smart transcription, function c...
Logan Kilpatrick(@OfficialLoganK) · 8.5 分
Gemini 3.5 Transcribe 是 Google 推出的新一代语音转文字模型,支持 85 种语言、实时流媒体和多说话人识别。
已收录 8 条与 WER 相关的内容,按评分排序。
Hugging Face 推出 Open TTS Leaderboard,通过客观指标解决 TTS 模型评估碎片化问题,评估时间从数周缩短至数小时。
入选理由:Open TTS Leaderboard 使用 WER/CER、RTFx、TTFA、SIM 等指标,评估时间从数周缩短至数小时
Hugging Face推出全球首个覆盖印度语的开放ASR评估基准,通过多维度数据设计解决语音识别模型的系统性偏差问题。
入选理由:Monsoon评估集包含4,888名说话者,记录12个属性确保多样性
Google推出Gemini 3.5 Transcribe语音识别模型,实现亚秒级实时流处理,非流式WER低至2.6%,支持85种语言并减少70%处理时间。
入选理由:Gemini 3.5 Transcribe非流式WER达2.6%,流式为4.0%
Gemini 3.5 Transcribe 是 Google 推出的新一代语音转文字模型,支持 85 种语言、实时流媒体和多说话人识别。
入选理由:支持 85 种语言及多说话人识别,适用全球化场景
Results released by Xiaohu show their speech conversion technology performs excellently in cross-language WER tests, with Chinese-to-English WER at only 3.19% and Korean-to-English WER at only 3.42%, significantly outperforming competitors like CosyVoice. This demonstrates significant breakthroughs in multilingual speech synthesis technology.
入选理由:小互技术中文转英文WER为3.19%,远优于CosyVoice2的17.10%
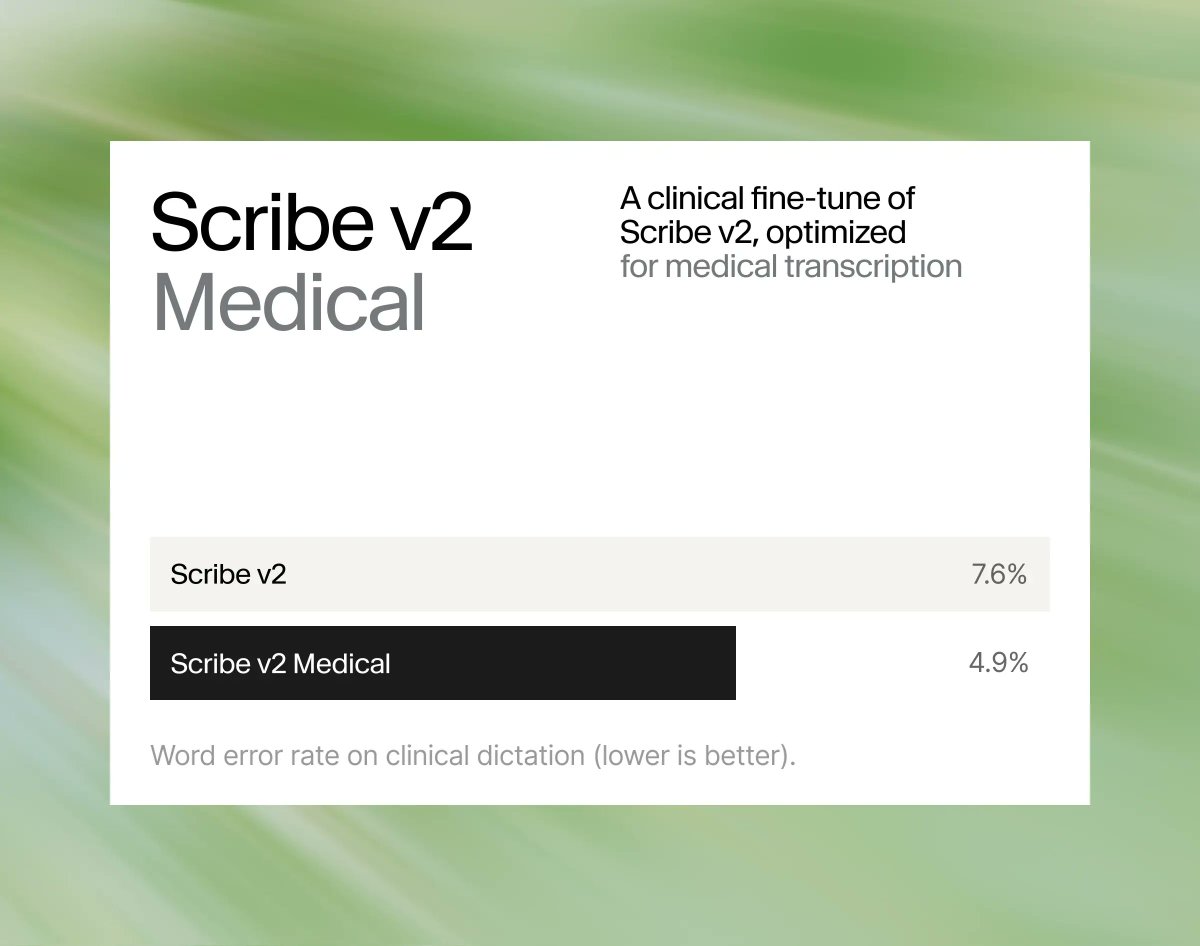
ElevenLabs发布Scribe v2 Medical,临床语音转录错误率降低35%。
入选理由:Scribe v2 Medical在临床音频上降低35%词错误率(WER)
腾讯发布Hy ASR 3.0语音识别系统,多语言错误率低至3%,支持方言及复杂场景应用。
入选理由:Hy ASR 3.0多语言语音识别错误率(WER)达3%,行业领先
Hugging Face introduces private datasets to prevent models from over-optimizing on public ASR test sets, while keeping the public Average WER unchanged to preserve real-world performance measurement.
入选理由:引入私有数据集防止模型针对公开测试集过度优化(benchmaxxing)。