Better speech synthesis for audiobooks
Amazon Science1425 字 (约 6 分钟)
85
Audible的可控TTS系统通过自然语言描述和角色分析,显著提升有声书语音合成的准确性和表现力。
入选理由:可控TTS系统实现角色对话识别97%准确率(英文)
FeaturedArticle#Speech Synthesis#TTS#Audiobooks#Amazon英文
概念
别名:Text-to-Speech
将文本转换为语音的合成技术。
已跟踪 20 条高相关材料
最近变化
2026-10-23 · 可控TTS系统实现角色对话识别97%准确率(英文)
为什么值得关注
TTS 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Better speech synthesis for audiobooks
Amazon Science · 8.5 分
Audible的可控TTS系统通过自然语言描述和角色分析,显著提升有声书语音合成的准确性和表现力。
The Roadmap to Mastering Voice Agents
Machine Learning Mastery · 8.5 分
语音代理包含STT、语言处理和TTS三阶段,其设计需解决延迟和复合错误问题,提供七阶段学习路径。
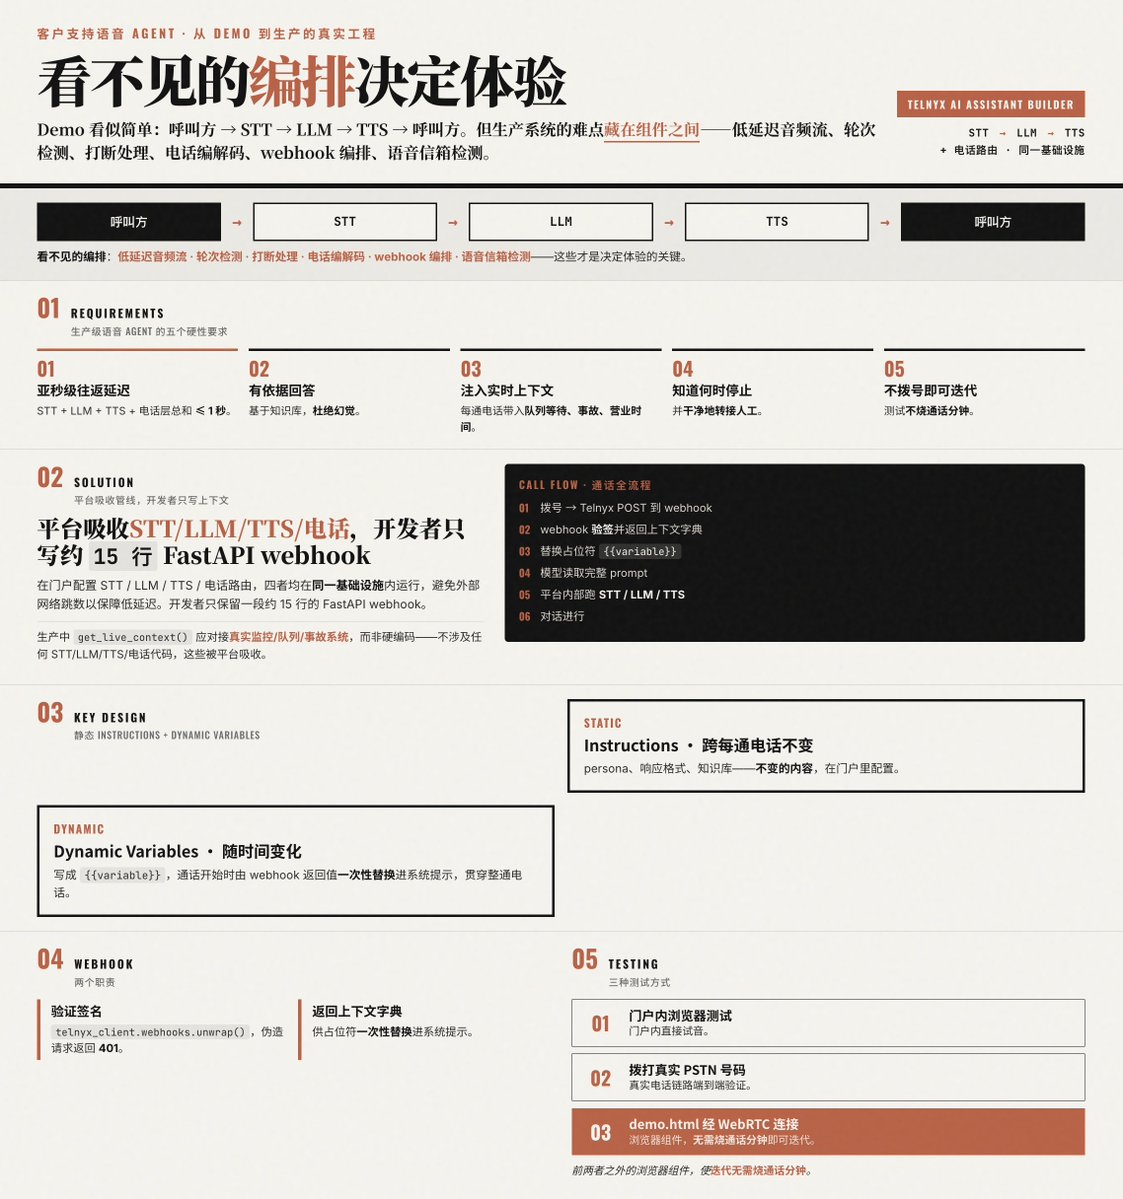
客户支持语音 Agemt:从 Demo 到生产的真实工程 语音 AI 的 demo 看似简单:呼叫方 → STT → LLM → TTS → 呼叫方。但生产系统的难点藏在组件之间——低延迟音频流、轮...
meng shao(@shao__meng) · 8.5 分
生产级语音Agent需解决低延迟、上下文注入等五大挑战,Telnyx平台提供基础设施支持。
已收录 20 条与 TTS 相关的内容,按评分排序。
Audible的可控TTS系统通过自然语言描述和角色分析,显著提升有声书语音合成的准确性和表现力。
入选理由:可控TTS系统实现角色对话识别97%准确率(英文)
语音代理包含STT、语言处理和TTS三阶段,其设计需解决延迟和复合错误问题,提供七阶段学习路径。
入选理由:语音代理需处理STT/TTS转换,增加系统延迟约束
生产级语音Agent需解决低延迟、上下文注入等五大挑战,Telnyx平台提供基础设施支持。
入选理由:亚秒级往返延迟要求STT+LLM+TTS+电话层总和≤1秒
豆包音频生成模型 Seed Audio 1.0 能生成人声、音乐、音效等复杂声音,标志着声音模型进入新阶段。
入选理由:Seed Audio 1.0 可生成人声、音乐、音效及环境音等复杂声音。
Building Voice Agents requires ASR/VOD/TTS/LLM + WebRTC. Agora Skills enables low-latency real-time voice interaction with 1-second response.
入选理由:使用Agora Skills可在2-3分钟内安装并集成RTC、RTM等组件,支持快速开发Voice Agent
Xiaomi's open-source OmniVoice model supports over 600 languages for multi-language voice cloning, significantly reducing TTS system development costs.
入选理由:OmniVoice 支持超过600种语言,覆盖全球99%以上人口的语言需求。
Fish Audio的Drama 3实现语音片段单字级编辑,无需重新生成整段语音,支持情感/节奏控制和角色切换。
入选理由:Drama 3支持单字级语音编辑,节省80%重复生成时间
网易有道「子曰4」全模态大模型开源,支持图像/视频/语音输入,27B参数可本地部署,尤其适用于学习场景,TTS引擎独立开源,支持14种语言跨语种生成。
入选理由:「子曰4」支持多模态输入,27B参数可本地化部署。
语音代理开发采用级联架构优化各模块,但技术细节不足影响深度。
入选理由:99%代理使用级联架构实现模块独立优化
开源声音创作工具包支持本地TTS、声音克隆和情感控制,但缺乏技术细节与使用场景说明。
入选理由:工具包支持声音克隆与情感控制功能
Oxford postdoc Kevin Lin has open-sourced the video translation tool Violin, supporting multilingual translation and video dialogue functions.
入选理由:Violin整合ASR、LLM翻译和TTS技术
该推文未提供技术深度,仅泛泛提及音频质量对视频效果的影响,缺乏具体方法论和数据支撑。
入选理由:音频质量显著影响视频观众留存率
Fish Audio宣布推出语音克隆服务,但未提供技术细节或使用价值说明。
入选理由:Fish Audio推出语音克隆功能,可通过其平台实现声音克隆
Fish Audio 推出 Voice Design 工具,允许用户为角色定制语音,但内容信息量低,缺乏技术深度。
入选理由:Fish Audio 推出 Voice Design 工具,用于定制角色语音。
Fish Audio 推出个性化语音生成服务,但内容信息量低,缺乏技术深度。
入选理由:Fish Audio 提供个性化语音生成服务。
文章推荐了五种免费商用语音,但缺乏技术深度和实用价值。
入选理由:文章推荐了五种免费商用语音
Fish Audio 推出新功能,支持生成逼真语音,但文章内容信息量不足。
入选理由:Fish Audio 推出语音生成功能
Fish Audio 提供无需录音的 AI 语音生成服务,适用于 vlog 制作。
入选理由:Fish Audio 支持零录音生成语音,适合 vlog 制作。
Fish Audio released an audio work titled 'The Elevator Lady's Dream' using TTS technology.
入选理由:Fish Audio 推出了新的语音合成作品《电梯女士的梦》。
Fish Audio 在东京部署了12,750辆出租车的语音广告,覆盖半数东京Prime出租车。
入选理由:Fish Audio 在东京Prime出租车中部署了12,750个语音广告终端