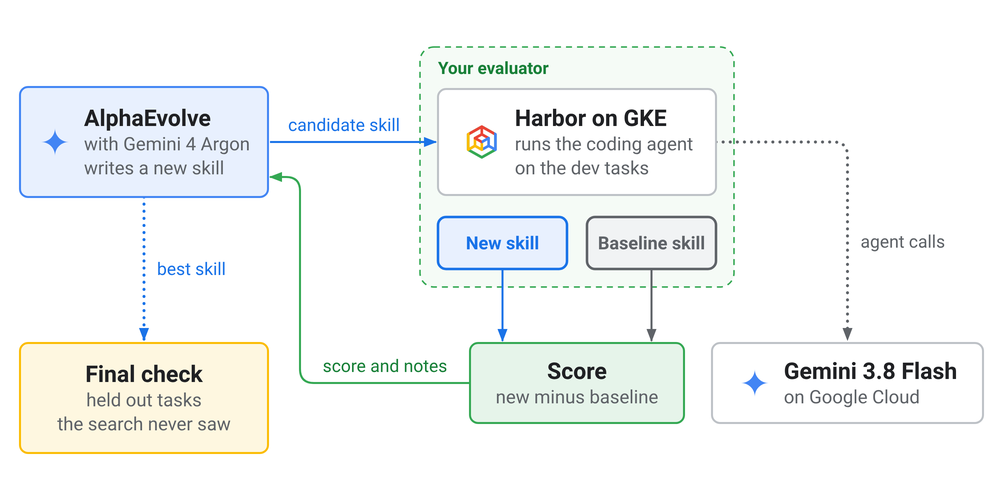
Building an agent skill optimizer with AlphaEvolve, Harbor and Gemini 4 Argon
通过AlphaEvolve和Harbor结合Gemini 4 Argon,可将代理技能优化效率提升5%,显著提高任务成功率。
入选理由:AlphaEvolve与Harbor结合使用可使任务成功率提升5%
论文
别名:terminalbench2.0
开源基准测试套件,用于评估终端任务解决能力。
已跟踪 2 条高相关材料
最近变化
2026-11-05 · AlphaEvolve与Harbor结合使用可使任务成功率提升5%
为什么值得关注
Terminal-Bench 2.0 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Building an agent skill optimizer with AlphaEvolve, Harbor and Gemini 4 Argon
Google Cloud Blog · 8.5 分
通过AlphaEvolve和Harbor结合Gemini 4 Argon,可将代理技能优化效率提升5%,显著提高任务成功率。
https://t.co/gEIxt9RMBF
Augment Code(@augmentcode) · 7.5 分
Augment Code 发布的基准测试显示,其 AI 编程助手 Auggie 在使用 Opus 4.7 模型时,以 67.4% 的通过率略高于 Claude Code 的 66.3%,同时成本降低约 33%,这主要归功于其 Context Engine 语义索引技术实现的精准...
已收录 2 条与 Terminal-Bench 2.0 相关的内容,按评分排序。
通过AlphaEvolve和Harbor结合Gemini 4 Argon,可将代理技能优化效率提升5%,显著提高任务成功率。
入选理由:AlphaEvolve与Harbor结合使用可使任务成功率提升5%
Augment Code's benchmark shows that its AI coding assistant Auggie achieves a slightly higher pass rate (67.4% vs 66.3%) than Claude Code using Opus 4.7 while costing approximately 33% less, primarily due to token efficiency from precise retrieval through its Context Engine semantic indexing technology.
入选理由:Auggie 在 Terminal Bench 2.0 上以 67.4% vs 66.3% 的通过率略胜 Claude Code,同时 token 使用量减少 32%,成本降低 33%