The Roadmap to Mastering LLM Inference Optimization
Machine Learning Mastery2483 字 (约 10 分钟)
85
LLM推理优化需针对预填充和解码阶段的性能瓶颈,通过内存管理、模型压缩等技术提升吞吐量并降低延迟。
入选理由:预填充阶段计算密集,解码阶段受内存带宽限制,需差异化优化。
FeaturedArticle#LLM#推理优化#内存管理#模型压缩#多GPU并行英文
概念
别名:假设采样
推测解码,用于提升LLM推理速度的技术方法
已跟踪 6 条高相关材料
最近变化
2026-10-14 · 直播讨论了推测解码技术对本地LLM加速的潜在价值
为什么值得关注
speculative decoding 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
The Roadmap to Mastering LLM Inference Optimization
Machine Learning Mastery · 8.5 分
LLM推理优化需针对预填充和解码阶段的性能瓶颈,通过内存管理、模型压缩等技术提升吞吐量并降低延迟。
Read the technical blog for the five guidelines: https://t.co/HaXwdiTYYB
NVIDIA AI(@NVIDIAAI) · 8.5 分
NVIDIA 技术博客提出通过 Speculative Decoding 优化大模型推理的五项指南,可使推理速度提升 2-5 倍。
Arbitrage: Efficient Reasoning via Advantage-Aware Speculation
Apple Machine Learning Research · 8.5 分
ARBITRAGE通过动态路由机制提升推理效率,在保持精度前提下减少推理延迟达2倍。
已收录 6 条与 speculative decoding 相关的内容,按评分排序。
LLM推理优化需针对预填充和解码阶段的性能瓶颈,通过内存管理、模型压缩等技术提升吞吐量并降低延迟。
入选理由:预填充阶段计算密集,解码阶段受内存带宽限制,需差异化优化。
NVIDIA 技术博客提出通过 Speculative Decoding 优化大模型推理的五项指南,可使推理速度提升 2-5 倍。
入选理由:Speculative Decoding 技术可使 LLM 推理速度提升 2-5 倍
ARBITRAGE通过动态路由机制提升推理效率,在保持精度前提下减少推理延迟达2倍。
入选理由:ARBITRAGE框架使推理延迟降低约2倍,精度保持不变
MTP is a new speculative decoding feature built into llama.cpp that can approximately double token generation speed for most use cases, achieving ~30 tok/sec with the Dense 27B model and ~100 tok/sec with the MoE model.
入选理由:MTP是内置于模型本身的投机解码新特性,可将token生成速度提升约2倍
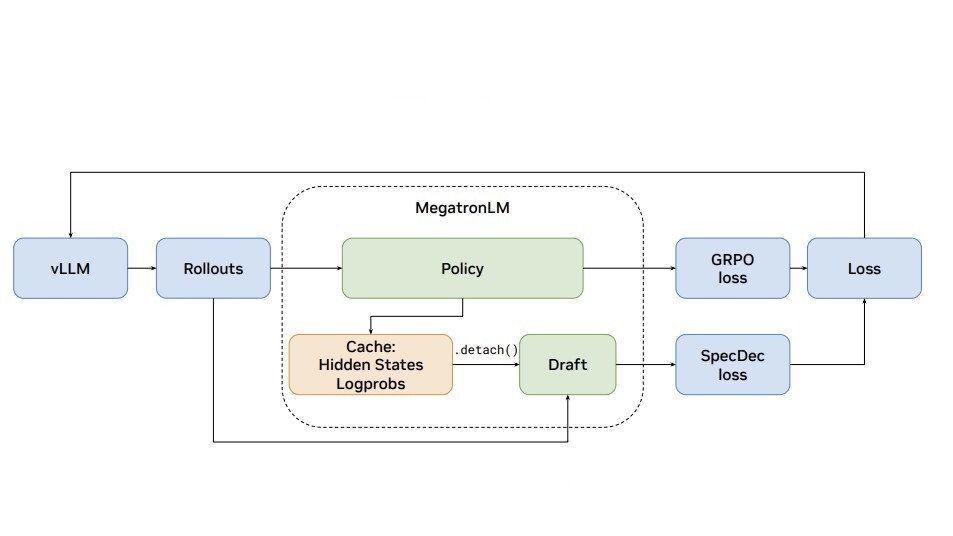
NVIDIA 研究提出将 speculative decoding 引入 NeMo-RL + vLLM 架构,实现 RL 后训练 rollout 阶段无损加速:8B 模型吞吐提升 1.8 倍,235B 模型端到端预计提速 2.5 倍。
入选理由:RLHF/RLAIF 后训练的 rollout 阶段已成为性能瓶颈
文章仅提供直播信息未展开技术细节,缺乏深度分析和实用价值。
入选理由:直播讨论了推测解码技术对本地LLM加速的潜在价值