Qwen3.8 27B addition in words
Simon Willison's Weblog553 字 (约 3 分钟)
85
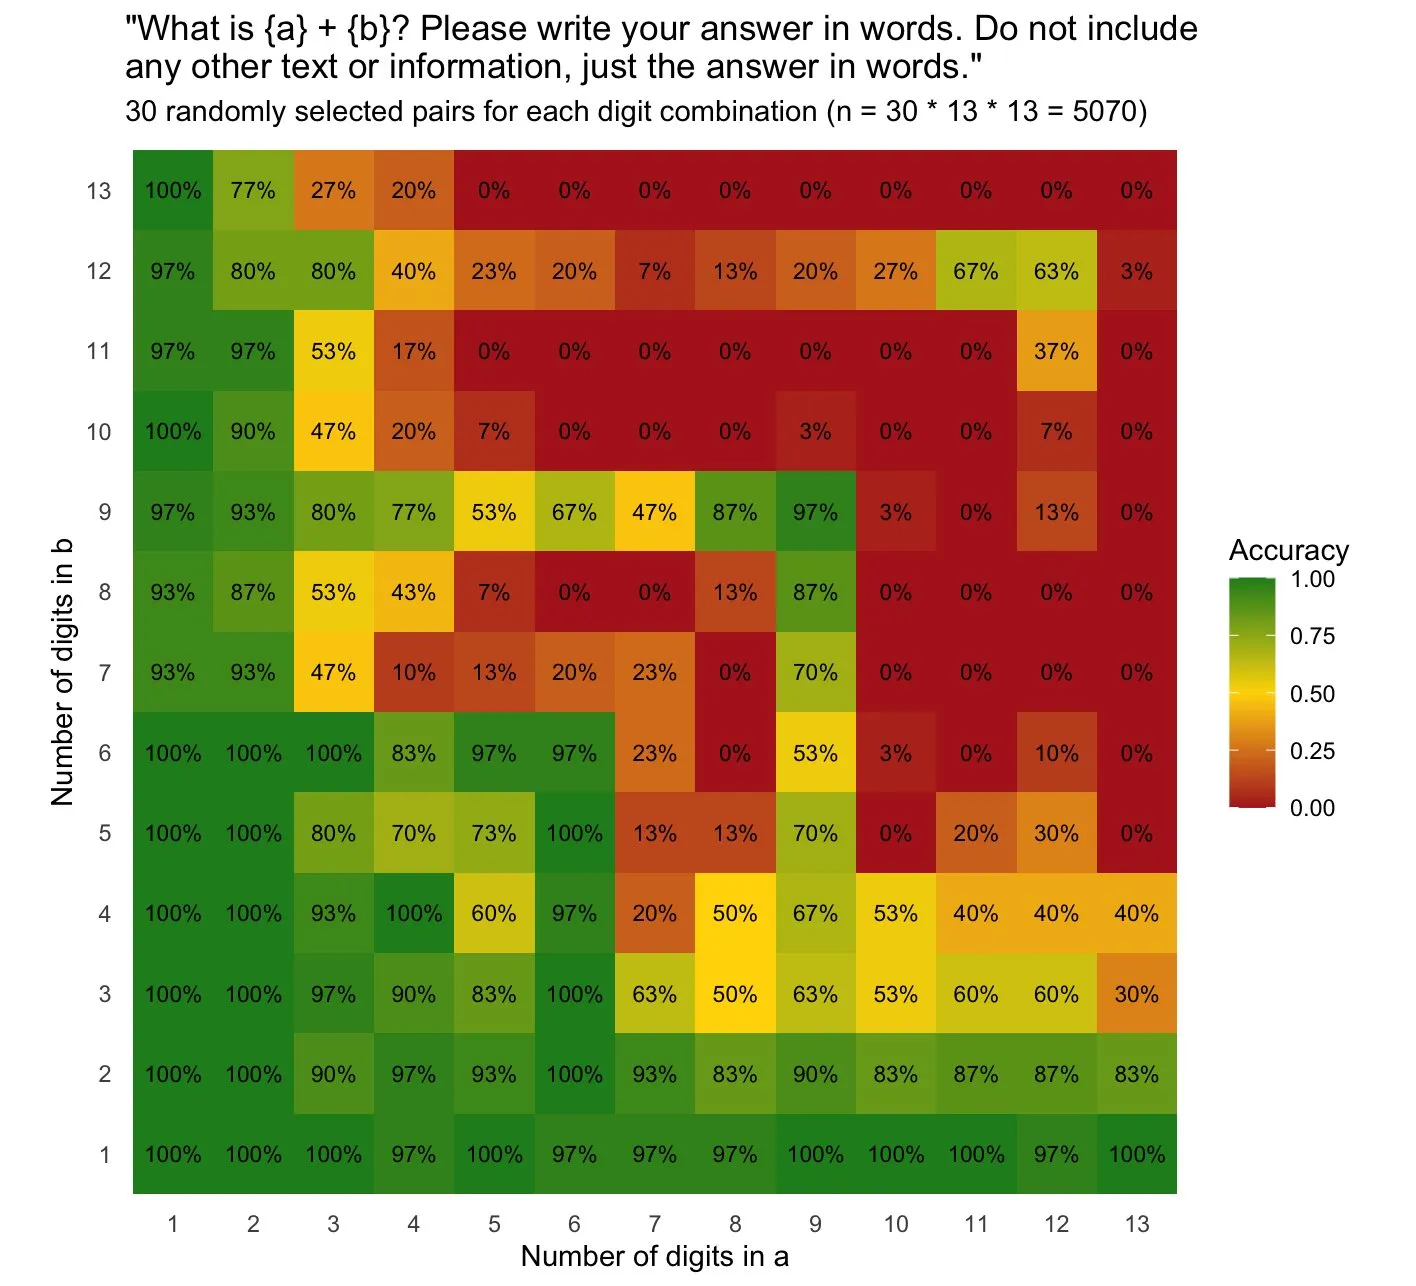
Qwen3.8-27B模型在无推理时大数相加准确率仅23.57%,启用推理后提升至97.04%。
入选理由:Qwen3.8-27B无推理时十至十三位数相加准确率仅6.44%
FeaturedArticle#Qwen3.8#LLM#推理机制#大数计算中英混合
模型
别名:Qwen/Qwen3.8-27B
27B参数量的密集型大语言模型
已跟踪 9 条高相关材料
最近变化
2026-10-04 · Qwen3.8-27B无推理时十至十三位数相加准确率仅6.44%
为什么值得关注
Qwen3.8-27B 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Qwen3.8 27B addition in words
Simon Willison's Weblog · 8.5 分
Qwen3.8-27B模型在无推理时大数相加准确率仅23.57%,启用推理后提升至97.04%。
Which is The Best Qwen3.8-27B?
Sam Witteveen · 8.5 分
Qwen3.8-27B模型通过减少思考令牌将推理时间从90秒缩短至18秒,不同优化方法在效率与准确性间取得平衡。
The same model, with the same weights, scores 62% in one agent harness and 33% in another. @adithya...
Hugging Face(@huggingface) · 8.5 分
Hugging Face发布多Harness RL训练指南,使用代理提升模型性能达12%。开源代码与训练数据可复现结果。
已收录 9 条与 Qwen3.8-27B 相关的内容,按评分排序。
Qwen3.8-27B模型在无推理时大数相加准确率仅23.57%,启用推理后提升至97.04%。
入选理由:Qwen3.8-27B无推理时十至十三位数相加准确率仅6.44%
Qwen3.8-27B模型通过减少思考令牌将推理时间从90秒缩短至18秒,不同优化方法在效率与准确性间取得平衡。
入选理由:Thinking Cap模型通过减少令牌使用将推理时间从90秒缩短至18秒
Hugging Face发布多Harness RL训练指南,使用代理提升模型性能达12%。开源代码与训练数据可复现结果。
入选理由:使用代理记录token IDs和logprobs可使LFM2.5-2.6B模型性能提升12%
Qwen3.8-27B模型在性能上显著优于Meta的Glimmer 30B,但需通过量化与部署优化实现本地高效运行。
入选理由:Qwen3.8-27B参数量达2.4万亿,远超3.6版本且性能提升明显
通义千问3.8-27B模型已通过Nebius平台开放访问,适用于多步骤工作流和深度研究。
入选理由:27B参数量的密集模型适合复杂任务规划
文章介绍通过专用Harness实现端侧模型零成本推理方案,但因环境异常无法获取完整内容。
入选理由:Qwen3.8-27B模型通过Harness实现端侧推理优化
Qwen3.6-27B在agentic coding表现优异,Qwen3.8-27B即将发布并进一步优化。
入选理由:Qwen3.6-27B在agentic coding领域表现优于Muse Glimmer 30b
Qwen3.8-27B模型已发布,邀请开发者参与共建,但技术细节披露有限。
入选理由:Qwen3.8-27B模型已通过ollama平台开放使用
推文提及Qwen3.8-27B模型在Hugging Face发布,但未提供技术细节或使用价值说明。
入选理由:Qwen3.8-27B模型已上线Hugging Face


