Announcing ADK for Kotlin 1.0: Building Production-Ready AI Agents in Kotlin, Android, and Beyond
ADK for Kotlin 1.0发布,提供生产级AI代理开发工具,集成Android原生功能与VertexAI企业平台。
入选理由:ADK 1.0支持Android原生功能,包括LiteRT-LM、ML Kit(beta)和Firebase AI Logic。
模型
用于本地运行的轻量级AI模型,支持Android设备。
已跟踪 5 条高相关材料
最近变化
2026-09-20 · ADK 1.0支持Android原生功能,包括LiteRT-LM、ML Kit(beta)和Firebase AI Logic。
为什么值得关注
LiteRT-LM 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Announcing ADK for Kotlin 1.0: Building Production-Ready AI Agents in Kotlin, Android, and Beyond
Google Developers Blog · 8.5 分
ADK for Kotlin 1.0发布,提供生产级AI代理开发工具,集成Android原生功能与VertexAI企业平台。
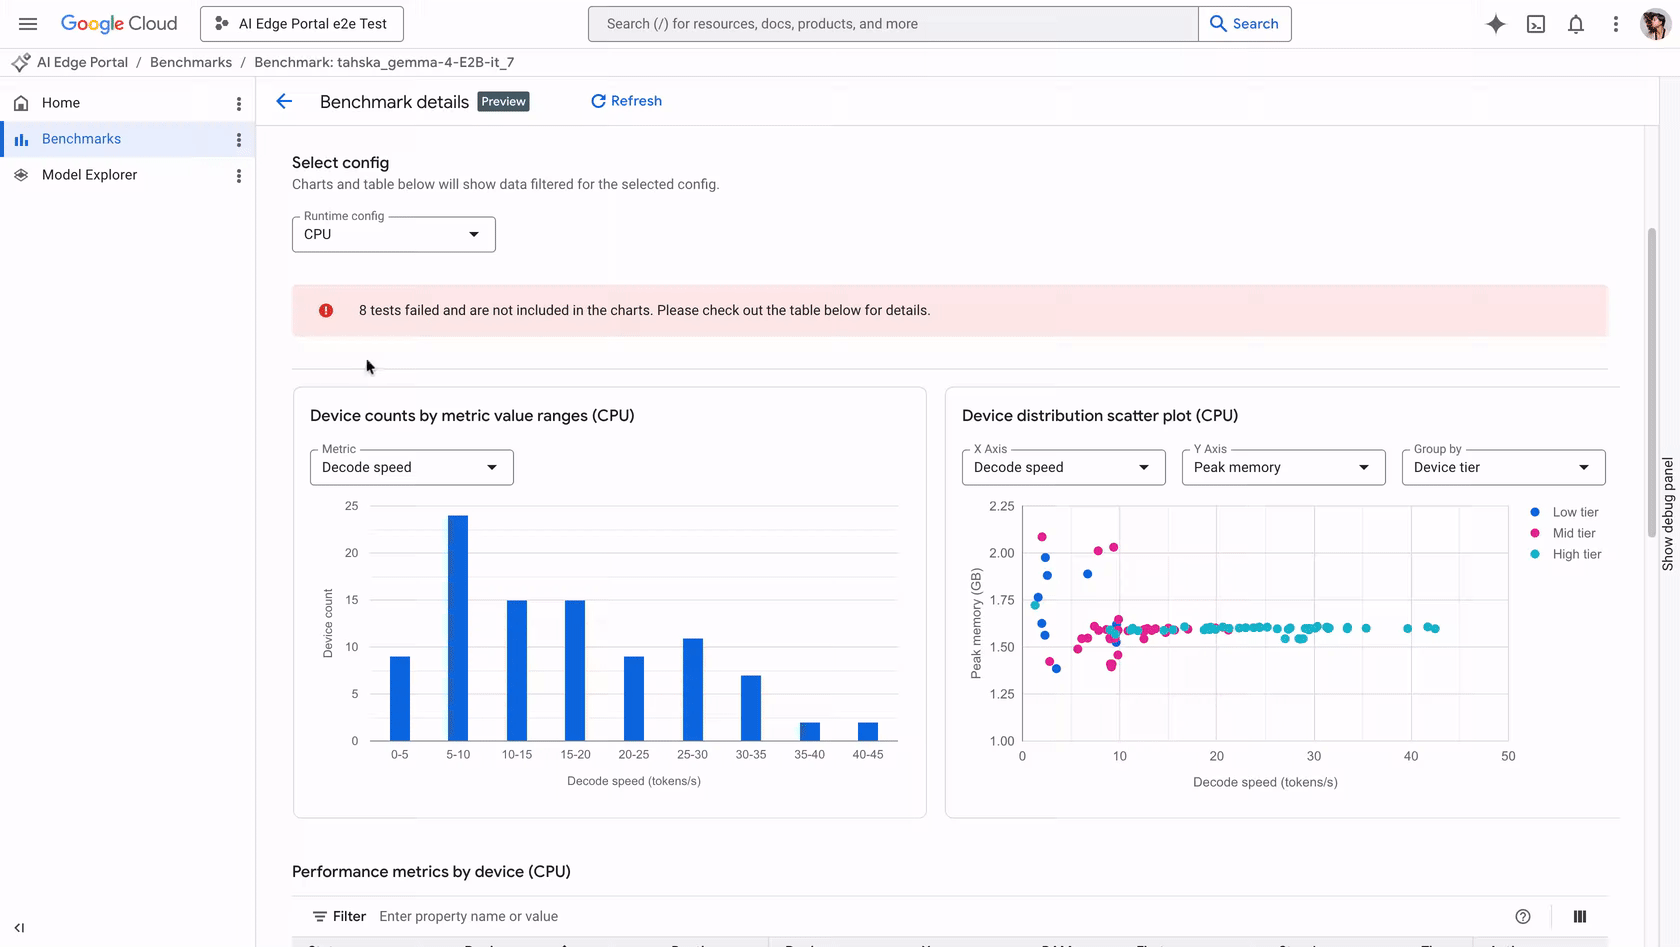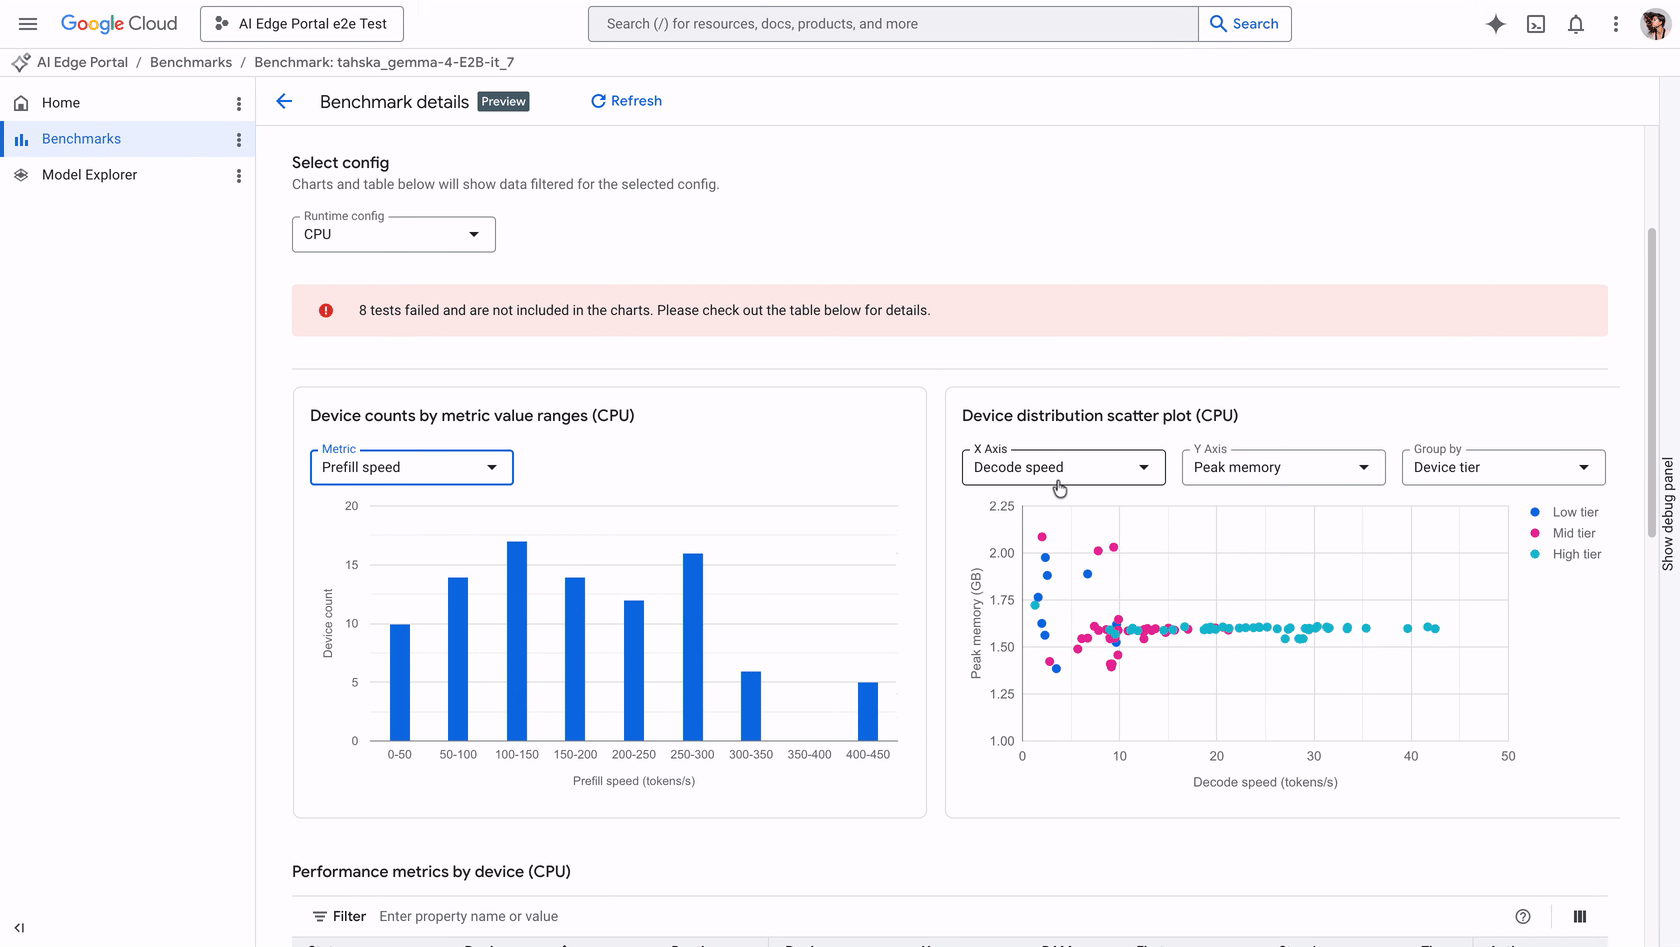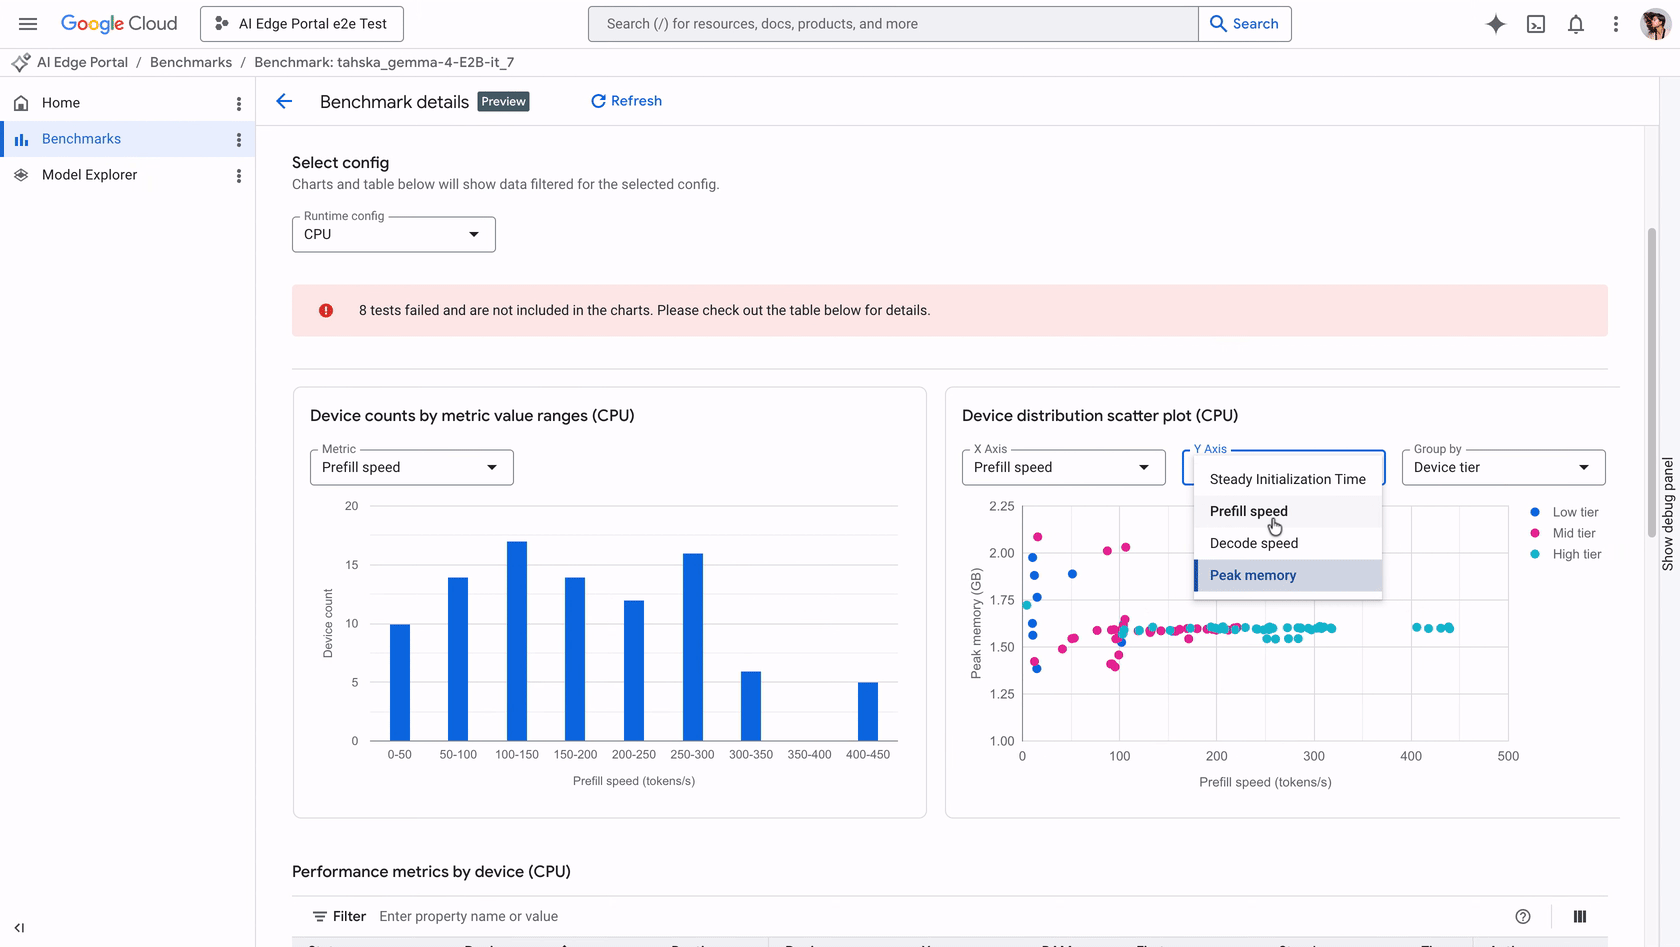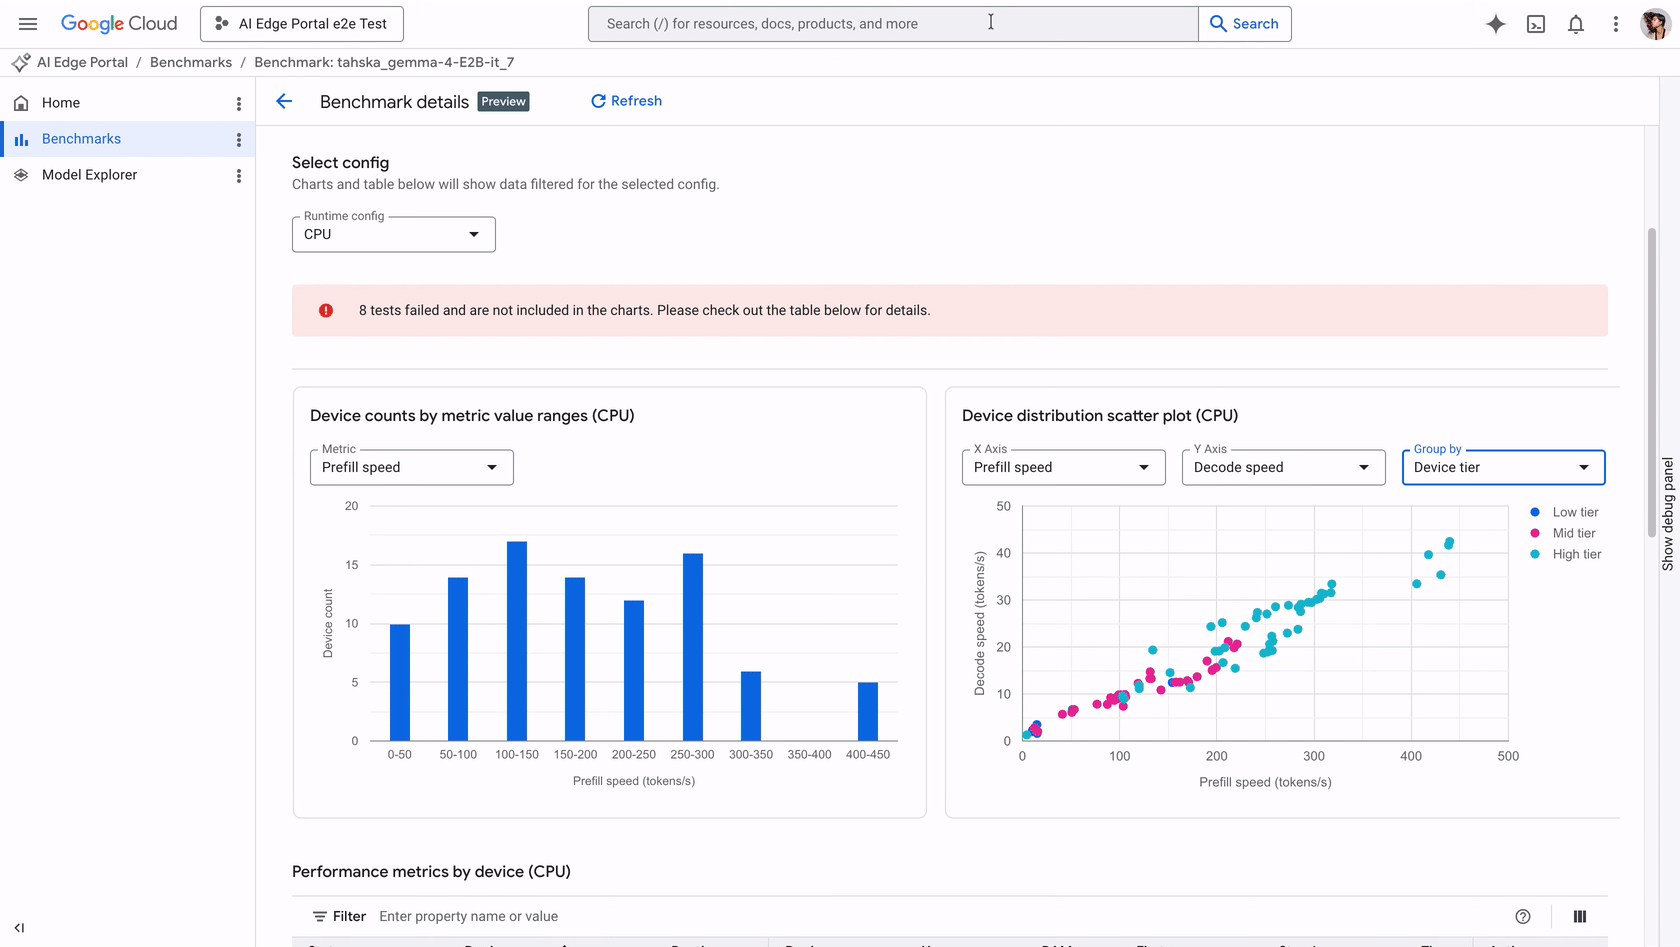
Benchmark and optimize LLMs on-device with AI Edge Portal
Google Cloud Blog · 8.5 分
Google AI Edge Portal新增LLM基准测试和调试功能,支持在120+ Android设备上优化模型性能,提供初始化时间、解码速度等关键指标分析及可视化调试工具。
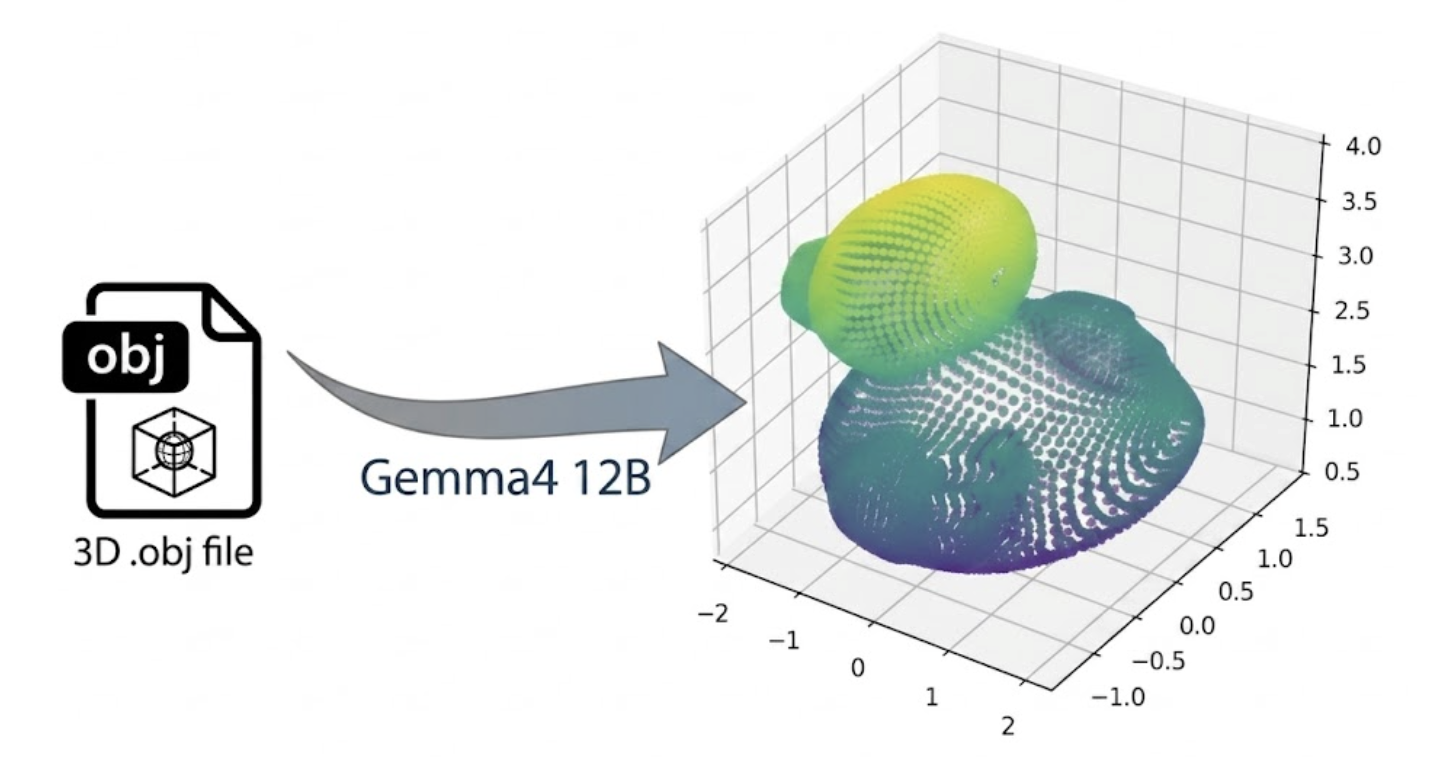
Bringing Gemma 4 12B to your Laptop: Unlocking Local, Agentic Workflows with Google AI Edge
Google Developers Blog · 8.2 分
Gemma 4 12B模型结合Google AI Edge栈已实现笔记本端本地运行,支持macOS上的代码生成、语音编辑及OpenAI兼容API服务。该组合使设备端Agent工作流成为可能,指令遵循质量提升超60%,且全程离线保障数据隐私。
已收录 5 条与 LiteRT-LM 相关的内容,按评分排序。
ADK for Kotlin 1.0发布,提供生产级AI代理开发工具,集成Android原生功能与VertexAI企业平台。
入选理由:ADK 1.0支持Android原生功能,包括LiteRT-LM、ML Kit(beta)和Firebase AI Logic。
Google AI Edge Portal introduces new LLM benchmarking and debugging capabilities, enabling performance optimization across over 120 Android devices with key metrics like initialization time and decode speed analysis, plus visualization tools.
入选理由:AI Edge Portal支持在120+ Android设备上测试LLM,提供初始化时间、预填速度等4项核心性能指标
Gemma 4 12B combined with Google AI Edge enables local execution on laptops, supporting code generation, voice editing, and OpenAI-compatible APIs on macOS. This setup facilitates on-device agentic workflows with a 60%+ quality boost in instruction following while ensuring offline privacy.
入选理由:Gemma 4 12B通过LiteRT-LM在消费级笔记本运行,支持本地Agent与多模态任务。
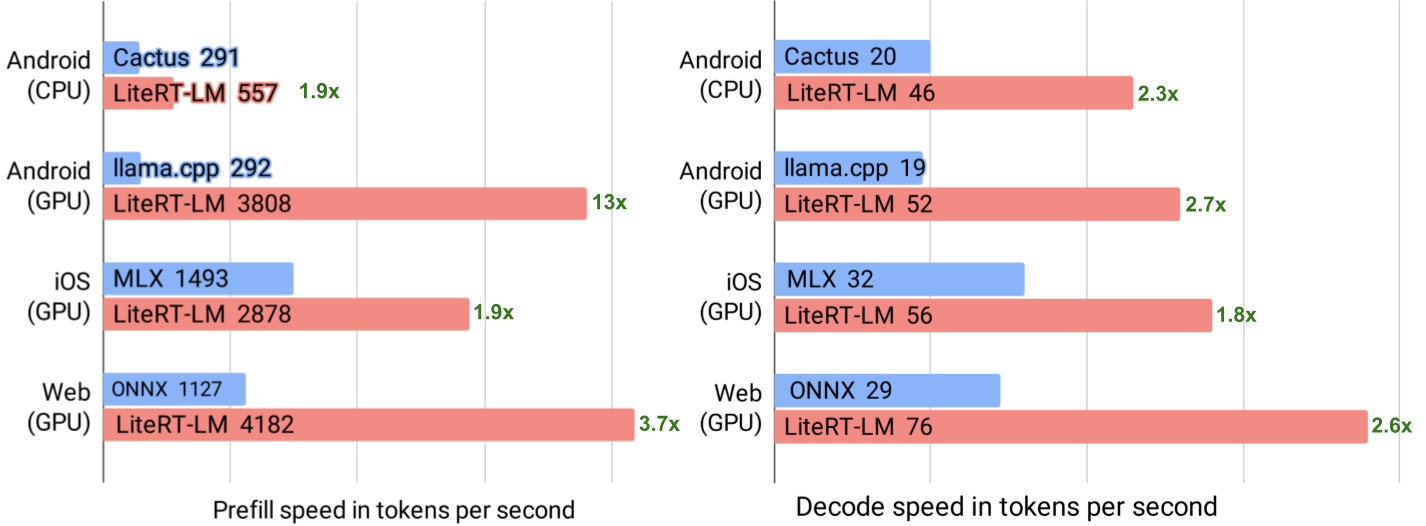
Google AI Edge introduces LiteRT-LM, an optimized inference engine for deploying Gemma 4 models on edge devices, supporting Android, iOS, and web platforms with GPU inference reaching 76 tokens/sec and Multi-Token Prediction delivering up to 2.2x speedup.
入选理由:LiteRT-LM 在 Android GPU (OpenCL) 上实现 52 tokens/sec 解码速度,iOS (Metal) 达 56 tokens/sec,WebGPU 在 MacBook Pro 上可达 76 tokens/sec
Google 提出 TLMs(Tiny Language Models)与 LiteRT-LM 框架,支持在边缘设备上高效部署轻量级 LLM 和自主 Agent,兼顾低延迟、隐私保护与离线能力。
入选理由:TLMs 是专为边缘设备优化的 sub-100M 参数 LLM,通过结构压缩与量化实现毫秒级推理。