The Model Factory Matters More Than the Model
Gradient Flow1320 字 (约 6 分钟)
85
模型工厂的定制化流程比模型本身更重要,持续预训练和后训练能显著提升特定任务表现。
入选理由:Thomson Reuters通过持续预训练将模型性能提升至行业领先水平
FeaturedArticle#模型定制#持续预训练#后训练#数据工程英文
模型
别名:Kimi
Cursor选型的代码理解模型
已跟踪 7 条高相关材料
最近变化
2026-10-21 · Thomson Reuters通过持续预训练将模型性能提升至行业领先水平
为什么值得关注
Kimi K2.5 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
The Model Factory Matters More Than the Model
Gradient Flow · 8.5 分
模型工厂的定制化流程比模型本身更重要,持续预训练和后训练能显著提升特定任务表现。
What I learned from companies training their own models
Gradient Flow · 8.5 分
企业自研模型时,持续预训练和模型工厂构建比单一模型优化更重要。多家企业通过混合训练策略实现领域知识深度适配。
America’s Open-Model Paradox
Sequoia Capital · 8.5 分
中国开源模型已占据西方AI公司训练栈核心位置,蒸馏技术加剧中美模型能力差距,西方需独立构建或接受滞后学习。
已收录 7 条与 Kimi K2.5 相关的内容,按评分排序。
模型工厂的定制化流程比模型本身更重要,持续预训练和后训练能显著提升特定任务表现。
入选理由:Thomson Reuters通过持续预训练将模型性能提升至行业领先水平
企业自研模型时,持续预训练和模型工厂构建比单一模型优化更重要。多家企业通过混合训练策略实现领域知识深度适配。
入选理由:持续预训练使模型领域知识提升3倍(C3 AI案例中从11%到60%)
中国开源模型正成为西方AI公司的重要依赖,但这也带来结构性风险。Qwen市场份额激增,蒸馏技术加剧中美模型差距。
入选理由:Qwen在2024年1月至2026年2月间占据69%的开源模型微调市场份额
中国开源模型已占据西方AI公司训练栈核心位置,蒸馏技术加剧中美模型能力差距,西方需独立构建或接受滞后学习。
入选理由:Qwen在2024-2026年占据69%西方公司模型微调市场份额
Fireworks AI tests show baseline models had 20% retry rates in browser agent tasks, while Kimi K2.5/GLM-5/MiniMax M2.5 achieved near-zero retries with stable latency, directly impacting production system costs/delays/reliability.
入选理由:基线模型在5次调用中约1次输出畸形,导致多步骤工作流重试
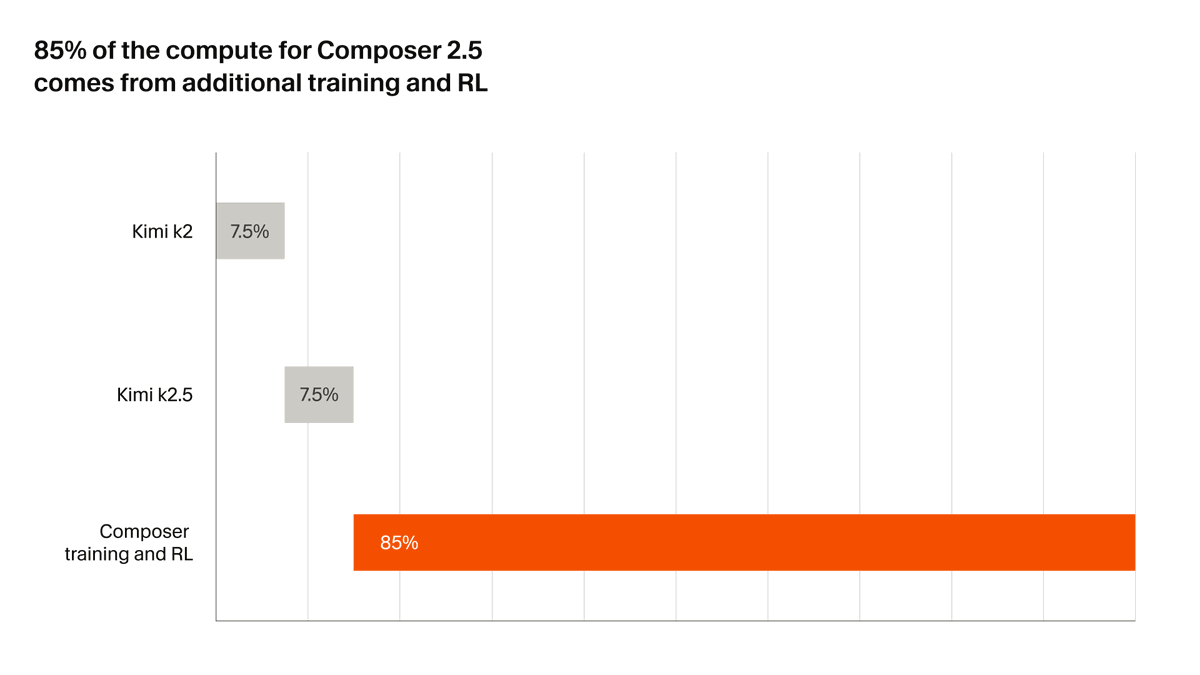
Cursor AI launched Composer 2.5 on the Kimi K2.5 base model, achieving 85% performance gains from reinforcement learning, with Fireworks AI providing the RL infrastructure for scalable deployment.
入选理由:Composer 2.5基于Kimi K2.5模型,性能显著提升,85%的算力增益来自强化学习(RL)。
Cursor's official Twitter account posted a brief statement announcing Composer 2.5 is built on the same open-source base as Composer 2, referencing Moonshot's Kimi K2.5, but provided no technical details or architectural explanations.
入选理由:Composer 2.5 与 Composer 2 共享同一开源代码基础