[AINews] Fable 5.2 retakes World #1 LLM spot as $ANT IPO roadshow begins
Anthropic的Claude Fable 5.2在性能和成本优化上取得进展,但每任务成本增加。
入选理由:Fable 5.2输入/输出价格降20%,但任务成本因更多测试用例增加
概念
别名:FrontierCode
评估代码生成能力的基准测试框架。
已跟踪 6 条高相关材料
最近变化
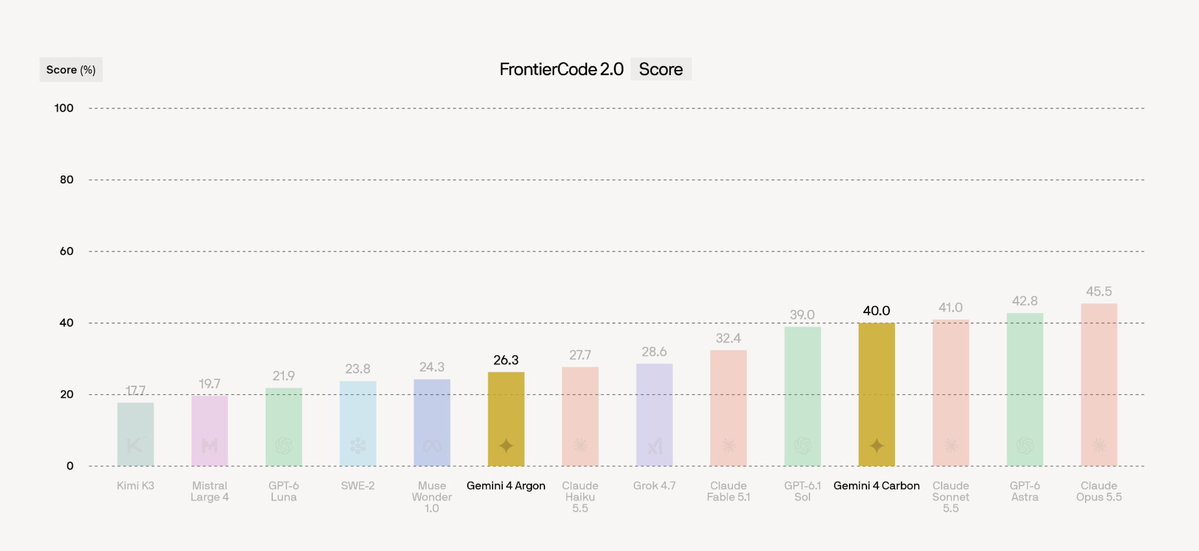
2026-11-10 · Gemini 4 Carbon在FrontierCode 2.0基准测试中得分40.0%
为什么值得关注
FrontierCode 2.0 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
[AINews] Fable 5.2 retakes World #1 LLM spot as $ANT IPO roadshow begins
Latent Space · 8.5 分
Anthropic的Claude Fable 5.2在性能和成本优化上取得进展,但每任务成本增加。
See the leaderboard: https://t.co/EKLSkeXQHg
Windsurf(@windsurf_ai) · 8.5 分
Kimi K3.1 Pro在FrontierCode 2.0测试中得分19.6,超越此前版本,但高努力值下仍低于Kimi K3。
We've evaluated Gemini 4 Carbon and Gemini 4 Argon on FrontierCode 2.0, our coding benchmark that me...
Cognition(@cognition_labs) · 8.5 分
Cognition在FrontierCode 2.0基准测试中显示Gemini 4 Carbon和Argon的性能与成本表现,但落后于部分竞品模型。
已收录 6 条与 FrontierCode 2.0 相关的内容,按评分排序。
Anthropic的Claude Fable 5.2在性能和成本优化上取得进展,但每任务成本增加。
入选理由:Fable 5.2输入/输出价格降20%,但任务成本因更多测试用例增加
Kimi K3.1 Pro在FrontierCode 2.0测试中得分19.6,超越此前版本,但高努力值下仍低于Kimi K3。
入选理由:Kimi K3.1 Pro在最大努力值下得分19.6,较Kimi K3的17.7有显著提升
Cognition在FrontierCode 2.0基准测试中显示Gemini 4 Carbon和Argon的性能与成本表现,但落后于部分竞品模型。
入选理由:Gemini 4 Carbon得分为40%,单任务成本$4.04,仅次于Claude Opus 5.5等模型
Gemini 4 Carbon模型在Devin工具链中上线,基准测试得分从26.3%提升至40.0%。
入选理由:Gemini 4 Carbon在FrontierCode 2.0基准测试中得分40.0%
Claude Fable 5.2在Devin平台发布,性能得分49.1,价格优化显著。
入选理由:Claude Fable 5.2在FrontierCode 2.0平台得分49.1,位列第一
Devin Desktop和CLI现已支持Gemini 4 Carbon模型,其在FrontierCode 2.0基准测试中得分40.0%,显著优于之前的Gemini 4 Argon。
入选理由:Gemini 4 Carbon在FrontierCode 2.0基准测试中得分40.0%