NEW: Meta released Muse Wonder (codenamed Watermelon), its new family of AI models, with scores that...
Meta发布的新AI模型Muse Wonder在多个基准测试中表现优异,尤其在法律和编码任务中领先。
入选理由:Wonder Full在Artificial Analysis指数中得分56,仅次于Claude Opus 5.5的58。
概念
别名:DeepSWE benchmark
编码任务测试基准。
已跟踪 20 条高相关材料
最近变化
2026-10-12 · Wonder Full在Artificial Analysis指数中得分56,仅次于Claude Opus 5.5的58。
为什么值得关注
DeepSWE 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
NEW: Meta released Muse Wonder (codenamed Watermelon), its new family of AI models, with scores that...
The Rundown AI(@TheRundownAI) · 8.5 分
Meta发布的新AI模型Muse Wonder在多个基准测试中表现优异,尤其在法律和编码任务中领先。
Mistral Large 4: "Le Chonk"
Hacker News Best · 8.5 分
Mistral Large 4发布,1万亿参数多模态模型在欧洲自主训练,性能超越同类开源模型并挑战闭源模型。
Many assume that agent spend goes toward output tokens. When we ran DeepSWE on Astra vs. DeepSeek V...
Fireworks AI(@FireworksAI_HQ) · 8.5 分
DeepSeek V4.1-Flash在DeepSWE基准测试中以1/15的成本实现与GPT-6 Astra相当的性能,输入token占比达174:1且缓存命中率高达99.6%。
已收录 20 条与 DeepSWE 相关的内容,按评分排序。
Meta发布的新AI模型Muse Wonder在多个基准测试中表现优异,尤其在法律和编码任务中领先。
入选理由:Wonder Full在Artificial Analysis指数中得分56,仅次于Claude Opus 5.5的58。
Mistral Large 4发布,1万亿参数多模态模型在欧洲自主训练,性能超越同类开源模型并挑战闭源模型。
入选理由:Mistral Large 4拥有1万亿参数,490亿活跃参数,是目前参数量最大的开源模型。
DeepSeek V4.1-Flash在DeepSWE基准测试中以1/15的成本实现与GPT-6 Astra相当的性能,输入token占比达174:1且缓存命中率高达99.6%。
入选理由:输入token数量是输出的174倍,占成本计算的60%。
GLM-5.3在DeepSWE基准测试中成本仅为Claude Fable 5的1/5,且在多尝试指标上表现更优。
入选理由:GLM-5.3每任务成本为$3.99,Claude Fable 5为$21.63,成本差距达5.4倍。
GLM-5.3在多次尝试下表现优于GPT-5.6 Sol,且成本更低,但单次尝试中GPT-5.6 Sol稍胜一筹。组合使用可覆盖106/113任务,性价比达85.9%。
入选理由:GLM-5.3单次尝试成本3.99美元,解决率69.0%,GPT-5.6 Sol成本8.37美元,解决率72.7%
GLM-5.3 Flash以1/17成本解决15倍任务,首次尝试性能落后5.6%但多次重试后差距缩小至2.6%。
入选理由:GLM-5.3 Flash成本为GLM-5.3的1/17,但每100美元解决任务数是其15倍。
DeepSeek-V4 Flash 0731成本仅为GPT-5.6 Luna的1/6,但组合使用时在准确率和成本上均优于单独使用Luna。
入选理由:GPT-5.6 Luna单次任务准确率67.2%,DeepSeek-V4 Flash为53.3%,但后者成本仅0.10美元/任务。
组合使用DeepSeek V4 Pro 0813和Claude Fable 5可解决82.7%的DeepSWE任务,成本仅8.28美元,比单独使用Claude节省62%费用。
入选理由:DeepSeek V4 Pro 0813首次尝试解决62.8%任务,成本仅0.24美元/次
DeepSeek V4 Pro 0813成本仅为GPT-5.6 Sol的1/35,但多次尝试后表现更优,适合预算有限且允许重试的任务。
入选理由:DeepSeek V4 Pro 0813每轮成本0.24美元,GPT-5.6 Sol为8.37美元,价格差距达35倍。
Google DeepMind 推出 Gemini 3.6 Flash、3.5 Flash-Lite 和 3.5 Flash Cyber,分别在效率、速度和网络安全应用方面有显著提升。
入选理由:Gemini 3.6 Flash 相比 3.5 Flash 输出令牌减少 17%,部分基准测试提升达 65%。
Kimi K3在DeepSWE基准测试中以1/3成本超越Claude Fable 5,多次尝试后性能反超,但后者可靠性更高。
入选理由:Kimi K3单次任务成本仅4.65美元,为Claude Fable 5的1/3
Poolside AI的Laguna S2.1是当前在本地运行的最佳编码模型之一,其在Terminal-Bench 2.1和DeepSWE基准测试中表现优异。
入选理由:Laguna S2.1在Terminal-Bench 2.1得分70.2,超越5-25倍参数量的模型
Kimi K3在软件工程任务中性能与Claude Fable 5相当,但价格仅为后者35%。
入选理由:Kimi K3价格仅为Claude Fable 5的35%但性能相同
DeepSWE 是一个全新的编程基准测试,涵盖多种语言和真实世界复杂度,参考解决方案平均需要修改 668 行代码。
入选理由:DeepSWE 是一个全新的编程基准测试,涵盖多种语言和真实世界复杂度。
AI模型在达到高准确性后可能引发人类信任偏差,80%的用户会跟随其错误建议。
入选理由:AI自信错误时用户跟随率高达80%,远高于正确时的92.7%
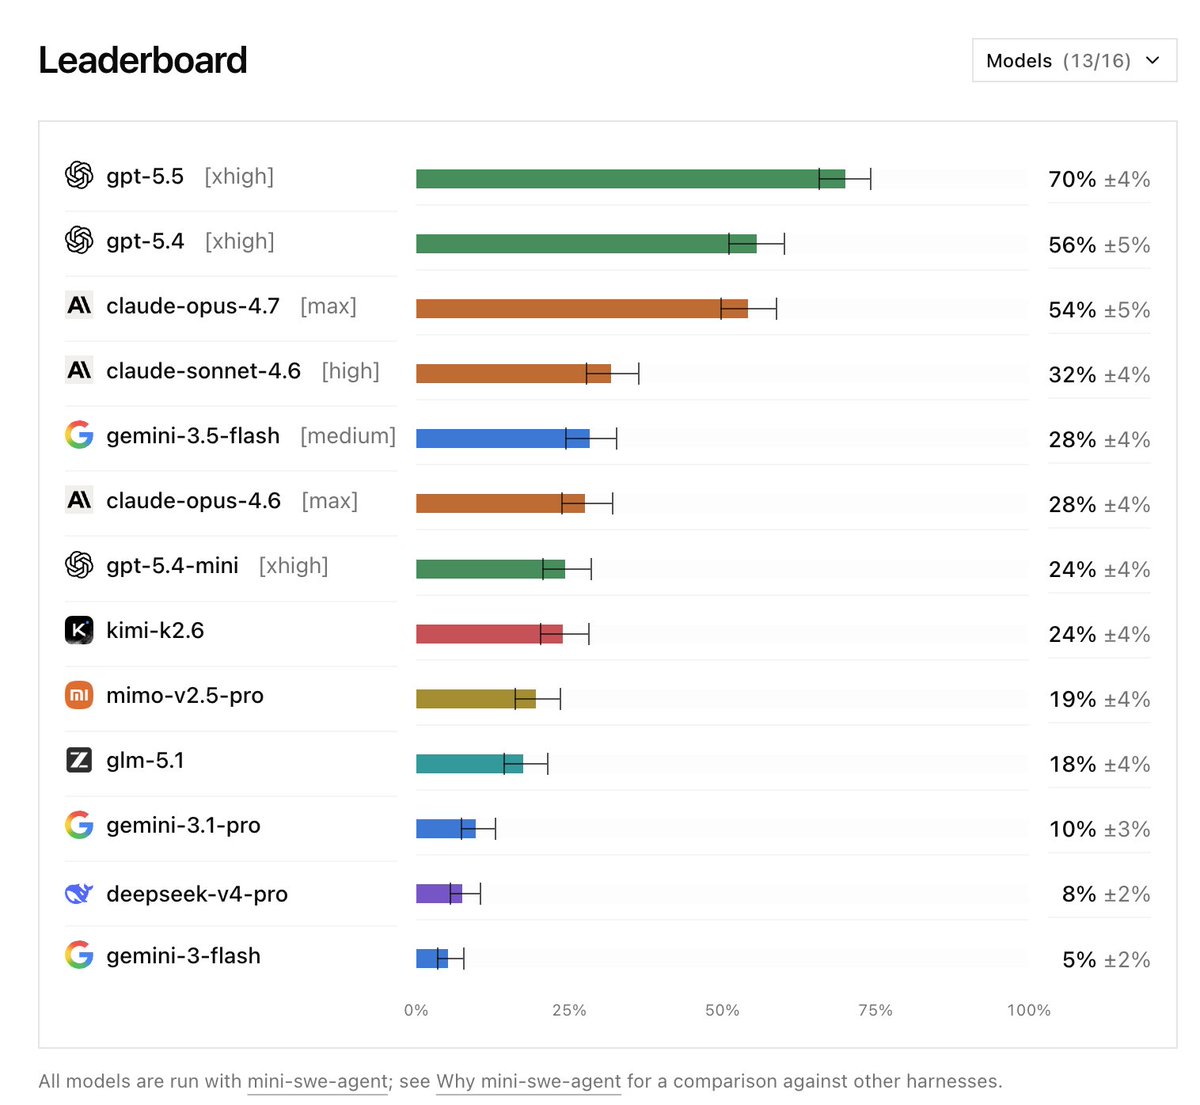
Claude Opus 4.8 is Anthropic’s rapid revision of the controversial 4.7 model, prioritizing improved ambiguity handling to restore the user-friendly ‘vibes’ of 4.6; though it outperforms GPT-4.5 on official benchmarks, real-world engineering benchmark DeepSWE shows GPT-4.5 currently leads—and 4.8 hasn’t been tested yet.
入选理由:Opus 4.8通过增强歧义理解能力修正了4.7过度字面化的问题,目标是恢复4.6版本广受好评的‘vibes’体验。
AI Engineer World's Fair 2026的Agentic Engineering Track展示AI工程领域最新动态,涵盖代码生成、多智能体协作等方向,但缺乏技术细节。
入选理由:DeepSWE数据集由@shiqyy和Datacurve团队开发
GLM-5.2 在 DeepSWE 排名第一,但文章信息密度低,缺乏技术深度。
入选理由:GLM-5.2 在 DeepSWE 排名第一,pass@1 得分为 44%。
Fable在设计和创意任务中表现优异,但在软件工程任务中性价比不高。
入选理由:Fable在设计和创意任务中表现突出。
DeepSWE’s evaluation shows Opus 4.8 outperforms 4.7 in performance, cost, and efficiency, yet still lags far behind GPT-5.5; the author continues using cheaper 4.6 without deep testing of 4.8 or 5.5, and expresses skepticism toward benchmarks, preferring real user feedback from social media.
入选理由:Opus 4.8 性能强于 4.7,同时具备更低推理成本与更高效率,但未达 GPT-5.5 水平。