Don’t be fooled—LLMs don’t reason
MIT Technology Review1566 字 (约 7 分钟)
85
当前大语言模型(LLMs)缺乏真正的推理能力,AlphaGo的成功依赖于搜索机制而非直觉。
入选理由:AlphaGo通过搜索机制评估了数千种未来棋局,而非单纯依赖直觉。
FeaturedArticle#AI#AlphaGo#推理能力#LLMs英文
人物
别名:Kahneman
诺贝尔经济学奖得主,提出双系统思维理论。
已跟踪 4 条高相关材料
最近变化
2026-10-02 · AlphaGo通过搜索机制评估了数千种未来棋局,而非单纯依赖直觉。
为什么值得关注
Daniel Kahneman 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Don’t be fooled—LLMs don’t reason
MIT Technology Review · 8.5 分
当前大语言模型(LLMs)缺乏真正的推理能力,AlphaGo的成功依赖于搜索机制而非直觉。
Jev - The Ultimate Classification Model?
Sam Witteveen · 8.5 分
Jev模型通过专注分类任务而非推理,实现零延迟响应,输出令牌免费,挑战传统大模型范式。
Why We Think
Lil'Log · 8.5 分
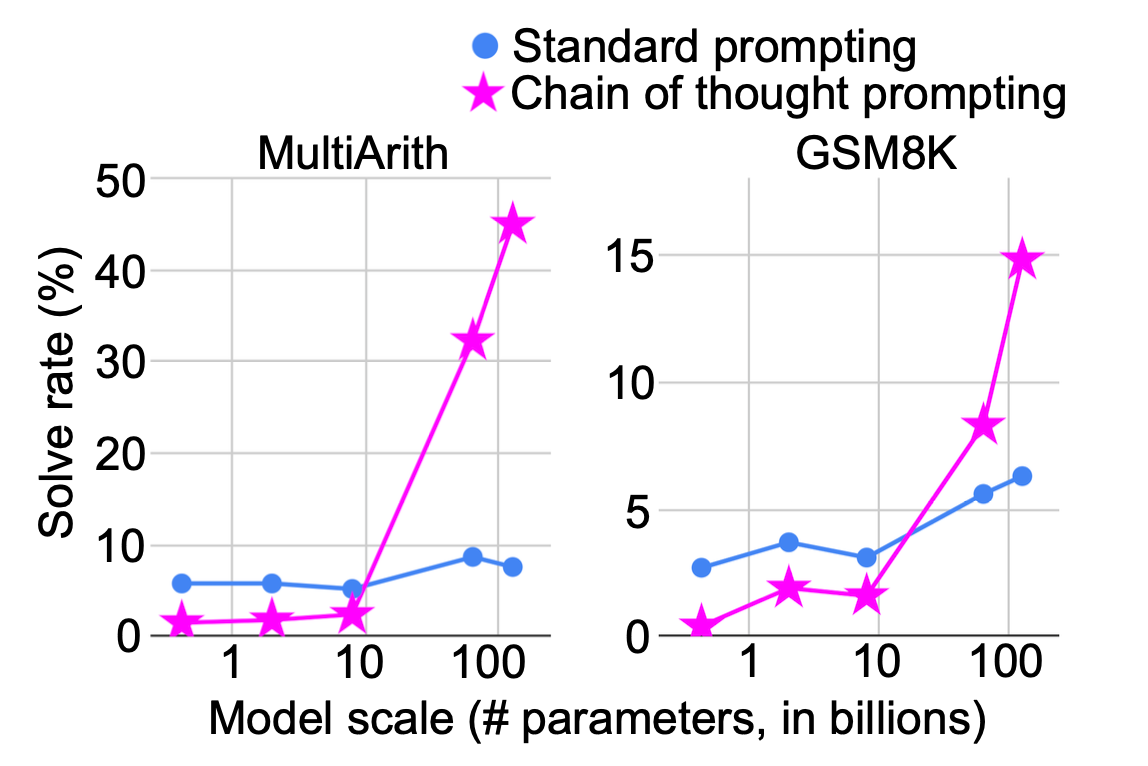
文章探讨了测试时计算(test-time compute)和链式思维(CoT)对模型性能的提升机制,以及其与人类思维模式的相似性。
已收录 4 条与 Daniel Kahneman 相关的内容,按评分排序。
当前大语言模型(LLMs)缺乏真正的推理能力,AlphaGo的成功依赖于搜索机制而非直觉。
入选理由:AlphaGo通过搜索机制评估了数千种未来棋局,而非单纯依赖直觉。
Jev模型通过专注分类任务而非推理,实现零延迟响应,输出令牌免费,挑战传统大模型范式。
入选理由:Jev模型专为分类任务设计,无需长链推理,响应时间缩短至毫秒级
The article explores the mechanisms of test-time compute and chain-of-thought (CoT) in improving model performance.
入选理由:CoT使模型能根据问题难度动态调整计算量
ThinkingCap模型通过分步验证机制提升本地编码能力,其长链推理能力是O1模型后的重要突破。
入选理由:O1模型后模型能力提升主要依赖长链推理机制