实测Gemini 4 Argon:知识工作强劲但体验糟糕,卡兹克称难撼Claude Opus 5.5与GPT-6 Astra
Gemini 4 Argon在知识任务表现强劲,但中文写作体验差,不建议购买Ultra版本。
入选理由:Gemini 4 Argon在Vals Index得分68.9,但CUA-bench拒绝率4.83%。
概念
别名:CUA
AI模型拒绝率测试基准,用于评估对话能力。
已跟踪 2 条高相关材料
最近变化
2026-10-13 · Gemini 4 Argon在Vals Index得分68.9,但CUA-bench拒绝率4.83%。
为什么值得关注
CUA-bench 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
实测Gemini 4 Argon:知识工作强劲但体验糟糕,卡兹克称难撼Claude Opus 5.5与GPT-6 Astra
AI HOT 精选 · 8.5 分
Gemini 4 Argon在知识任务表现强劲,但中文写作体验差,不建议购买Ultra版本。
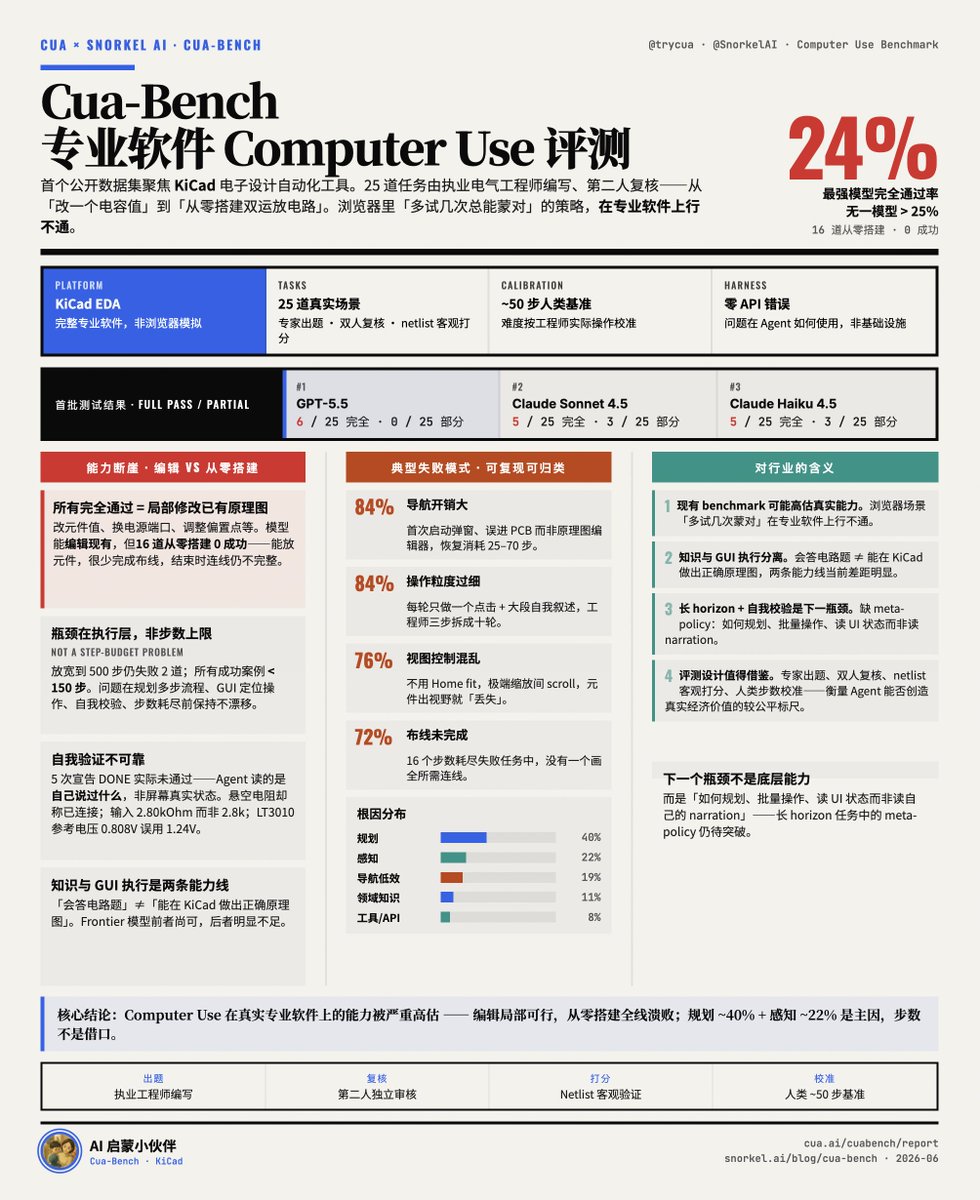
Cua 和 Snorkel AI 联合发布「Cua-Bench」:评测 Agent 在专业软件上的 Computer Use 能力 @trycua @SnorkelAI Cua-Bench 首个...
meng shao(@shao__meng) · 8.5 分
Cua-Bench 是首个评测 Agent 在专业软件上执行任务能力的基准,测试显示当前模型在复杂 GUI 操作和任务规划上存在明显短板。
已收录 2 条与 CUA-bench 相关的内容,按评分排序。
Gemini 4 Argon在知识任务表现强劲,但中文写作体验差,不建议购买Ultra版本。
入选理由:Gemini 4 Argon在Vals Index得分68.9,但CUA-bench拒绝率4.83%。
Cua-Bench 是首个评测 Agent 在专业软件上执行任务能力的基准,测试显示当前模型在复杂 GUI 操作和任务规划上存在明显短板。
入选理由:当前最强模型 GPT-5.5 在 Cua-Bench 上仅完成 6/25 任务,完全通过率仅 24%。