Hugging Face Journal Club: Training AI Scientists to Replicate Research
Hugging Face6179 字 (约 25 分钟)
85
Faraday模型通过RL训练结合CodeX工具,可复现科学实验结果并超越Claude等大模型。
入选理由:Quen 27B模型通过RL训练后可复现科学图表
FeaturedVideo#AI模型训练#科学复现#CodeX工具#RL训练中英混合
模型
别名:BERT模型
基于Transformer的预训练语言模型
已跟踪 8 条高相关材料
最近变化
2026-09-20 · Jev模型允许本地运行且权重开放,但禁止基准测试对比
为什么值得关注
BERT 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Hugging Face Journal Club: Training AI Scientists to Replicate Research
Hugging Face · 8.5 分
Faraday模型通过RL训练结合CodeX工具,可复现科学实验结果并超越Claude等大模型。
When Unlearning Is Free: Leveraging Low Influence Points to Reduce Computational Costs
Apple Machine Learning Research · 8.5 分
苹果提出通过识别低影响数据点实现高效模型遗忘,可减少50%计算成本。
🔬ESMFold2: The Bitter Lesson is Coming for Proteins - Alex Rives, BioHub
Latent Space · 8.5 分
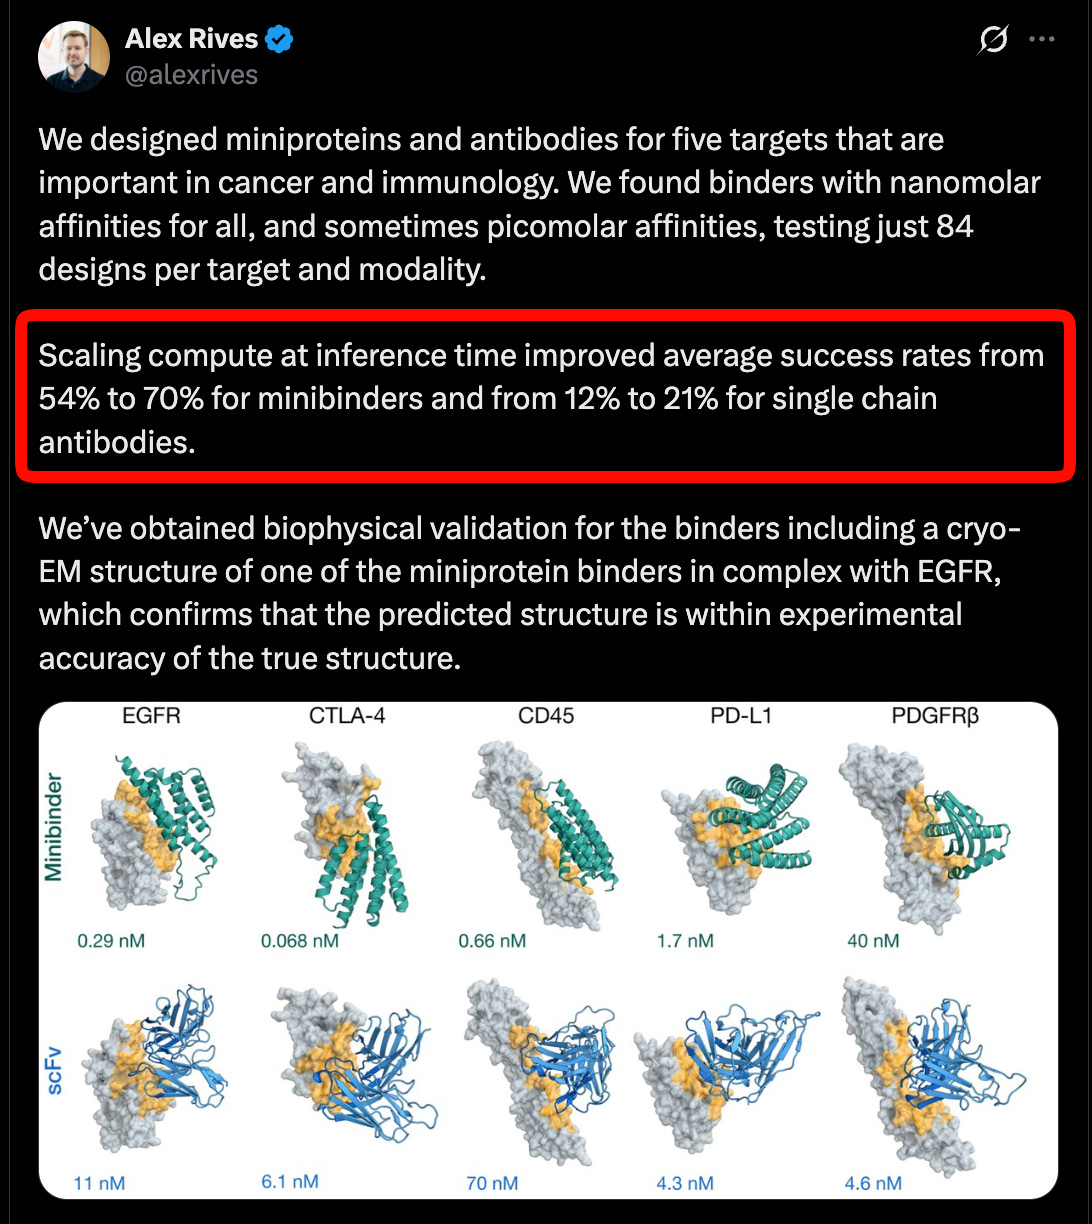
BioHub 发布 ESMFold2,展示通用语言模型在蛋白质折叠中的强大能力,挑战专有模型如 AlphaFold3。
已收录 8 条与 BERT 相关的内容,按评分排序。
Faraday模型通过RL训练结合CodeX工具,可复现科学实验结果并超越Claude等大模型。
入选理由:Quen 27B模型通过RL训练后可复现科学图表
苹果提出通过识别低影响数据点实现高效模型遗忘,可减少50%计算成本。
入选理由:使用影响函数分析可识别对模型输出影响最小的训练数据子集
BioHub 发布 ESMFold2,展示通用语言模型在蛋白质折叠中的强大能力,挑战专有模型如 AlphaFold3。
入选理由:ESMFold2 在蛋白质相互作用预测中表现优异,尤其是抗体。
从TF-IDF到Transformer,文章通过四个阶段展示了语义搜索的演变过程,揭示了现代系统如何从手动设计特征转向直接从数据学习抽象意义。
入选理由:TF-IDF结合手工特征提供了透明的排名系统。
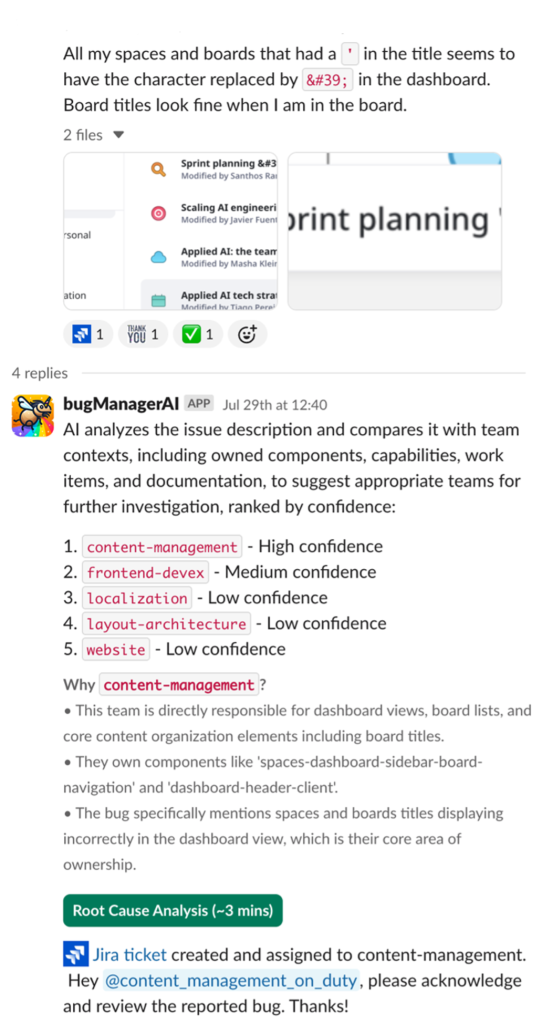
Miro through combining Amazon Bedrock's RAG technology achieves BugManager, boosting software error routing accuracy by six times and reducing resolution time from days to hours.
入选理由:Miro利用Amazon Bedrock的RAG技术,使错误路由团队重分配减少六倍。
The article proposes using prompt compression to reduce agentic loop costs, providing specific implementation methods and experimental data.
入选理由:提示压缩可减少代理循环成本30%
Jev模型引发开源社区热潮,但其技术细节和实际效果仍存争议。
入选理由:Jev模型允许本地运行且权重开放,但禁止基准测试对比
RoBERTa模型凭借高精度的填空预测能力,适用于文本补全和搜索,已获1100万次下载。
入选理由:RoBERTa在填空任务中比BERT更准确,适用于文本补全