T
traeai
Sign in

产品

Apache Iceberg

别名:iceberg

高性能分析型数据格式。

已跟踪 9 条高相关材料

TraeAI 观察

相关材料

已收录 9 条与 Apache Iceberg 相关的内容,按评分排序。

Accelerating data lakes: Optimizing Apache Iceberg and Spark with gcs-analytics-core

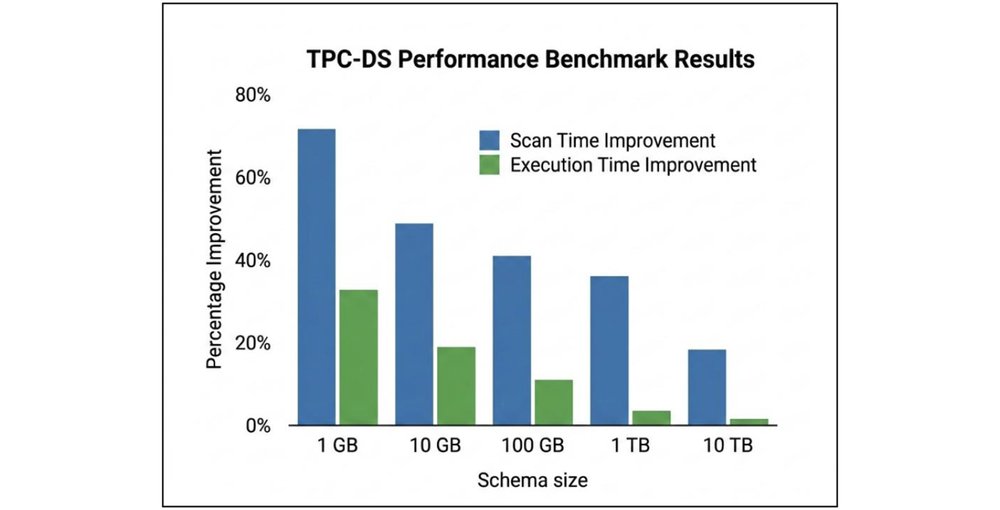
Google Cloud announces gcs-analytics-core, an open-source Java library designed to optimize Apache Iceberg and Spark workloads on Google Cloud Storage, achieving significant performance improvements through parallel I/O and smart Parquet prefetching.

入选理由:gcs-analytics-core 是一个开源 Java 库,用于优化 GCS 上的 Apache Iceberg 和 Spark 工作负载。

FeaturedArticle#Apache Iceberg#Apache Spark#GCS#Data Lake#Performance Optimization英文
Databricks 图标

Databricks vs. Oracle in 2026

Databricks2517 字 (约 11 分钟)
85

Databricks的湖仓一体架构在开放性、统一平台和成本效益上全面优于Oracle传统数据仓库,尤其适合AI时代需求。

入选理由:Databricks采用Delta Lake和Iceberg开放格式,避免数据锁定,Oracle依赖专有格式。

FeaturedArticle#Databricks#Oracle#数据仓库#湖仓一体#AI平台英文
Databricks 图标

What makes a catalog open? Unity Catalog Advances the Open Lakehouse

Databricks1751 字 (约 8 分钟)
85

Unity Catalog通过支持Apache Iceberg REST catalog spec实现数据可移植性,允许在不同目录间移动表而无需复制数据。

入选理由:Unity Catalog支持Apache Iceberg的REGISTER和UNREGISTER操作,实现零数据复制迁移

FeaturedArticle#Databricks#Apache Iceberg#Lakehouse#数据可移植性#云存储英文
Databricks 图标

Databricks在Delta Lake和Apache Iceberg上实现多语句事务,推动湖仓一体架构发展,提升数据仓库工作负载的效率和一致性。

入选理由:多语句事务减少数据复制和治理碎片化,降低运营成本30%以上

FeaturedArticle#Delta Lake#Apache Iceberg#湖仓一体#数据仓库#事务处理英文
Managed Apache Iceberg at scale: How Spanner powers Lakehouse runtime catalog

Managed Apache Iceberg at scale: How Spanner powers Lakehouse runtime catalog

Google Cloud Blog1600 字 (约 7 分钟)
85

Google Cloud 使用 Spanner 构建了可扩展的 Lakehouse 运行时目录,解决了 Apache Iceberg 在大规模场景下的原子提交、高可用性和数据库扩展等核心挑战。

入选理由:Spanner 支持每秒数百万次的原子提交,保障 Iceberg 表的 ACID 事务。

FeaturedArticle#Apache Iceberg#Lakehouse#Spanner#Google Cloud#数据工程英文
Databricks 图标

Databricks推出REGISTER和UNREGISTER API,通过元数据转移实现数据目录无损迁移,解决湖仓架构中的目录锁定问题。

入选理由:REGISTER通过元数据指针转移实现表的跨目录迁移,无需复制数据文件

FeaturedArticle#湖仓一体#数据目录#Apache Iceberg#Databricks英文
How MAPFRE USA modernized fraud claims with Amazon EMR Serverless

How MAPFRE USA modernized fraud claims with Amazon EMR Serverless

AWS Architecture Blog1679 字 (约 7 分钟)
85

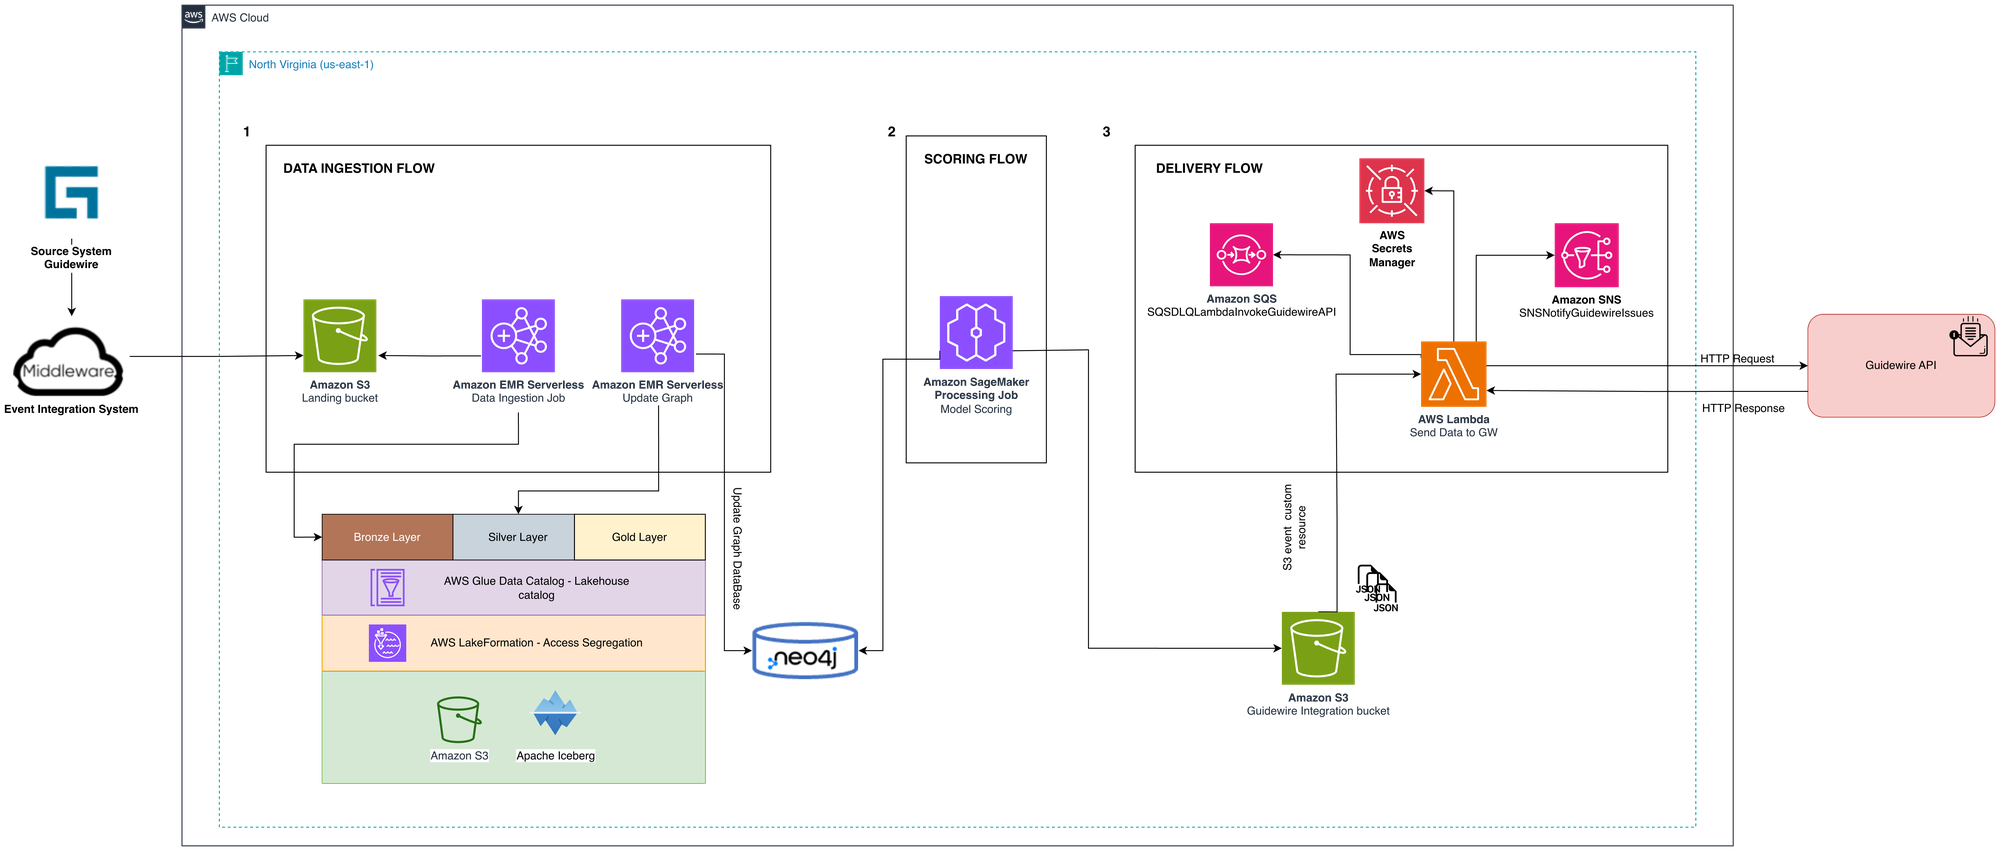
MAPFRE USA通过AWS EMR Serverless和Neo4j结合图分析与机器学习,提升欺诈检测效率,节省超500万美元。

入选理由:结合图分析与机器学习模型,欺诈检测准确率提升30%以上

FeaturedArticle#AWS#保险欺诈#机器学习#数据平台#Neo4j英文
Context intelligence for your data and AI agents at scale

Context intelligence for your data and AI agents at scale

AWS Machine Learning Blog1617 字 (约 7 分钟)
85

AWS 推出 AWS Context 服务,通过知识图谱技术整合企业数据,提升 AI 代理的决策能力。

入选理由:AWS Context 通过知识图谱自动映射数据关系,提升 AI 代理的上下文理解能力。

FeaturedArticle#AWS#AI#知识图谱#数据治理英文
Article: The Schema Proliferation Problem in Kafka and Flink Pipelines: How to Solve It

通过使用基于判别器的模式来合并事件模式,可以解决Kafka和Flink管道中的模式泛滥问题,从而简化查询和维护。

入选理由:一对一事件到模式映射导致复杂性增加,应使用判别器字段合并模式。

FeaturedArticle#Kafka#Flink#Schema Proliferation#Data Engineering中文

跨材料问答 · Apache Iceberg

回答基于:Apache Iceberg 相关 9 条材料
    0 / 500

    AI may generate inaccurate information. Please verify important content.