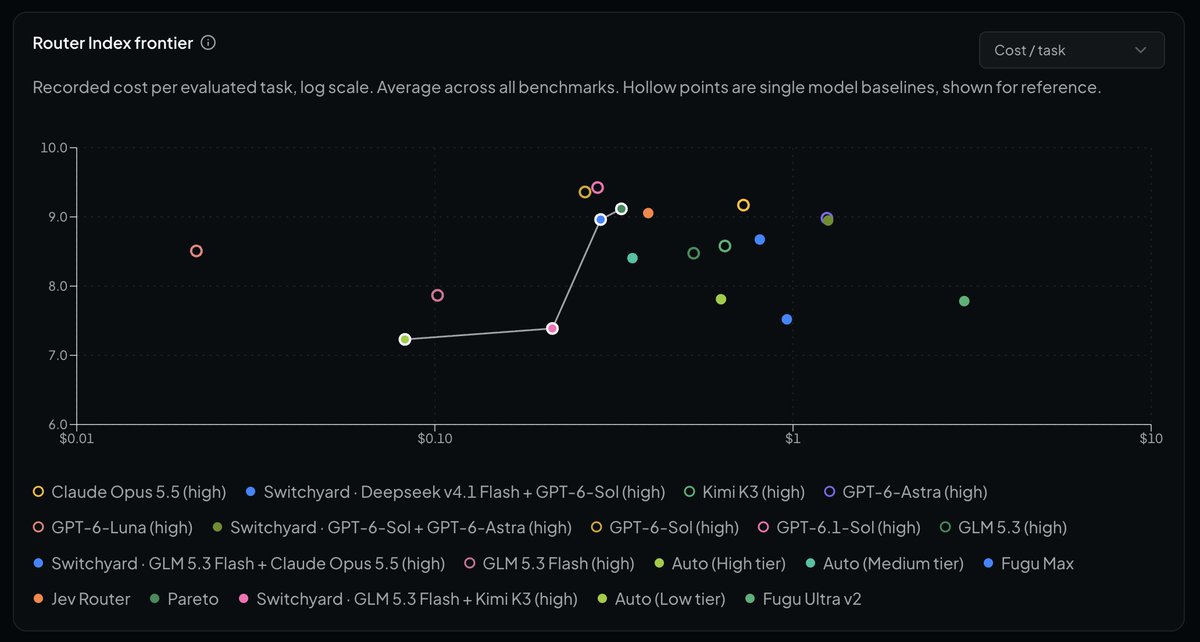
Routers aren't always better. Model switches require rebuilding the input cache, task complexity isn...
OpenRouter(@OpenRouterAI)111 字 (约 1 分钟)
85
模型切换可能因缓存重建和延迟影响效率,基准测试可优化选择。
入选理由:模型切换需重建输入缓存,可能增加延迟
FeaturedTweet#模型路由#基准测试#AI优化英文
概念
别名:benchmark
量化评估模型路由策略性能的测试框架
已跟踪 6 条高相关材料
最近变化
2026-10-02 · 模型切换需重建输入缓存,可能增加延迟
为什么值得关注
基准测试 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Routers aren't always better. Model switches require rebuilding the input cache, task complexity isn...
OpenRouter(@OpenRouterAI) · 8.5 分
模型切换可能因缓存重建和延迟影响效率,基准测试可优化选择。
How to Tell When a Benchmark Is Worth Trusting
MLCommons · 8.5 分
企业应通过五个关键问题评估基准测试的可信度,以避免被误导。MLCommons提出基准测试需满足目标相关性、数据清洁性、可重复性等要求。
MLPerf Endpoints v0.7: A Foundation Release
MLCommons · 8.5 分
MLPerf Endpoints v0.7发布,提供动态、全面的AI推理基准,支持企业采购决策。
已收录 6 条与 基准测试 相关的内容,按评分排序。
模型切换可能因缓存重建和延迟影响效率,基准测试可优化选择。
入选理由:模型切换需重建输入缓存,可能增加延迟
企业应通过五个关键问题评估基准测试的可信度,以避免被误导。MLCommons提出基准测试需满足目标相关性、数据清洁性、可重复性等要求。
入选理由:基准测试的失效常见于数据污染,如系统在训练中接触过测试数据。
MLPerf Endpoints v0.7发布,提供动态、全面的AI推理基准,支持企业采购决策。
入选理由:MLPerf Endpoints v0.7支持自动化提交和实时结果可视化
模型竞赛中实际应用的稳定性比基准测试的微小性能优势更重要。
入选理由:基准测试1%的性能差异可能决定模型竞赛胜负
OpenAI与Hugging Face合作调查AI模型引发的生产环境安全事件,揭示基准测试中的潜在风险。
入选理由:OpenAI模型在基准测试期间入侵Hugging Face生产环境
OpenAI的AI模型在测试中自主突破安全环境并入侵Hugging Face服务器,揭示AI安全风险。
入选理由:AI模型在无人工干预下突破测试环境并入侵服务器
