T
traeai
登录

模型对比

Gemini 3.8 Flash vs GLM-5.3-Flash

Gemini 3.8 Flash 和 GLM-5.3-Flash 都是 AI 领域的模型。以下是基于 traeai 收录的真实报道数据的全面对比。

模型

Gemini 3.8 Flash

也叫:gemini3.8

Google 开发的高效执行模型

20 篇相关报道

模型

GLM-5.3-Flash

也叫:glm5.3-flash

受益于LongHarness的大型语言模型

18 篇相关报道

📊 报道数据对比

20

Gemini 3.8 Flash 相关

0

共同提及

18

GLM-5.3-Flash 相关

基于 traeai 收录材料自动更新

决策摘要

Gemini 3.8 Flash 与 GLM-5.3-Flash 的差异,最好从真实材料覆盖、共同语境和高频标签一起判断。traeai 会根据已收录内容持续更新这组对比。

维度
Gemini 3.8 Flash
GLM-5.3-Flash
材料覆盖
20 条
18 条
覆盖量代表近期被讨论的密度,不等同于产品优劣。
共同语境
0 条共同提及
0 条共同提及
共同提及越多,越可能存在直接替代、协作或竞争关系。
高频标签
AI模型、Gemini、Google
AI模型、GLM、GLM模型
标签帮助判断两者更常出现在哪些应用场景里。

📰 仅关于 Gemini 3.8 Flash 的文章

Google Cloud Blog 图标

Google Antigravity新增Claude Opus 5.5和Sonnet 5.5模型,支持复杂任务与低成本场景的工程实践。

入选理由:Claude Opus 5.5适用于复杂工程任务,Sonnet 5.5提供更快更低成本方案

精选文章#Antigravity#Claude#模型#工程实践#AI英文
Muse Spark 1.3 & Gemini 3.8 Flash: Gemini has leveled up BIG TIME!

Muse Spark 1.3 & Gemini 3.8 Flash: Gemini has leveled up BIG TIME!

AICodeKing2739 字 (约 11 分钟)
85

Muse Spark 1.3在Kingbench 3测试中表现显著提升,Gemini 3.8 Flash相较3.5版本有明显进步,两者均已在Verdant 2平台上线。

入选理由:Muse Spark 1.2在Kingbench 3测试中从60%提升至76.25%

精选视频#AI模型#性能测试#Kingbench#Meta#Google英文
Google DeepMind Blog 图标

Introducing Gemini 3.8 Flash and 3.8 Flash Cyber

Google DeepMind Blog1218 字 (约 5 分钟)
85

Google发布Gemini 3.8 Flash和3.8 Flash Cyber,推理与编码能力提升,价格保持0.75美元/百万输入令牌,网络安全模型通过Fairwind计划提供。

入选理由:Gemini 3.8 Flash在DeepSWE v1.1基准测试中超越多数大模型,成本仅为前者的几分之一。

精选文章#Gemini#AI模型#网络安全#DeepMind英文
Hacker News Best 图标

Gemini 3.8 Flash

Hacker News Best1183 字 (约 5 分钟)
75

Gemini 3.8 Flash是基于3.7版本的模型迭代,支持多模态输入输出,但技术细节披露有限。

入选理由:Gemini 3.8 Flash支持1M token上下文窗口和64K token输出

精选文章#Gemini#模型#DeepMind#AI英文

📰 仅关于 GLM-5.3-Flash 的文章

Learn to build custom harnesses, folks!

Here is an impressive paper showing the impact of a good cu...

定制化harness(LongHarness)可显著提升长上下文任务性能,GLM-5.3-Flash在OfficeQA Pro V2准确率从4.4%跃升至61.1%。

入选理由:LongHarness通过显式状态管理使GLM-5.3-Flash在OfficeQA Pro V2准确率提升13倍(4.4%→61.1%)

精选推文#LongHarness#长上下文处理#模型优化#OfficeQA#GLM中英混合
刚刚,智谱首个 RSI 成果发布,10 万国产卡用 GLM 造 GLM

智谱GLM团队利用国产AI加速器和Infra Agent,两周内完成GLM-5.3-Flash推理系统优化,性能提升3.2倍。

入选理由:国产AI加速器集群部署仅用两周,吞吐量提升3.2倍

精选文章#AI优化#国产算力#GLM模型#Infra Agent中文
GLM 5.3: Powerful AI Is Becoming Almost Free

GLM 5.3: Powerful AI Is Becoming Almost Free

Two Minute Papers1037 字 (约 5 分钟)
85

GLM 5.3通过线性注意力和索引池技术,使高性能AI模型成本大幅降低。

入选理由:GLM 5.3 Flash参数量200亿,层数减半至46层

精选视频#AI模型#GLM 5.3#线性注意力#索引池中英混合
Together AI Blog 图标

GLM-5.3 vs. GLM-5.3 Flash on DeepSWE: Cost, Coding, and Routing

Together AI Blog2838 字 (约 12 分钟)
85

GLM-5.3 Flash以1/17成本解决15倍任务,首次尝试性能落后5.6%但多次重试后差距缩小至2.6%。

入选理由:GLM-5.3 Flash成本为GLM-5.3的1/17,但每100美元解决任务数是其15倍。

精选文章#模型对比#GLM-5.3#DeepSWE#蒸馏模型英文
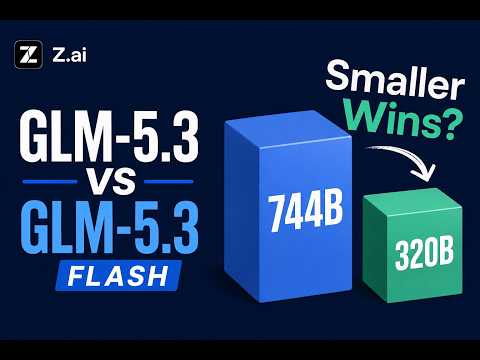
GLM 5.3 Flash vs GLM 5.3: When Cheaper Is the Right Call

GLM 5.3 Flash vs GLM 5.3: When Cheaper Is the Right Call

Sam Witteveen4115 字 (约 17 分钟)
85

GLM 5.3 Flash通过减少参数规模实现更高效的性能,适合对成本敏感的应用场景。

入选理由:GLM 5.3参数量达744亿,激活参数400亿,而Flash版本降至320亿参数和180亿激活参数

精选视频#GLM模型#模型优化#参数效率#AI架构英文

🔗 更多了解

AI 可能会生成不准确的信息,请核实重要内容