agree - most orchestration steps don't need a frontier model for Open SWE we moved model choice int...
通过将模型选择机制从前沿模型迁移至任务执行层,Open SWE实现单任务成本降低64%,证明非前沿模型可胜任多数编排任务。
入选理由:Open SWE通过模型选择迁移使任务成本下降64%
模型对比
DeepSeek-v4.1-Flash 和 Jev 都是 AI 领域的模型。以下是基于 traeai 收录的真实报道数据的全面对比。
模型
也叫:DeepSeek
优化后的长上下文处理模型
12 篇相关报道
产品
也叫:Jev效应
用于自动化和路由管理的工具
20 篇相关报道
12
DeepSeek-v4.1-Flash 相关
0
共同提及
20
Jev 相关
基于 traeai 收录材料自动更新
DeepSeek-v4.1-Flash 与 Jev 的差异,最好从真实材料覆盖、共同语境和高频标签一起判断。traeai 会根据已收录内容持续更新这组对比。
通过将模型选择机制从前沿模型迁移至任务执行层,Open SWE实现单任务成本降低64%,证明非前沿模型可胜任多数编排任务。
入选理由:Open SWE通过模型选择迁移使任务成本下降64%
Tinker API通过降低长上下文任务成本70%,推动强化学习模型实用化,开启post-training新纪元。
入选理由:Tinker API将长上下文任务成本降低70%,显著提升RL模型实用性
OpenAI通过10,000个代理揭示Navier-Stokes方程崩溃,DeepSeek推出V4.1 Flash架构优化长上下文成本。
入选理由:OpenAI使用10,000个代理验证Navier-Stokes方程的局限性
DeepSeek V4.1-Flash在DeepSWE基准测试中以1/15的成本实现与GPT-6 Astra相当的性能,输入token占比达174:1且缓存命中率高达99.6%。
入选理由:输入token数量是输出的174倍,占成本计算的60%。
Bolt Forge平台数据显示,用户更倾向于选择快速模型,GLM 5.3 Flash占63%使用率。
入选理由:GLM 5.3 Flash模型在Bolt Forge平台使用率达63%
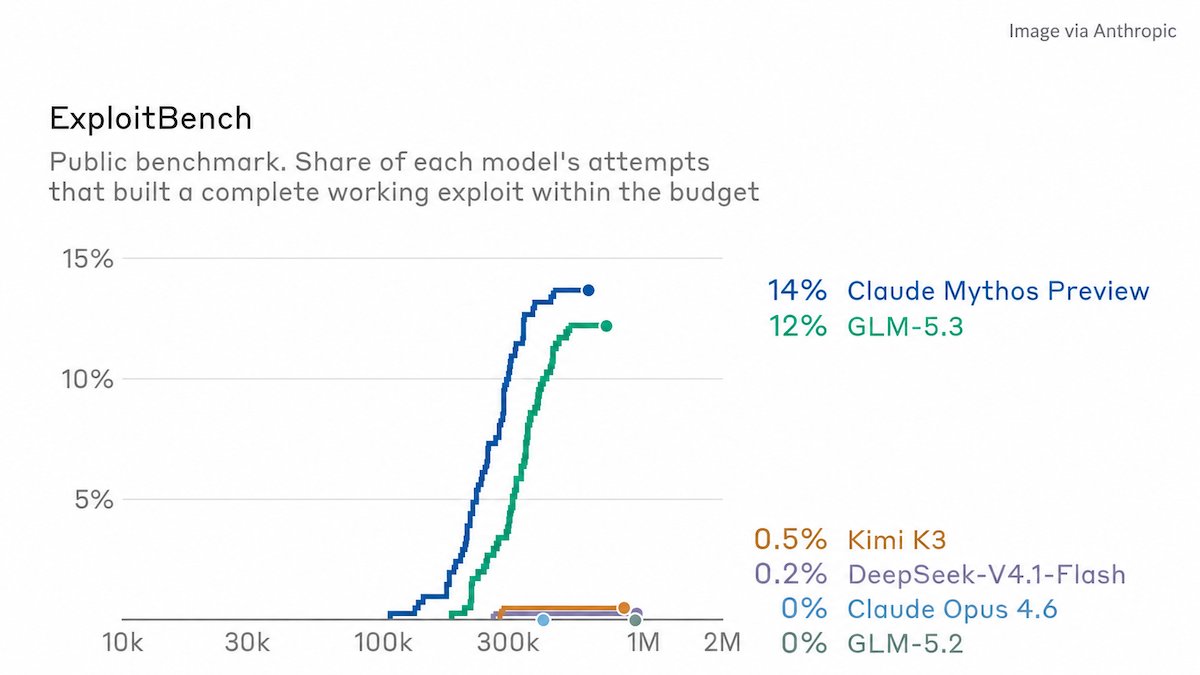
GLM-5.3模型在漏洞利用测试中表现接近Claude Mythos,性能差距仅2%。文章还提及其他AI模型进展与技术动态。
入选理由:GLM-5.3在漏洞利用测试中达到12%,接近Claude Mythos的14%
Fireworks AI宣布DeepSeek V4.1 Flash模型现已支持训练,适用于代理编码和终端自动化,且成本效益高。
入选理由:DeepSeek V4.1 Flash可通过Dedicated Training API和Managed Training进行训练
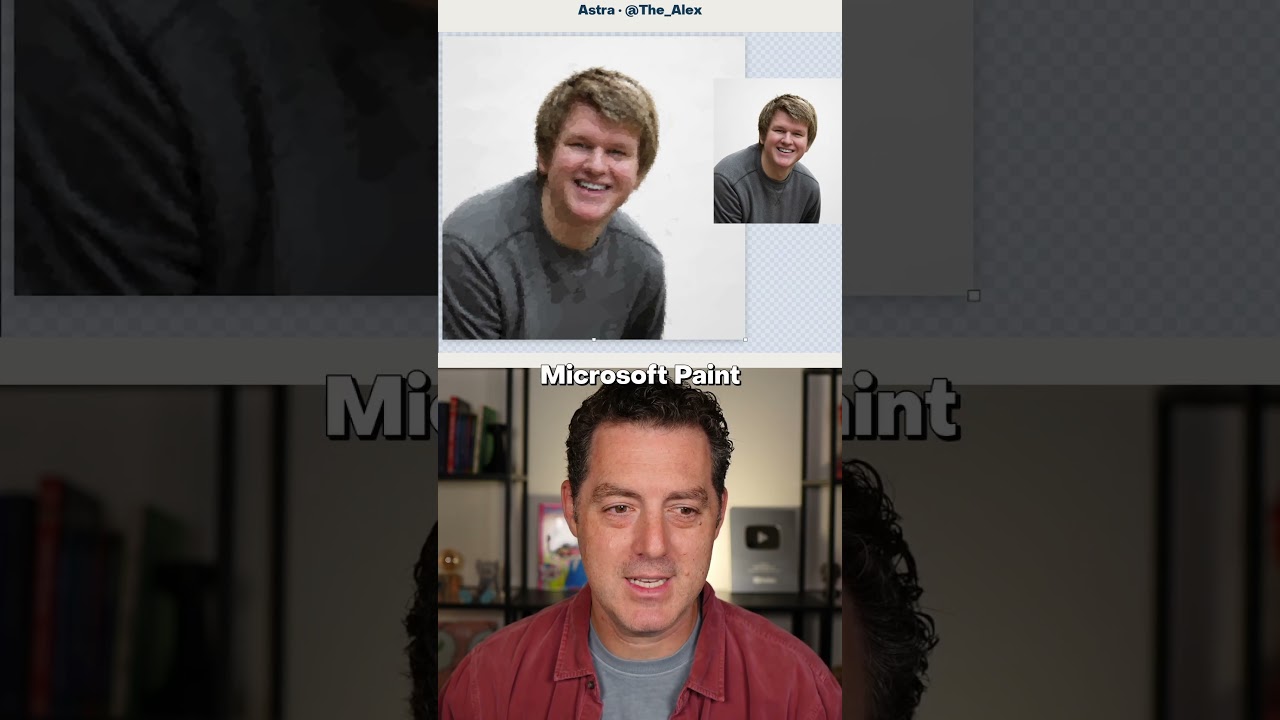
文章展示DeepSeek V4.1 Flash在图像生成任务中的局限性,结果抽象且缺乏细节。
入选理由:DeepSeek V4.1 Flash在处理多层画笔笔触时表现不足
LangChain 0.9版本新增Reactions API,支持在Slack频道中通过启发式、决策模型或自定义逻辑构建加载状态和收据。
入选理由:LangChain 0.9新增Reactions API,支持Slack频道的加载状态和收据构建
Cloudflare发布支持多模态输入的Clef-omni模型,同时提升Clef性能并降低Clef-flash价格,为开发者提供更强大的AI决策工具。
入选理由:Clef-omni支持音频、视频、图像和文本四类输入模态
轨迹标注需多维评估而非单一判断,Edith-1模型以1/274成本超越Sonnet-5.5,LangSmith框架实现难度与正确性分离评估。
入选理由:轨迹标注需同时评估难度与正确性两个维度
Jev模型通过强化学习和校准决策,提升AI在软件中的可靠性和实用性,挑战传统LLM方法。
入选理由:Jev采用强化学习从校准决策(RLCD)提升模型可靠性
Jev作为决策引擎展现低成本高效率优势,通过结构化输出和分层分类实现多场景应用,成本仅为传统LLM的四分之一。
入选理由:Jev将决策成本降至每调用0.03美元,23次开发运行仅花费0.73美元
Jev模型与HeyGen MCP结合,可在毫秒级筛选高价值leads并生成视频,成本降低至千分之一美分。
入选理由:Jev模型判断leads需0.001美分/次,耗时毫秒级
Jev是TypeSafe AI的新型决策模型,通过类型安全的结构化输出实现低成本高效分类,已成功应用于PR分类、Gmail处理等场景,单次调用成本仅4美分。
入选理由:Jev返回类型安全的结构化值(选择/评分/概率),成本为4美分/百万输入标记
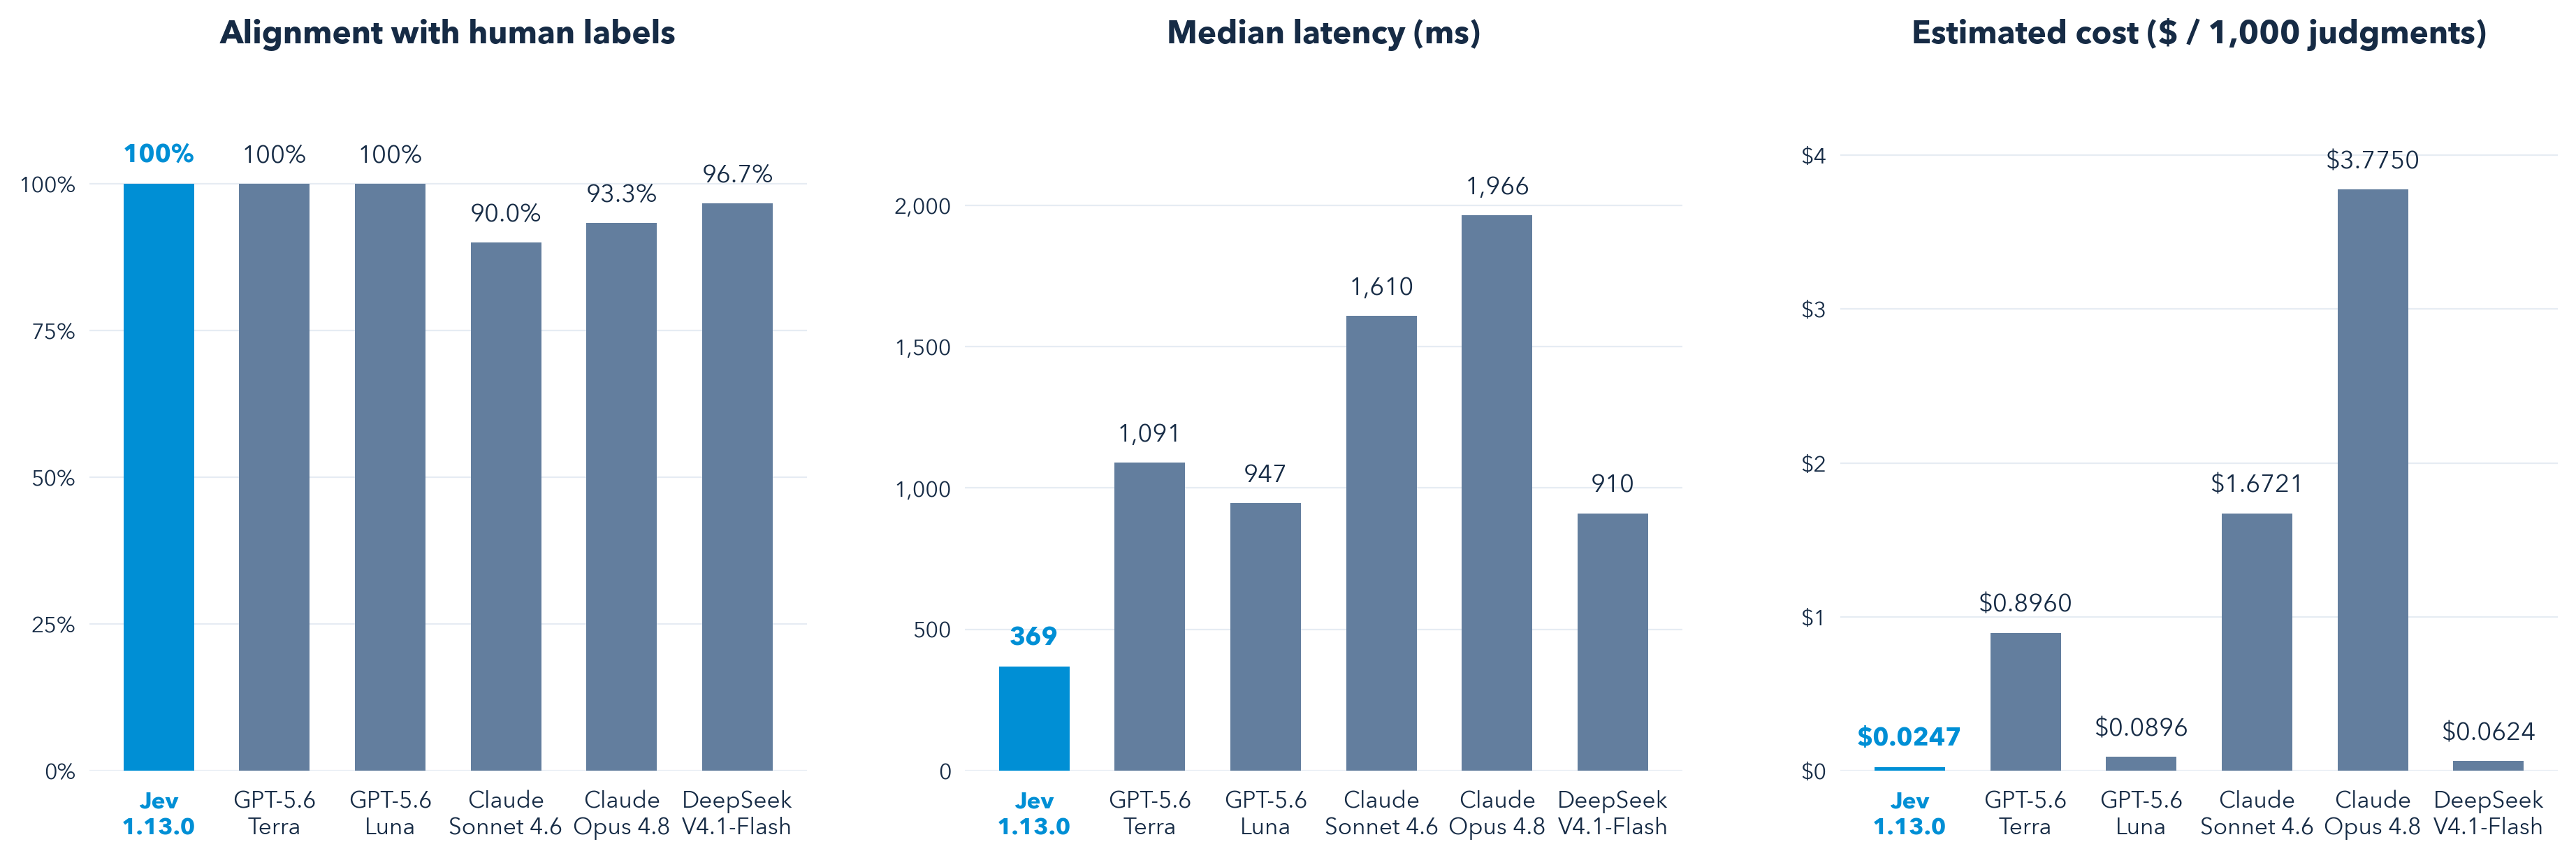
Jev通过结构化输出实现更低延迟和成本,但无法替代LLM judge的解释能力,在技术问答评估中表现优异。
入选理由:Jev的结构化输出使成本降至$0.042/百万输入token,比传统LLM低50%以上